6.3 服务器部署基础
6.3 服务器部署基础
本节摘要:部署是把"我电脑上能跑"变成"互联网能访问"的全过程。本节讲清三个角色——WSGI 协议是通用插座,Gunicorn 是生产级插头,Nginx 是守门人——然后走一遍完整上线流程:购置云服务器、复刻环境、进程守护、域名解析。6.3 与 6.4 是两条通往同一点的路:本节裸机部署理解原理,下一节容器化追求一键复刻。
读完这节能做什么
阅读完本节,你应当能够:
- 说出开发服务器不能上线的三个原因
- 解释 WSGI、Gunicorn、Nginx 三者的分工
- 完成"服务器购机到服务常驻"的完整部署流程
- 用反向代理统一入口,理解静态资源为什么要前置
- 描述云平台部署与裸机部署的对应关系
开发服务器为什么不能上线
Flask 自带的开发服务器好用,但它是玩具:单进程处理请求,一个慢查询就能让所有人排队;没有进程守护,崩了不会自动爬起来;日志和错误处理按"开发者盯屏幕"设计。生产环境的及格线是:多进程扛并发、崩了自动重启、有人守门。这三件事分别由 Gunicorn 和 Nginx 解决。
图 6-3 生产部署的分层架构
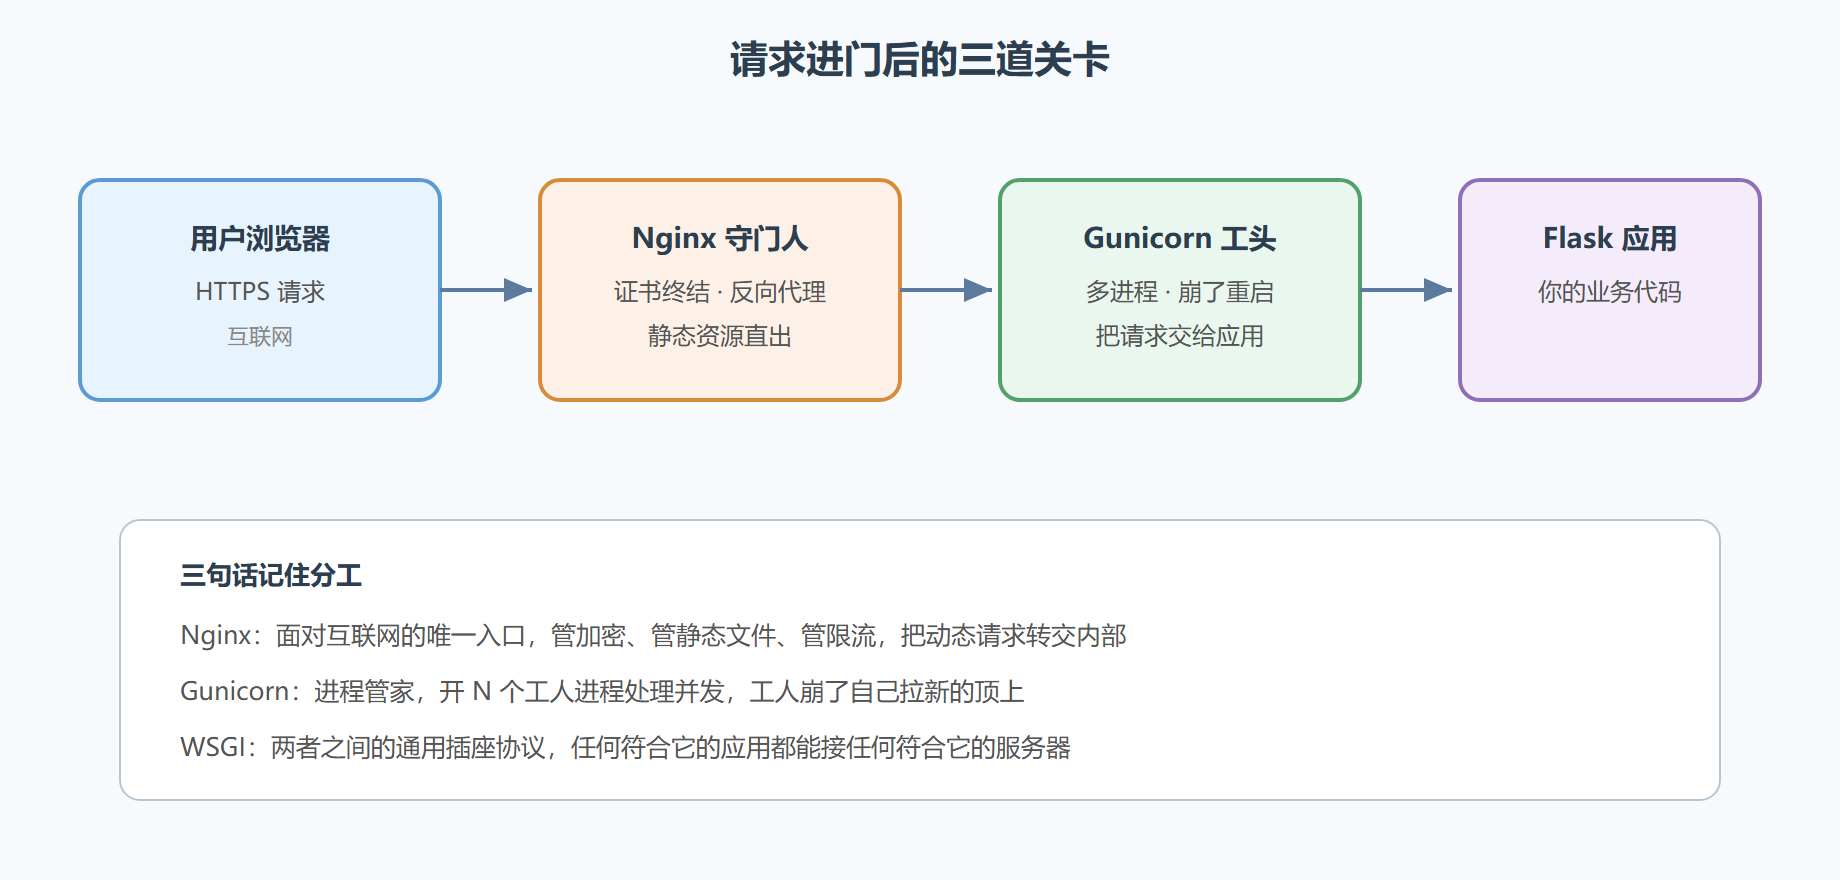
WSGI 值得多说一句:它是 Python Web 应用的标准接口约定。当年每个框架配每家服务器要写专用适配,WSGI 出现后,Flask、Django 写一次,Gunicorn、uWSGI 全都能跑——协议标准化让生态各干各的又无缝咬合,这是工程史上的经典手笔。
完整部署流程:从购机到常驻
**第一步,购置云服务器。**各大云平台(阿里云、腾讯云等)的轻量服务器足够本项目:选个 Linux 系统、拿到公网 IP 与登录方式,价格一杯奶茶。云平台与裸机的对应关系一句话说透:云服务器就是一台在别人机房里、给你远程使用的电脑,本节流程在云上原样适用——所谓"云平台部署",核心就是这一步加安全组放行端口。
**第二步,复刻环境。**登录服务器,拉代码、建虚拟环境、装依赖:
git clone 你的仓库地址 cd ledger python3 -m venv .venv .venv/bin/pip install -r requirements.txt gunicorn
2.4 冻结的依赖清单在此完成使命:一台陌生机器,三条命令回到你熟悉的依赖世界。
第三步,启动 Gunicorn。
.venv/bin/gunicorn "应用包:create_app()" \ --workers 4 --bind 127.0.0.1:8000
四个工人进程监听本机 8000 端口。注意绑定的是本机回环地址——Gunicorn 只对内服务,互联网的流量一律由 Nginx 转入,应用本身不直接暴露。
第四步,配置 Nginx。
server { listen 80; server_name ledger.example.com; location /static/ { root 静态目录; # 静态文件 Nginx 直出,不打扰应用 } location / { proxy_pass 127.0.0.1:8000; # 动态请求转交 Gunicorn proxy_set_header Host $host; } }
**第五步,进程常驻。**终端一关 Gunicorn 就没了,用 systemd(Linux 的服务管家)注册成系统服务:写一个服务描述文件声明启动命令与自动重启,之后 systemctl 一条命令控制启停,机器重启服务自动拉起。第六步,域名与加密:在域名服务商把域名解析到服务器 IP,用 certbot 类工具免费签发 HTTPS 证书,Nginx 配置证书路径——浏览器地址栏的小锁上线。
演练:部署验收清单
按顺序自测:访问域名,页面出现(Nginx 通了);登录、记账、查列表全流程走一遍(Gunicorn 与应用通了);故意重启服务器,服务自动恢复(systemd 生效);连续刷新静态资源页,响应明显快于动态页(静态直出生效)。变式一:把 workers 数从 4 改成 1 和 8 各测一次并发表现,体会进程数与 CPU 核数的关系(经验值约两倍核数加一)。变式二:在应用里人为抛一个异常,去 Nginx 与应用日志分别找到这次报错的记录——生产排错的第一课:日志在哪、怎么看。
易错点清单
- 调试模式忘关上线:--debug 暴露源码与交互式报错页,等于把源码公开
- Gunicorn 直接对公网:绕过 Nginx 的加密与限流,攻击直达应用
- SECRET_KEY 用代码默认值:会话可被伪造,密钥只从环境注入
- 没配自动重启:深夜崩掉到早上,用户流失无人知
一次真实上线:从拉代码到回滚
流程讲过一遍,把它按真实操作的顺序再跑一次,每一步该看什么、出问题往哪退,都写清楚。
第一步,拉代码与装依赖(在部署目录里):
git fetch --tags && git checkout v1.0.0 # 部署固定版本,不要直接拉 main python -m venv .venv && ./.venv/bin/pip install -r requirements.txt ./.venv/bin/python -m pytest tests/ -q # 上线前在目标机器上再跑一遍测试
第二步,配置与数据变更:把环境变量写进服务管理器的配置(或环境文件),执行数据库迁移,迁移前先看一眼备份是否存在。
第三步,以服务方式常驻(systemd 单元文件的核心片段):
[Unit] Description=ledger web service After=network.target [Service] User=www-data WorkingDirectory=/srv/ledger Environment="LEDGER_SECRET=生产密钥从环境注入" Environment="LEDGER_DB=sqlite:////srv/ledger/data/ledger.db" ExecStart=/srv/ledger/.venv/bin/gunicorn -w 4 -b 127.0.0.1:8000 "app:create_app()" Restart=always RestartSec=3 [Install] WantedBy=multi-user.target
第四步,反向代理与静态资源:Nginx 监听 80/443,把动态请求转发给本机的 8000 端口,静态文件由 Nginx 直接返回——让 Python 进程只处理动态逻辑,静态资源交给更擅长它的组件。
第五步,验证与观察:先看服务状态与端口监听,再访问健康检查接口,然后盯三样东西——进程是否反复重启(看 Restart 计数)、错误日志里有没有新出现的异常、关键接口的响应时间是否异常。
回滚:写好脚本再上线
上线前必须准备好回滚动作,且回滚要快于排查。最省事的回滚是"切回上一个版本":因为部署基于 tag,回滚就是重新指向上一个 tag 并重启服务。
git checkout v0.9.2 # 回到上一个可用版本 sudo systemctl restart ledger # 重启服务
数据库迁移是回滚的难点:代码能回退,已经改过的表结构回不去。因此有一条铁律——迁移分成两个阶段做:先做向后兼容的变更(加列、加表,不删不改),等新版本稳定运行一段时间,再在后续版本里清理旧结构。这样任何时点回退代码,都不会因为结构不匹配而崩。
| 上线检查项 | 不通过时怎么办 |
|---|---|
| 测试在目标机器上全绿 | 不通过则不上线,先修环境差异 |
| 配置与密钥来自环境而非代码 | 发现硬编码立即停止,回退到配置分离 |
| 数据库已备份且备份可恢复 | 无备份先补备份,宁可延后上线 |
| 回滚步骤已写成脚本并验证过 | 没有脚本先写脚本,别赌不会出问题 |
| 监控与日志能反映关键指标 | 看不到状态时不要上线,等于盲飞 |
最后一条经验:发布窗口要选在你还清醒的时候。深夜上线是事故率最高的选择——疲劳会让人跳过检查项,而恰恰在深夜没有同事可以请教。
本节要点回顾
- 开发服务器三不:不扛并发、不自动重启、不设防,生产必须换装
- WSGI 是标准插座,Gunicorn 是进程管家,Nginx 是唯一入口
- 六步上线:购机、复刻环境、Gunicorn、Nginx、systemd 常驻、域名加密
- 静态资源前置直出,动态请求才进应用
- 云服务器即远程主机,本节流程原样适用各大云平台
手工部署走通了,但每换一台服务器都要重演一遍?下一节 Docker,把整套服务打成一只集装箱。