5.2 ORM 与 SQLAlchemy
5.2 ORM 与 SQLAlchemy
本节摘要:ORM 把数据库表映射成 Python 类、把行映射成对象,业务代码从此用"对象与属性"说话,SQL 退到幕后。本节用 SQLAlchemy 给轻记账定义 Record 模型,把 Ledger 类的存储后端从 JSON 文件切换到 SQLite——对外接口一行不改,测试绿灯证明行为未变。第三章"封装是给未来留的活口"这句话,在本节兑现。
先把目标钉住
阅读完本节,你应当能够:
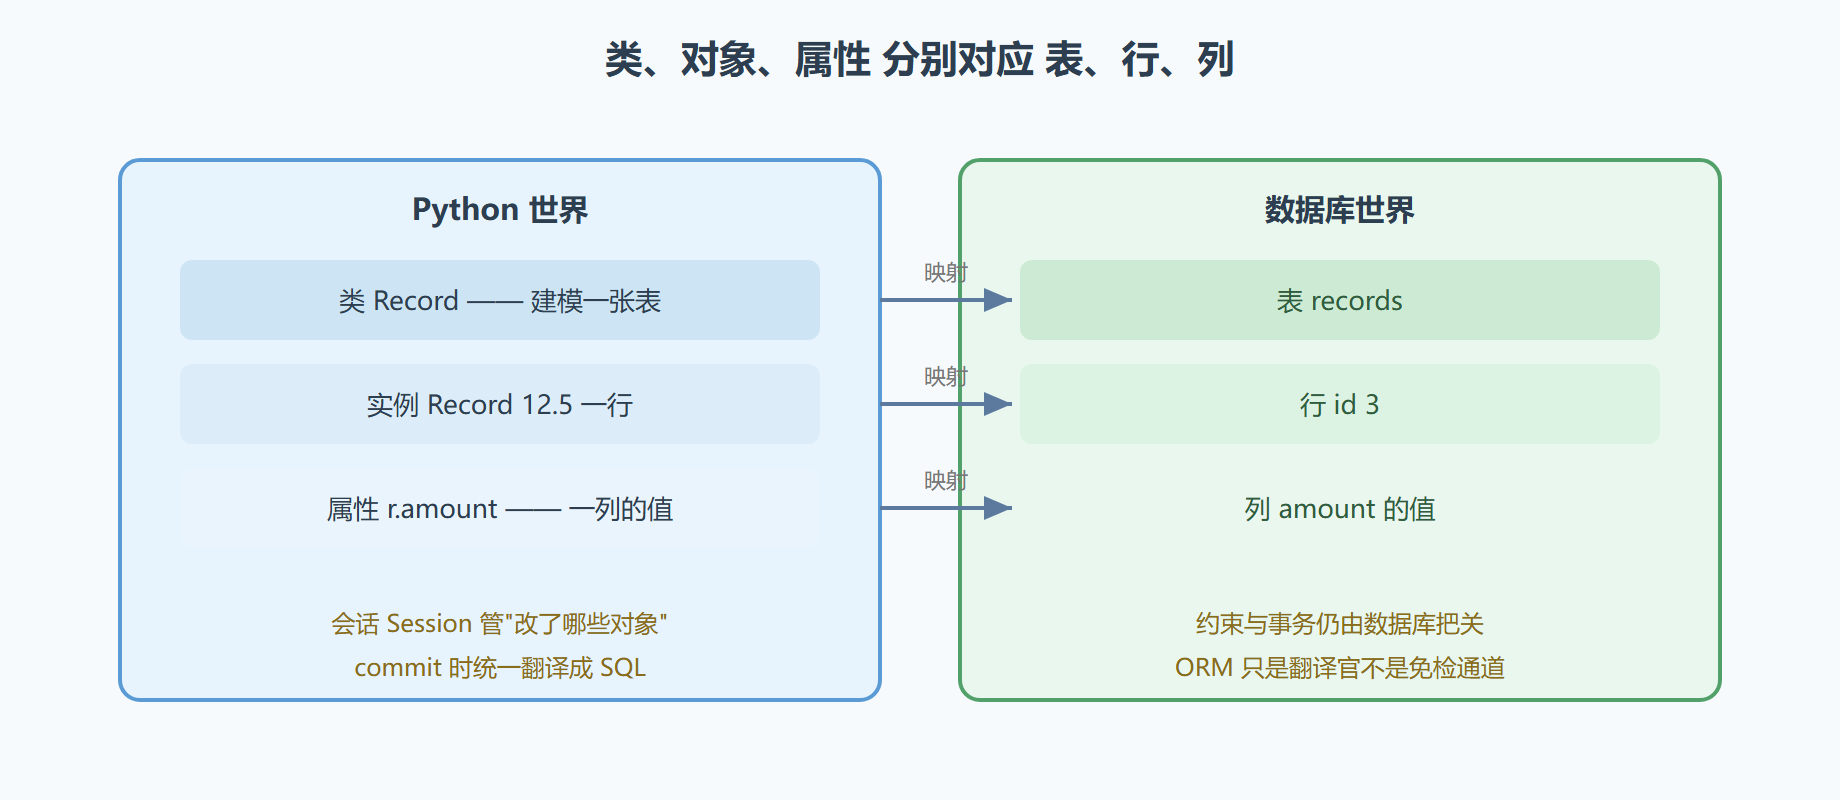
- 解释 ORM 的映射规则:类对表、对象对行、属性对列
- 用 SQLAlchemy 定义模型类并自动建表
- 完成增删改查的对象式写法,说出它与传统 SQL 写法的利弊
- 在不改动 Ledger 对外接口的前提下更换存储后端
- 认识 N+1 查询问题及其解法
ORM 的取舍:先讲清楚再动手
要不要用 ORM,业内吵了二十年。好处直白:业务代码不用满屏 SQL 字符串,类型检查与重构工具能认出你的"字段"(那只是类属性),换数据库只需换方言参数。代价也要认:复杂查询(多表关联加窗口函数)写 ORM 表达式反而绕,而且 ORM 会让人逐渐丧失手写 SQL 的能力——这就是为什么上一节先让你裸写 SQL:知其底层,再用封装。本书立场:日常增删改查用 ORM,复杂统计该写 SQL 就写 SQL(SQLAlchemy 也直接支持原文 SQL),两把刀各切各的菜。
图 5-2 ORM 的三层映射
定义模型:账目表变成一个类
2.4 装的 sqlalchemy 这就上场。建一个模型模块:
from datetime import date from sqlalchemy import create_engine, String, Float, ForeignKey, select from sqlalchemy.orm import ( DeclarativeBase, Mapped, mapped_column, Session, relationship, ) class Base(DeclarativeBase): pass class User(Base): __tablename__ = "users" id: Mapped[int] = mapped_column(primary_key=True) username: Mapped[str] = mapped_column(String(50), unique=True) records: Mapped[list["Record"]] = relationship(back_populates="user") class Record(Base): __tablename__ = "records" id: Mapped[int] = mapped_column(primary_key=True) item: Mapped[str] = mapped_column(String(100)) amount: Mapped[float] = mapped_column(Float) date: Mapped[str] = mapped_column(String(10), index=True) user_id: Mapped[int] = mapped_column(ForeignKey("users.id")) user: Mapped["User"] = relationship(back_populates="records") # 建库建表(开发期一句话搞定;正式项目用迁移工具管理结构变更) engine = create_engine("sqlite:///ledger.db") Base.metadata.create_all(engine)
读法与 5.1 的建表 SQL 逐项对上:Mapped 标注管类型,primary_key 管主键,ForeignKey 管外键,unique 管唯一,index=True 给 date 建索引——按月查询从全表扫描变成快速定位,大数据量下天壤之别。relationship 是对象层的桥:拿到一个 User,直接访问它的 records 属性就能列出全部账目,JOIN 已在幕后完成。
增删改查的对象式写法
def add_record(item, amount, user_id): with Session(engine) as session: record = Record(item=item, amount=amount, date=date.today().isoformat(), user_id=user_id) session.add(record) # 进入会话的待写清单 session.commit() # 落盘,id 自动回填 return record.id def month_records(month, user_id): with Session(engine) as session: stmt = select(Record).where( Record.date.like(f"{month}%"), Record.user_id == user_id, ).order_by(Record.date.desc()) return list(session.scalars(stmt)) def delete_record(record_id): with Session(engine) as session: record = session.get(Record, record_id) if record: session.delete(record) session.commit()
与裸 SQL 对照着看:session.add 对应 INSERT,select 加 where 对应 SELECT,session.delete 对应 DELETE。会话是工作单元:期间的所有改动攒在一起,commit 时一次提交——事务语义被 ORM 原样继承,5.1 的知识没有作废,只是换了语法。
演练:Ledger 换心脏,接口不动
改造 Ledger 类,把内部实现从 JSON 文件换成 ORM,对外方法签名原封不动:
class Ledger: def __init__(self, engine): self.engine = engine def add_record(self, item, amount, user_id=1): if amount <= 0: raise ValueError("金额必须为正") with Session(self.engine) as session: session.add(Record(item=item, amount=amount, date=date.today().isoformat(), user_id=user_id)) session.commit() def all(self, user_id=1): with Session(self.engine) as session: stmt = select(Record).where(Record.user_id == user_id) return [ {"item": r.item, "amount": r.amount, "date": r.date} for r in session.scalars(stmt) ] # add_record 里金额校验、all() 的返回结构,与 JSON 版完全一致
此时把 3.2 写的测试跑一遍:Ledger 对外行为与 JSON 版一模一样,绿灯。Flask 视图函数也感知不到任何变化。这就是面向接口编程的兑现时刻——封装在第三章给未来留的活口,今天派上了用场。变式一:在 SQLite 连接串里加参数把 SQL 回显打开,观察一次 add_record 实际发出的 INSERT 长什么样。变式二:给 user 的 records 属性写一段访问代码,开启回显后数一数它触发了几条查询——第一千条账目的用户页会触发多少条?这就是下一部分的 N+1 问题。
N+1:ORM 最著名的性能陷阱
列表页显示每笔账及其主人,朴素写法是查一遍账目(1 条),循环里逐条查主人(N 条)——一共 N+1 条查询,页面越热门数据库越叫苦。解法是预加载:
from sqlalchemy.orm import selectinload stmt = select(Record).options(selectinload(Record.user)) # 两条查询搞定:一次取全部账目,一次取涉及的全部用户,内存中配对
调优的通用心法:打开 SQL 回显,数清楚一个页面发了几条查询——看不见的查询才是最危险的查询。
易错点清单
- create_all 管增量不管变更:已存在的表不会加新列,结构演进要用迁移工具
- session 用完不关:用 with 语句管理会话,连接泄漏会拖垮服务
- 在会话外访问懒加载属性:对象脱离会话后再取关联数据报错,取全了再出去
- 对 ORM 期望过高:复杂统计别硬写表达式,原文 SQL 是合法且正当的选择
本节要点回顾
- 三层映射:类对表、对象对行、属性对列,会话是事务的工作单元
- 模型类即建表语句:类型、主键、外键、索引全部声明式
- Ledger 无缝换心脏:对外接口不变,测试绿灯,封装的活口兑现
- N+1 用预加载解决:打开回显数查询,是 ORM 时代的基本功
- ORM 与 SQL 并存:日常用对象,复杂用原文,别教条
数据住进了正房。下一节给这批数据修一条标准的"对外走廊"——REST 风格的 API。