6.2 全栈项目结构与协作
6.2 全栈项目结构与协作
本节摘要:功能越加越多,根目录里散落的脚本终于乱到看不下去了。本节按工程惯例给轻记账"搬家":应用代码进包、配置进环境变量、测试进独立目录、密钥绝不进 Git。结构不是洁癖,是协作的语言——目录形状一变,"哪类逻辑在哪找"就成了全队的共同知识。
先把目标钉住
阅读完本节,你应当能够:
- 按惯例组织全栈项目的目录结构
- 把配置从代码中剥离,用环境变量与环境文件管理
- 解释"配置分离"在安全与部署两个维度上的意义
- 理解多人协作下的分支约定与提交纪律
乱从何来
诊断一下现在的根目录:主脚本、账目模型、测试、静态页、JSON 文件、CSV 导出……十几个文件平铺。三个后果逐渐显现:找东西靠记忆,新人上手要先通读全部文件;测试与生产纠缠,测试脚本 import 了主脚本,顺带执行了里面的启动代码;配置写死在代码里,数据库路径、密钥、端口全埋在源码中,换台机器就报错。治法只有一个:按职责分区。
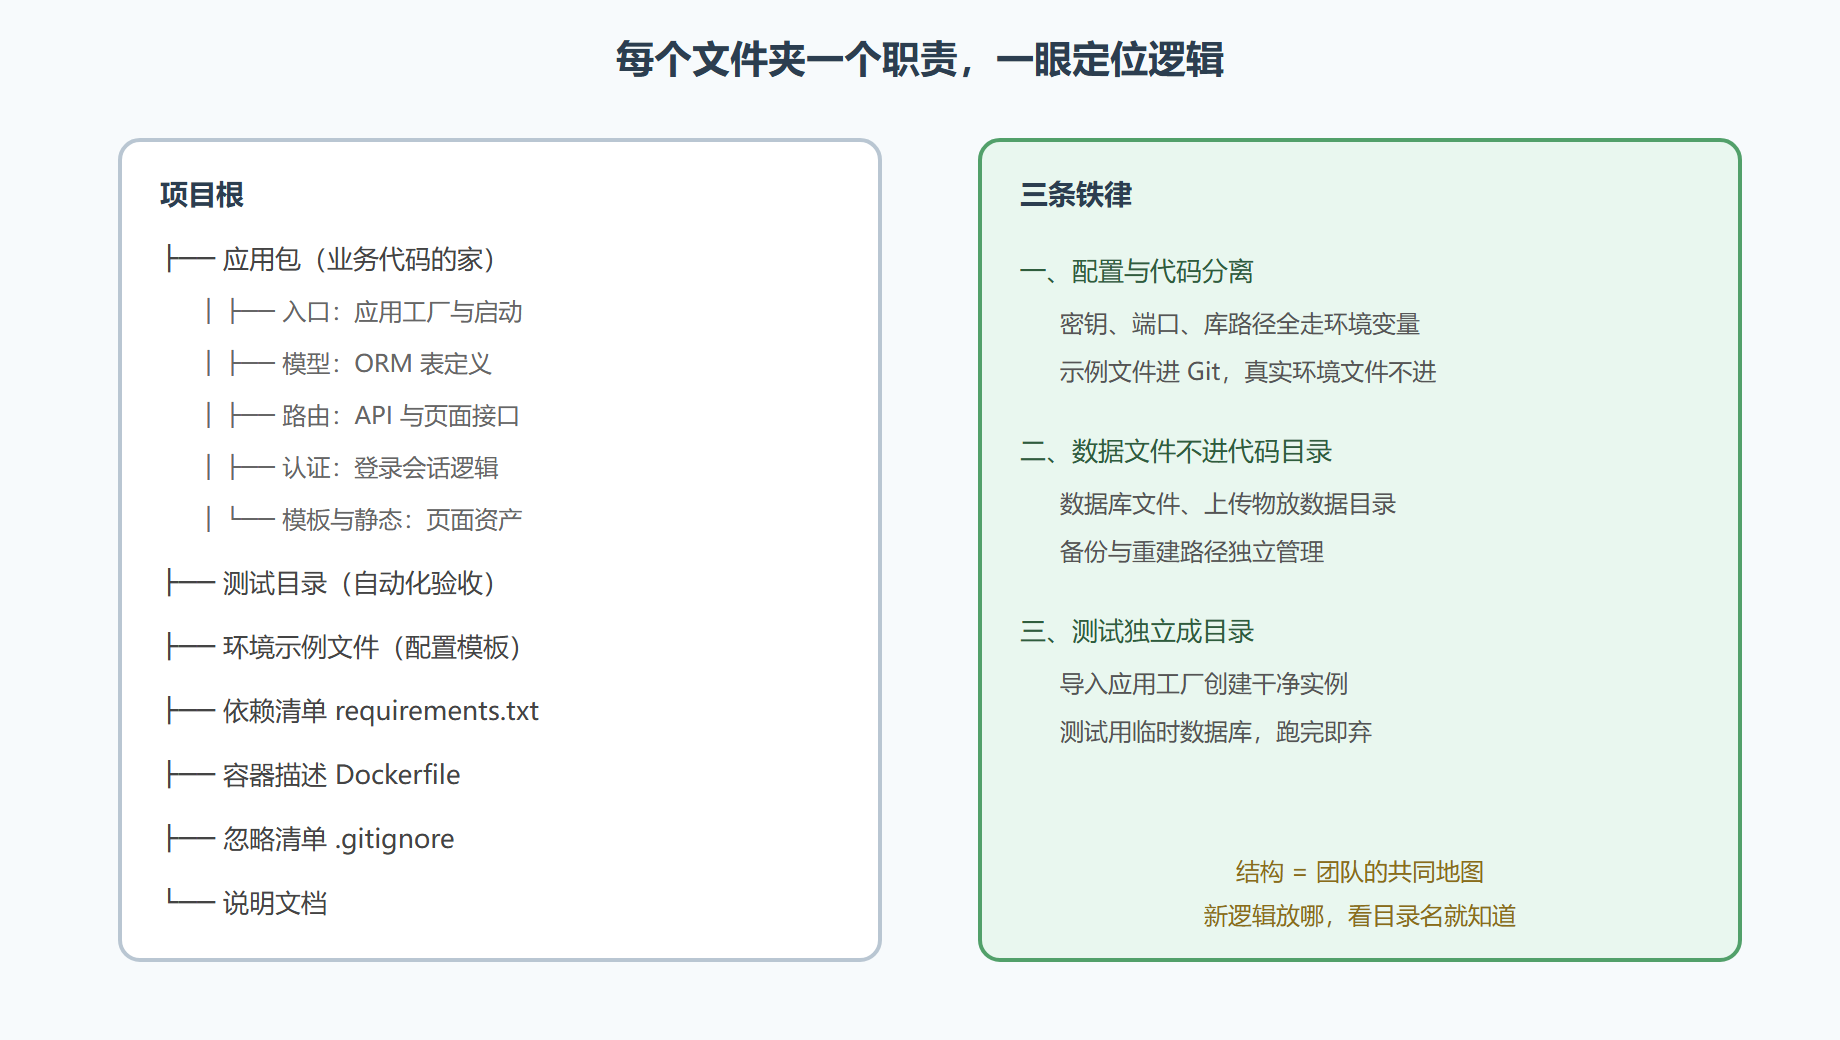
图 6-2 轻记账 v1.0 的目录结构
配置分离:环境变量与环境文件
核心原则一句话:同一份代码,不同环境只换配置。开发时连本地库、开调试;生产时连真库、关调试——差别全在环境变量里:
import os DEBUG = os.environ.get("LEDGER_DEBUG", "0") == "1" DATABASE_URL = os.environ.get("LEDGER_DB", "sqlite:///ledger.db") SECRET_KEY = os.environ["LEDGER_SECRET"] # 密钥只从环境读,代码里没有
本地开发时把变量写进环境文件(惯例命名 .env),内容形如:
LEDGER_DEBUG=1 LEDGER_DB=sqlite:///ledger_dev.db LEDGER_SECRET=开发期随便编的密钥
配合加载库把它读进进程环境。.env 绝不进 Git(写进忽略清单),仓库里只放一个 .env.example 当模板——别人克隆项目后照着示例填自己的值。这一套在 6.4 的容器化里再显威力:容器注入环境变量,同一镜像跑遍开发与生产。
应用工厂:测试友好的入口
顺手做一个重构:把"创建应用"封装成函数,而不是模块加载时的副作用:
def create_app(config=None): app = Flask(__name__) app.config.from_mapping(SECRET_KEY=os.environ["LEDGER_SECRET"]) if config: app.config.update(config) # 测试可覆盖任意配置 register_routes(app) return app # 测试里: # app = create_app({"DATABASE_URL": "sqlite:///:memory:"})
这是 3.1 封装思想在应用层的重演:把"组装"与"运行"分开,测试才能创建一个配置可注入、数据库在内存里的干净实例——6.5 章末上线前跑的每一遍回归测试都靠它。
协作纪律:分支约定与提交礼貌
单人项目也建议养成团队纪律,因为它是肌肉记忆:main 分支永远可部署;新功能开分支,命名带前缀(feature 导出报表、fix 金额精度);一个提交一件事,信息写清动机;合并前跑一遍测试。多人时再加一条:代码评审——别人读你的 PR,读的是思路不是格式,格式交给自动格式化工具。这些纪律在第 3 章都学过原理,此处只是让它们长成习惯。
演练:搬家验收
按图 6-2 把现有文件归位:业务代码进应用包、测试进独立目录、写 .env 与示例文件、更新忽略清单。验收三问:新装机器上照着说明文档加 .env 能否十分钟跑起来?跑测试是否零配置一键完成?Git 历史里 grep 不到任何密钥?三问全过,搬家合格。变式一:把配置封装成一个配置类,开发、测试、生产各一个实例,体会"十二要素应用"的配置原则。变式二:模拟一次协作——自己开分支加功能,合并回 main 前故意跑挂一个测试,体验"绿灯才许合并"的闸门价值。
易错点清单
- .env 误提交:密钥进了 Git 历史,删文件也没用(历史还在),第一时间换密钥
- 测试 import 触发启动代码:入口与逻辑分离,启动语句只留在真正启动的地方
- 相对路径随工作目录漂移:路径一律基于应用包定位,别赌当前目录
- 目录结构与文档脱节:加了新模块更新说明,地图失准比没有地图更糟
一份可生长的项目骨架
结构不是越复杂越好,而是"当前规模够用、下一个规模不推倒重来"。轻记账在这个阶段的目录形态如下,每一层都有它存在的理由:
ledger/ app/ # 应用包:只有业务逻辑,不关心怎么启动 __init__.py # 应用工厂 create_app 在这里 models.py # 数据模型:Ledger、Record routes.py # 路由:URL 到函数的映射 services.py # 业务编排:跨模型的操作放这里 tests/ # 测试与业务代码平级,一比一对应 test_models.py test_routes.py migrations/ # 数据库变更脚本,可重放 requirements.txt # 依赖锁定版本 .env.example # 配置模板(进仓库) .gitignore # 忽略清单:.env、缓存、虚拟环境 README.md # 十分钟跑起来的说明
三条经验值得单独说。其一,应用包与入口分离:app/ 里没有"启动服务器"的语句,启动只发生在 wsgi.py 或命令行入口里。这样测试才能安全地 import 业务代码而不触发监听端口。其二,测试与源码平级而非藏在深处:找某个模块的测试时,路径上一眼能看到。其三,migrations 目录从第一次改表结构起就要有——靠"手动在数据库里改一下"攒下的结构差异,迟早要在某次迁移里还债。
什么时候该把 app/ 再拆成多个子包?有三个信号:routes.py 超过三百行(路由该按资源分组)、出现跨模型的复杂编排(该抽 services 层)、两个模块循环 import(说明职责边界画错了,要重新切分)。没到这三个信号就先别拆——过早拆分的目录树比平铺更难读。
协作约定的落地清单
结构之外还有一层"看不见的结构"——团队约定。下面这张清单可以直接抄进项目说明文档。
| 约定 | 具体内容 | 为什么 |
|---|---|---|
| 分支命名 | feature/报表导出、fix/金额精度、chore/依赖升级 | 看分支名就知道在做什么,便于自动化 |
| 提交粒度 | 一个提交一件事,含测试 | 出问题时定位与回滚都精准 |
| 提交信息 | 首行动词开头、说明动机而非改了哪行 | 三个月后你自己看得懂 |
| 合并条件 | 测试全绿 + 至少一人评审通过 | 闸门前置,避免事后返工 |
| 主干状态 | main 永远可部署 | 任何时刻都能发版,发布不再可怕 |
| 格式与风格 | 交给自动格式化工具,评审不讨论格式 | 把评审精力留给设计与逻辑 |
这张表里最容易被跳过的是"提交信息写动机"。改动本身在 diff 里,动机只在你的脑子里——把它写下来,是成本最低、回报最高的协作习惯。
本节要点回顾
- 按职责分区:应用包、测试、配置模板、清单、容器描述各就各位
- 配置走环境变量:.env 进本地、示例进仓库、密钥永不进 Git
- 应用工厂让测试可注入配置,组装与运行分离
- 分支与提交纪律是肌肉记忆:main 可部署、一事一提交、绿灯才合并
- 结构是共同地图:新人看目录名就能定位逻辑
代码列队完毕。下一节正式出门上线——WSGI、Gunicorn、Nginx 三件套,把服务从笔记本搬上服务器。