第1章 · 环境搭建与 Python 数据科学基础
第 1 章 · 环境搭建与 Python 数据科学基础
章节摘要:数据科学的第一步不是写代码,而是把"跑代码的地方"弄对。本章从安装 Anaconda 讲起,教你用虚拟环境隔离项目依赖,再把 Jupyter 这个交互式工作台用熟,最后用一节快速捡回 Python 的数据结构与控制流基础。学完本章,你的电脑就是一台随时能开工的数据分析工作站。
阅读收获
阅读完本章,你应当能够:
- 独立完成 Anaconda 的安装与验证,理解 conda 与 pip 的分工
- 创建、激活、导出虚拟环境,解释"为什么每个项目都要独立环境"
- 启动 Jupyter,会使用单元格、快捷键与 Magic 命令
- 复述 Python 常用数据类型、容器结构与控制流的差异和适用场景
- 说清 Jupyter、脚本、IDE 三种工作方式各自的适用场合
核心概念速览
一句话记住本章:环境是地基,Python 是砖,Jupyter 是脚手架——先把地基打牢,后面盖楼才不塌。
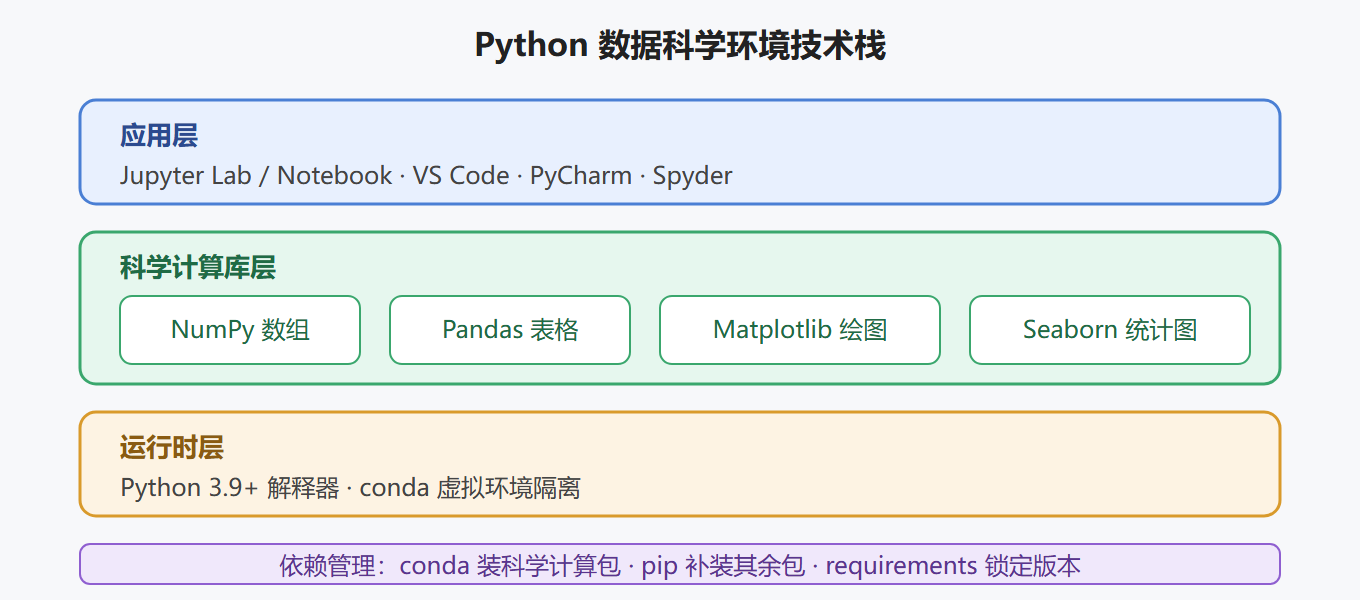
数据科学环境技术栈全景
子章节导航
1.1 搭建 Python 数据科学环境
从零开始:下载安装 Anaconda、验证安装、创建并激活虚拟环境、安装常用科学计算库。解决"装完库却不认识"的经典问题。
1.2 Jupyter 与数据科学开发工具链
认识 Jupyter Notebook/Lab 的单元格交互模型、快捷键与 Magic 命令,对比脚本、Notebook、IDE 三种工作方式的取舍,并介绍其他常用工具。
子章节之间的逻辑关系
安装 Anaconda ──> 建虚拟环境 ──> 装库 ──> 启动 Jupyter │ Python 语法基础(贯穿始终)
1.1 解决"工具装没装好",1.2 解决"在哪写代码"。两节都建立在 Python 语法基础之上——语法不熟没关系,先会用,第 2 章起在实战中越用越熟。
前置知识与后续延伸
- 前置:会操作电脑即可,不需要任何编程基础;没装过 Python 反而更好,省得清理旧环境
- 为后续铺垫:本章装好的 numpy、pandas、matplotlib、seaborn 正是第 2、3、5 章的主角;虚拟环境的习惯贯穿全书所有代码实验
实战建议与常见坑
本章动手量最大,也最容易"卡在第一步"。三个高频现场提前打预防针:
- 装完库却 import 不到:九成是没激活环境。终端提示符出现
(ds)再敲import numpy,否则它用的是系统 Python - conda 下载慢到怀疑人生:先配清华镜像再装包,省下的时间足够写完第 2 章的代码
- Jupyter 启动报"内核未连接":多半是环境里没装 jupyter,回到 1.1 补装,或换个干净环境重来
一个务实的做法:第一次装环境时,把 1.1 的全部命令按顺序抄一遍。抄完你不但有了能用的环境,还顺带记住了这些命令——后面建第二个项目环境时就能凭肌肉记忆操作。
本章做完的验收标准很简单:能在自己的 Jupyter 里运行一段 numpy 代码并看到结果。做到这一点,全书的地基就稳了。
评论区
(0)
U