第2章 · NumPy 科学计算
第 2 章 · NumPy 科学计算
章节摘要:NumPy 是整个 Python 数据科学的地基,Pandas、SciPy、Scikit-learn 全都建立在它之上。本章围绕 ndarray 数组展开:先讲清楚这个数据结构为什么快,再依次学会创建数组、按需取值、用向量化运算替代循环,最后掌握形状调整、数组组合与统计计算。学完本章,你处理十万行订单金额数据也能在眨眼之间完成。
本节导读
阅读完本章,你应当能够:
- 解释 ndarray 与 Python 列表在内存布局与速度上的差异
- 用多种方式创建数组:零数组、等差数列、随机数组、全一数组
- 熟练使用基本索引、切片、花式索引与布尔索引取值
- 理解并运用广播机制,写出无循环的向量化代码
- 完成数组重塑、转置、组合与分割,并用聚合函数做统计
核心概念速览
一句话记住本章:能用数组整体运算,就绝不写 for 循环——向量化是 NumPy 性能的秘密,也是 Pandas 里
apply绕不开循环时仍然快的底气。
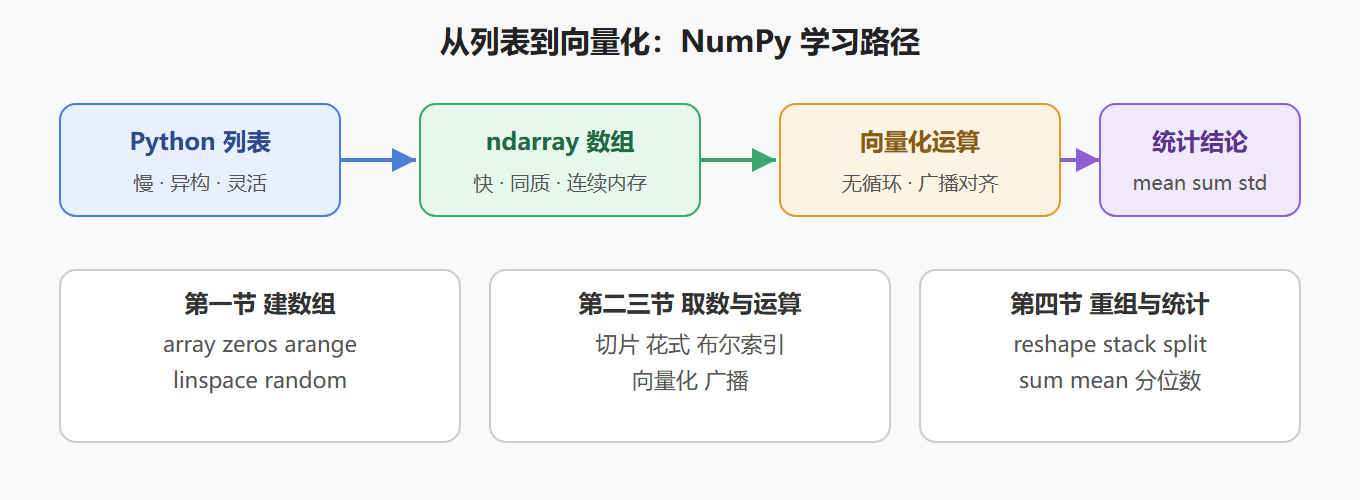
NumPy 学习路径图
子章节导航
2.1 ndarray 核心概念与数组创建
理解 ndarray 的"同质、连续内存"本质,掌握 array、zeros、ones、arange、linspace、random 等创建方式。
2.2 索引切片与高效取值
基本索引、切片、花式索引、布尔索引四种取值方式,以及 reshape、flatten 等形状操作的正确姿势。
2.3 向量化运算与广播机制
用数组整体运算替代 Python 循环,理解广播的维度对齐规则,写出既快又清晰的代码。
2.4 数组重塑组合与统计实战
转置、拼接、分割、聚合统计,配合贯穿案例算订单金额的多种统计量,完成 NumPy 实战收尾。
子章节之间的逻辑关系
创建数组(2.1) → 取值(2.2) → 运算(2.3) → 重组与统计(2.4) │ │ │ 有数据 会取数 算得快 出结论
四节是一条完整的处理链:先造出数据,再取到需要的数据,然后用向量化运算把计算变快,最后通过形状操作与统计把结果整理出来。
前置知识与后续延伸
- 前置:第 1 章装好的环境;Python 列表、循环的基本概念(不熟也没关系,2.2、2.3 会对照着讲)
- 为后续铺垫:Pandas 的 Series 与 DataFrame 底层就是 NumPy 数组(第 3 章);本章的向量化思维在数据清洗(第 4 章)与性能优化(第 6 章)中反复使用
实战建议与常见坑
学 NumPy 最忌讳"背 API"。它的核心就三件事:建数组、取数、运算,其余都是这三件的组合。建议按下面顺序练:
- 先跑 2.1 的创建代码:把 array、zeros、arange、linspace、random 五种创建方式各敲一遍,输出看一眼
- 再练 2.2 的取数:拿同一个数组,用基本索引、切片、花式、布尔四种方式各取一次,对比结果
- 最后攻 2.3 的广播:这是全章最难的十行代码,卡住正常——把 shape 打印出来,一行一行对广播规则
三个高频坑提前标记:切片是视图(改切片会改原数组)、布尔条件要用与符号加括号、reshape 前后元素总数必须一致。踩到任何一个,回对应小节看排查说明。
本章验收标准:能不查资料写出"对数组求和、按条件筛选、算均值与分位数"的代码,且知道切片修改会传染原数组。
评论区
(0)
U