3.2 数据过滤排序分页:契约的查询面
3.2 数据过滤、排序与分页:契约的查询面
本节摘要:集合接口的真正难点在"怎么查得动"。过滤器放查询参数、排序给方向、分页定边界,三者合起来设计成一份统一语法。本节给出过滤/排序/分页的规范写法,剖析 offset 分页的"漂移"痛点与 cursor 分页的解法,并处理大字段集与返回结构设计。
学习目标
阅读完本节,你应当能够:
- 设计跨资源的统一过滤、排序、分页查询语法。
- 说清 offset 分页的缺陷与 cursor 分页的优势。
- 处理过大大字段集与不固定排序键的问题。
- 为列表接口设计稳定的返回壳与分页元数据。
集合接口的查询问题打哪儿来
先看一个反面:GET /users 不做任何过滤分页,把整个用户表全量返回。数据少时没事,到了十万用户就灾难——响应巨大、网络拥塞、客户端渲染卡死。查询面存在的意义,就是把这扇"越开越大的门"收敛成"客户端按需取一小块"的窗户。
查询面三件套——过滤、排序、分页——要作为一份统一语法设计,而不是每个接口各写各的。
二、过滤:放查询参数,别造查询端点
上一章 URI 节已埋了伏笔:过滤是"从哪个角度看这份资源",放查询参数最合适。一套可复用的写法:
- 等值过滤:
GET /users?role=admin - 范围/条件过滤:
GET /orders?createdAfter=2026-01-01&amountGt=100(用GtGteLtLte表达比较) - 多条件组合:
GET /users?role=admin&status=active
关键是这条路走通后,就不需要为"按邮箱查的 users""按状态查的用户"再造 /usersByEmail 之类的查询端点——它们是同一份资源的视角而已。过滤参数语义要清晰一致,才能跨接口复用客户端代码。
三、排序:给方向但别给怪物
排序同样放查询参数:
GET /users?sort=name&order=asc
两个细节要注意:
- 排序键要白名单化:只允许对预定义的、有索引的列排序,避免客户端传任意字段造成服务器扫描或暴露内部结构。
- 不固定的排序键是灾难:
sort=random看似花哨,实则让分页与缓存失去稳定支撑。要随机抽样,走专门的接口语义,而不是混进排序。
offset 与 cursor 的差别用一张并排图解看得最明白:
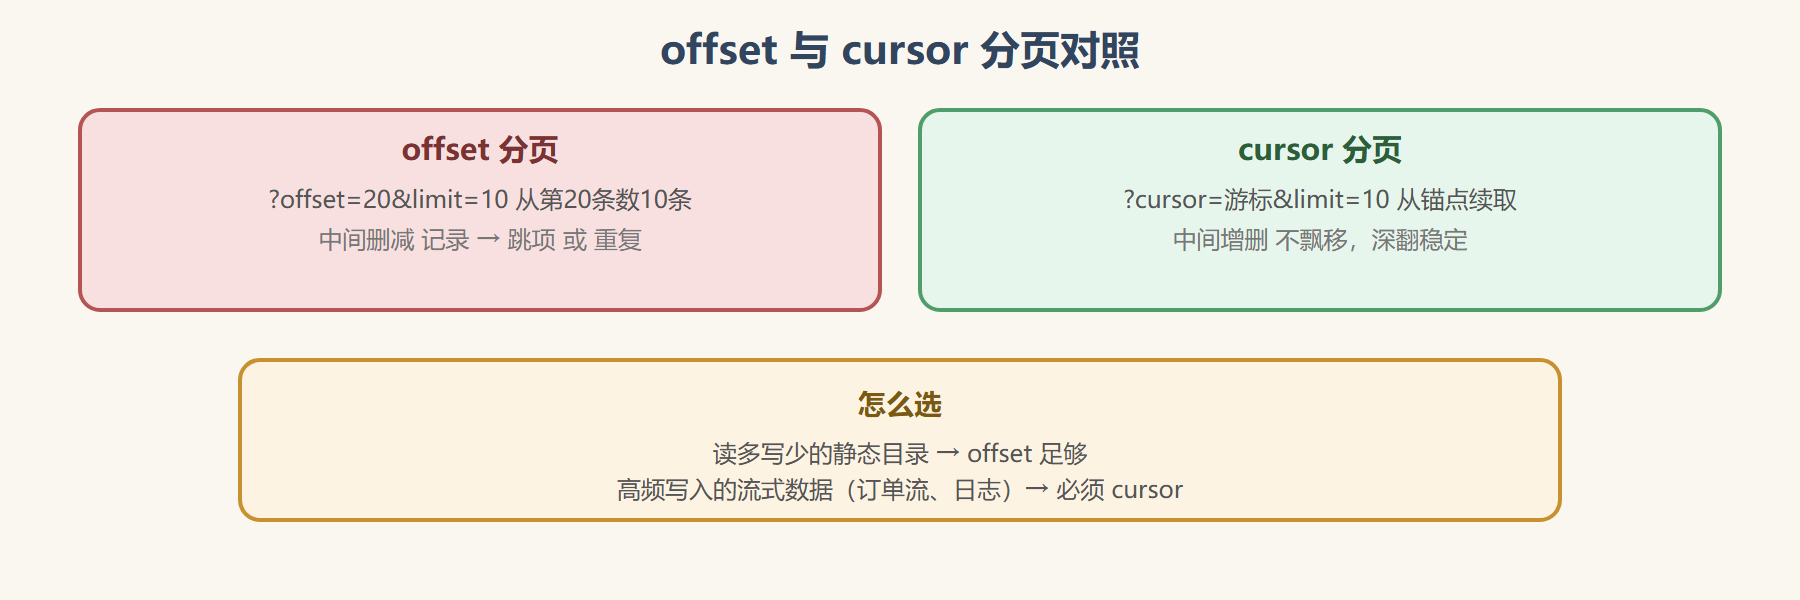
图:offset 与 cursor 分页对照
四、分页:offset 与 cursor 的生死抉择
分页是查询面最常踩坑的地方。两种主流:offset/limit 与 cursor(游标)分页,直接对照:
| 维度 | offset 分页 | cursor 分页 |
|---|---|---|
| 做法 | ?offset=20&limit=10 |
`?cursor=<base64游标> |
| 深层翻页 | 随 offset 增大变慢 | 稳定 |
| 数据漂移 | 中间新增/删除会导致跳项重复 | 游标锚定稳定 |
| 实现 | 简单 | 稍复杂 |
offset 的漂移是那个经典事故:用户在第 1 页看到了一堆,第 2 页期间服务器删了几条记录,用户再翻第 2 页,offset 会"跳过本应看到的一条",导致序列不稳定。对实时数据的列表(订单流、日志、动态)尤其致命。
cursor 的解法:客户端带着一个"上次停在哪的位置"(通常编码成校验过的游标)前进,服务器从游标位置续取,天然不受中间增删影响,深层翻页也稳定。
GET /orders?cursor=eyJvZmZzZXQiOjEwMH0|limit=20
游标的分量常被低估。一个"位置"一旦能被客户端随随便便改写,就可能被拿来探测别的切片,所以游标通常要做一个可校验的编码(年份+序号+校验位,或干脆是对"排序键最后一条"的哈希签名),让服务器拿到手能验真伪。游标也会过期——数据一直新增,太久之前的游标可能指向已被删除的位置,所以实现时要么给游标设有效期、超时返回 410 让客户端重新从头拉,要么按需重建。这些细节决定了"游标稳定锚定"是真是假,别只图个 base64 的外形,内里却是不带校验的裸偏移。
⚠️ 常见坑:所有分页都无脑上 offset。读多写少的静态目录(产品列表)用 offset 完全够;一旦是高频写入的流式数据,就要换成 cursor,否则翻 3-5 页就出现跳项这种难查的有毒表现。
五、大字段集与返回壳
再处理两件配套:
- 大字段集:默认返回壳里字段全给会拖垮列表接口。可用
fields参数让客户端按需选列,或默认返回精简字段,详情再单开。 - 稳定返回壳:列表接口要给"总条数、当前页、游标/偏移、是否有下一页"这些元数据,让客户端能正确算"是否还有、翻到哪"。
{ "data": [{"id":1},{"id":2}], "meta": { "total": 1023, "cursor": "eyJvZmZzZXQiOjIwMH0", "hasMore": true } }
meta 里的 total 也有讲究:它可能本身就是个昂贵的查询(要再数一遍全表)。数据量级大时,常见做法是把 total 改成"截断后的近似值"或干脆去掉,只保留 hasMore,让客户端据此决定"要不要再拉一页"。别让"给你一个总数"这种便利拖累每次翻页的速度——返回壳的每一格都该算出性价比,而不是机械地全给。
💡 关键直觉:查询面设计得越统一,客户端维护越省心。过滤、排序、分页是"一套语法到处通",不是"每个接口各自发明"。接口的一致性,比单个接口的炫技重要。
本节要点回顾
- 要点一:过滤、排序、分页要作统一语法设计,放查询参数。
- 要点二:排序键白名单化,避免任意字段排序。
- 要点三:offset 分页深翻变慢且有数据漂移,cursor 分页稳定锚定。
- 要点四:高频写入的流式数据用 cursor,静态目录用 offset 即可。
- 要点五:用 fields 与精简默认返回壳解决大字段集。
- 要点六:稳定返回壳带 meta,让客户端正确判断翻页与终止。
查询面通了,接下来处理"查失败时怎么回"——错误条款是违约时刻机器可读的违约书。