4.2 数据序列化与反序列化:契约的格式语言
4.2 数据序列化与反序列化:契约的格式语言
本节摘要:序列化把内存对象翻译成可传输的字节,反序列化把字节还原成对象——这是契约双方彼此读懂对方的"格式语言"。本节讲 JSON 为何成为默认、XML 的遗留取舍,并用一次"大响应拖慢接口"的演练对比紧凑格式、分页与二进制方案的解法,最后落到版本、命名、字段这三处序列化边界契约。
两端各认各的口音,接口就假了
同一份订单数据,后端序列化时把金额存成数字、日期用一种格式,前端反序列化时按另一套字段名和类型去读——结果前端页面看到"金额变成浮点一串分不清单位"、"日期差出八小时"、"字段明明该有却读不到"。两边都觉得自己没错,错的只是"口音"不统一。序列化不是"把对象变成字节"这么简单,它是契约双方在线上共同约定的语言:定哪套字段名、哪表示时间、把空值怎么表达。口音对不上,合同写得再漂亮也白搭。本节就从这份"共同语言"讲起。
学习目标
阅读完本节,你应当能够:
- 解释序列化与反序列化的作用,以及它们如何定义"契约的两侧语言"。
- 对比 JSON、XML 及紧凑/二进制格式的取舍。
- 处理字段为空、类型转换、大小写差异的序列化边界问题。
- 为大响应设计缩减方案(精简字段、分页、选择紧凑格式)。
序列化为什么是一份"共同语言"
两台服务器不会互相调内存对象——它们交换的是字节流。序列化负责"把对象变成一段符合格式的字节",反序列化负责"把字节变回对象"。这两件互为镜像的事,定义了你这份契约在线上"以什么口音聊天"。口音不统一,甲方读懂乙方就是奢望。
这也是为什么本节紧跟在选型后面:你选了施工队,还要定大家说哪门语言。JSON、XML、各种紧凑格式之间,不只是"名字不同",而是在你选择的是"传输多大、协议多强、两边好不好解析"。
不同格式在各维度上的强弱,用一张雷达式对照看得清楚:
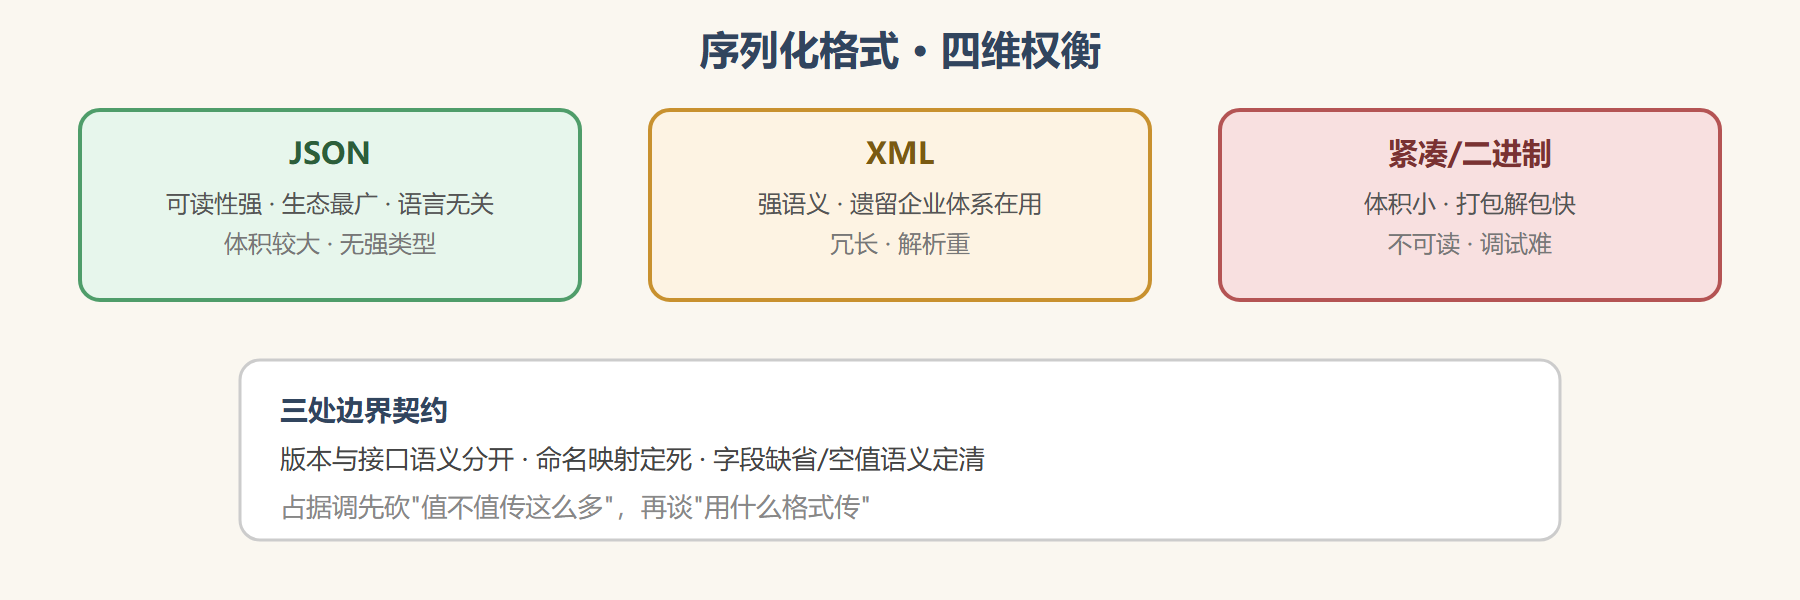
图:序列化格式四维权衡
二、主流格式一张表
| 格式 | 特点 | 取舍 |
|---|---|---|
| JSON | 人类可读、语言无关、生态最广 | 体积较大、无强类型、无注释 |
| XML | 可扩展标记、强语义标签 | 冗长、解析重、多用于遗留企业系统 |
| 紧凑/二进制 | 体积小、打包解包快 | 不可读、调试难、需专门库 |
JSON 是事实默认:轻量、跨语言、工具链最全,90% 的 REST 接口用它。XML 在现代 Web API 中大幅退让,但大型遗留企业(SOAP 沿袭、强结构化文档)仍保留。紧凑/二进制格式(如 Protobuf、MessagePack、BSON)在"数据大、吞吐敏感、内部高速链路"上有显著收益。
三、一次"大响应拖慢接口"的演练
背景:对外商品详情接口返回一份几十 KB 的 JSON,客户端普遍反映加载慢,接口耗 QPS。
操作与结果:第一步精简字段——详情接口默认只回客户端真正要的显性字段,把大文本、图片元数据之类的"重货"拆到按需取用的详情或懒加载;第二步上分页——列表接口不再全量下发;第三步评估紧凑格式——对这个响应体积大、字段稳定的内部链路,改用二进制紧凑格式能再砍 60% 以上的体积。
解读:膨胀来自三处同时加码——响应太全、字段太肥、格式太松。先砍"值不值",再砍"怎么传",才是序列化实践的正序。
变式:若响应很小(一个 id 加一个状态),分批、紧凑都是过度设计,别为 2KB 的响应背位格式的复杂度。
四、序列化边界的三处契约
即使同一份 JSON,边界不守也出事故。集中在三处:
- 版本:格式版本和 API 版本要区分清楚。序列化格式也可以演进,但不能和接口语义(字段增减、类型改造)混在一起搞。
- 命名:JSON 常见驼峰,Java 习惯 Pascal,Python 常蛇形。端到端要定死一套命名映射(如统一 JSON 走 camelCase,后端做转换),否则字段名在两端互相"翻译",错误极难查。
- 字段:缺省、空值、
null与""要定清语义。不加约定,"字段没返回"到底表示"该字段本来就没有"还是"知识空缺",两侧会各认一套。
这三处边界都吃过头,用一段 JSON 把它们凑在一起看:
{ "orderId": "10234567890123", "createdAt": "2026-08-01T10:00:00Z", "note": null, "tags": [] }
orderId 超过 2^53 就得用字符串传,否则前端精度丢;createdAt 必须固定一种时间表示(这里用 UTC ISO 8601),否则两端时区各算各的;note 的 null 和 tags 的空数组是两种不同语义——前者"没有备注",后者"标签集为空",客户端得能分得开。把日期、长整型、空值这三样在一份样例里统一约定,序列化边界就立住了七成。
剩下的三成本在跨越边界的"卫生习惯"上。一是未知字段:两端版本不同步时,客户端收到的字段可能多于预期,宽容解析(忽略不认识的新字段)比严格报错更能平滑升级,除非业务要求强校验。二是浮点与钱:金额别用浮点数,用整数分或十进制字符串,否则 0.1+0.2 的误差会在账单上露出马脚。三是大字段的转义与安全:要支持富文本或 JSON 字符串字段时,注意嵌套转义带来的解析复杂度,必要时用对象而非字符串承载。这几条看着琐碎,却是"口音"真正对不上的高频肇事处。
⚠️ 常见坑:让前端按自己习惯临时改接口字段命名(把
orderId改成order_id),版本一升,隐患全爆。序列化的命名与字段语义是契约的一部分,变更要像版本一样受控。
五、金句收束
序列化选型,是"可读性、体积、速度、生态"四件事的交换。别只看榜单决定口音——要看你的数据有多肥、链路多敏感、两边多好读懂对方。
💡 关键直觉:先把"值不值得传这么多"想清楚,再谈"用什么格式传"——顺序反了,再紧凑的格式也救不回一次本可避免的庞大响应。
本节要点回顾
- 要点一:序列化定义在线上的"共同语言",两端口音必须统一。
- 要点二:JSON 是默认,XML 遗留企业多用,紧凑/二进制适合大体积高速链路。
- 要点三:大响应先砍值不值(精简字段、分页),再谈格式优化。
- 要点四:序列化边界在版本、命名映射、字段语义三处定死契约。
- 要点五:字段命名与语义变更要像版本一样受控。
- 要点六:可读性、体积、速度、生态四事交换,按数据特性取舍。
口音统一了,下一步把整套契约正式"成文"——OpenAPI 文档是可以评审、可以生成、可以当验收依据的施工图。