3.1 SELECT 语句结构
3.1 SELECT 语句结构
本节摘要:SELECT 语句由 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY、LIMIT 等子句组成。本节讲清各子句的写法和它们的逻辑执行顺序——这个顺序是写好查询的关键。
上手前先明确
阅读完本节,你应当能够:
- 写出 SELECT 的基本结构
- 说清各子句的作用
- 描述子句的逻辑执行顺序
- 用别名让结果更易读
一、基本结构
最简单的 SELECT 只有两个子句:SELECT(选哪些列)和 FROM(从哪张表)。
SELECT FirstName, City FROM Customers;
完整的 SELECT 结构(按书写顺序):
SELECT 列名 FROM 表名 WHERE 条件 GROUP BY 分组列 HAVING 分组条件 ORDER BY 排序列 LIMIT 行数;
不是每句都要全写,按需组合。最常用的是 SELECT/FROM/WHERE。
二、各子句作用
| 子句 | 作用 | 是否必需 |
|---|---|---|
| SELECT | 选哪些列、计算什么 | 是 |
| FROM | 从哪张表 | 是(除 SELECT 常量) |
| WHERE | 过滤行 | 否 |
| GROUP BY | 分组 | 否 |
| HAVING | 过滤分组 | 否(配合 GROUP BY) |
| ORDER BY | 排序 | 否 |
| LIMIT | 限制行数 | 否 |
三、逻辑执行顺序(关键)
这是初学者最容易忽略、但最重要的点:SQL 的书写顺序和执行顺序不一样。
图 3-1 SELECT 逻辑执行顺序
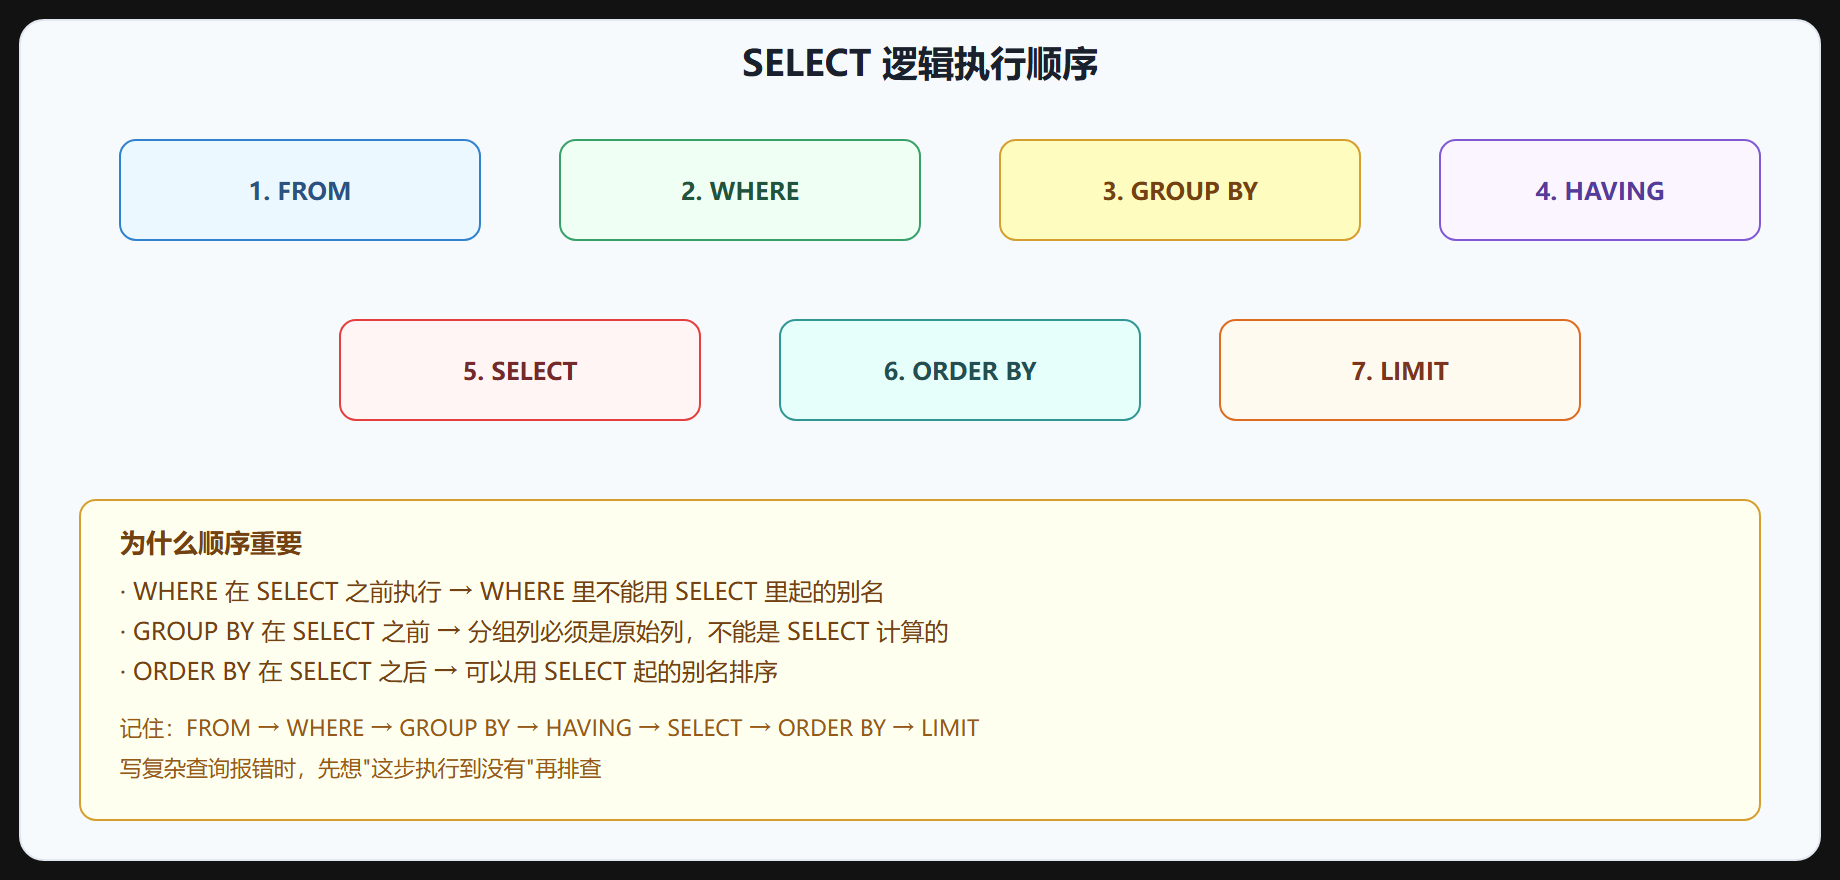
逻辑执行顺序:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT。
理解这个顺序能解释很多报错:
WHERE Amount > AVG(Amount)报错——WHERE 在聚合前执行,AVG 还没算出来,要放 HAVING。WHERE cnt > 5(cnt 是 SELECT 起的别名)报错——WHERE 在 SELECT 前,别名还没起,要么用原表达式,要么放 HAVING。ORDER BY cnt可以——ORDER BY 在 SELECT 后,别名已起好。
四、列别名
用 AS 给列或计算结果起别名,让结果更易读:
SELECT FirstName AS 名字, Amount * 1.1 AS 含税金额 FROM Orders;
AS 可省略(FirstName 名字),但建议保留以提高可读性。别名常用于计算列、聚合结果。
五、SELECT 的几种用法
SELECT *:选所有列(别在生产用,浪费且不稳定)SELECT 列1, 列2:选指定列SELECT 表.列:多表时加表名前缀避免歧义SELECT 1+1:不查表,算常量(部分 DBMS 要FROM dual)
⚠️ 常见坑:生产代码用
SELECT *——表结构一变列顺序变,依赖列顺序的程序就崩。永远显式列名。
💡 关键直觉:记住 SELECT 的逻辑执行顺序,写复杂查询报错时先想"这步执行到没有"。WHERE 用原始列、ORDER BY 可用别名,就是这个顺序决定的。
温故知新
- 基本结构:SELECT/FROM/WHERE/GROUP BY/HAVING/ORDER BY/LIMIT,按需组合。
- 逻辑执行顺序:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT,和书写顺序不同。
- 顺序的影响:WHERE 不能用 SELECT 别名、不能用聚合;ORDER BY 可以用别名。
- 别名:用
AS给列/计算起名,提高可读性,建议保留 AS。 - 别用
SELECT *,显式列名更稳定。
下一节深入 WHERE——过滤行的各种条件写法。
常见疑问
Q1:执行顺序为什么和书写顺序不一样?
书写顺序是给写代码的人看的:先 SELECT 再 FROM 再 WHERE。但数据库执行时,得先知道"从哪张表取数据"(FROM),才能过滤(WHERE),最后才轮到"选哪些列、起什么别名"(SELECT)。所以 WHERE 里不能用 SELECT 起的别名,因为 SELECT 还没执行。这个差异是新手最大的困惑来源,记住执行顺序就能解释大半报错。
Q2:SELECT * 真的不能用吗?
生产环境不建议。原因:1) 返回无关列浪费带宽和内存;2) 表结构变化时结果集跟着变,代码可能悄悄出错;3) 无法利用覆盖索引优化。调试时用 SELECT * 方便,写完正式代码前改成显式列名。
Q3:别名(AS)什么时候必须写?
- 计算结果列,如 Amount * 1.1 AS 含税金额;2) 聚合结果,如 COUNT(*) AS 客户数;3) 多表查询时给表起短别名。别名让结果可读,也让后续引用更方便(ORDER BY 可用别名)。注意别名只在当前语句内有效。
Q4:为什么 WHERE Amount > AVG(Amount) 会报错?
因为 AVG 是聚合函数,聚合要在 GROUP BY 阶段计算,而 WHERE 在分组之前执行,此时 AVG 根本算不出来。想"过滤出大于平均值的行",要么用子查询:WHERE Amount > (SELECT AVG(Amount) FROM Orders),要么用 HAVING(分组后)。这个报错正是执行顺序的直接体现。
动手做一做
学习子句结构和执行顺序,最好的办法就是故意写错。
建议你建一张练习表,然后依次尝试下面几种写法,观察报错信息:
第一种,在过滤条件里使用聚合函数。你会收到错误提示,因为过滤发生在分组聚合之前,此时聚合结果还不存在。
第二种,在过滤条件里使用选择列表里的别名。你同样会收到错误提示,原因还是执行顺序——别名要在选择列表阶段才生成,而过滤比它早。
第三种,在排序子句里使用别名。这次不会报错,因为排序发生在选择之后,别名已经可以用了。
把这三个例子连起来做一遍,你会清楚地看到:过滤阶段用不了别名和聚合,排序阶段却可以。这背后的原因,就是那句执行顺序口诀。报错信息是最好的老师,它能帮你把抽象的顺序规则变成身体记忆。
做完之后,再试试给计算结果列起个别名,把别名用于排序,体会"别名只在当前语句内有效"这句话的含义。
一句话记忆
书写顺序是给人看的,执行顺序是给数据库跑的。记住"先取表、再过滤、后分组、才选列、再排序、最后限量",就能解释绝大多数查询报错。