3.2 WHERE 子句条件过滤
3.2 WHERE 子句条件过滤
本节摘要:WHERE 子句过滤行,只返回满足条件的。本节讲比较运算符、逻辑运算符、BETWEEN/IN/LIKE/IS NULL 等特殊运算符,以及组合条件的写法。
本节导读
阅读完本节,你应当能够:
- 用比较运算符过滤
- 用 AND/OR/NOT 组合条件
- 用 BETWEEN/IN/LIKE/IS NULL 等特殊运算符
- 避免过滤的常见坑
概念脉络
一、比较运算符
最基础的过滤,比较列和值:
SELECT * FROM Customers WHERE City = '北京'; SELECT * FROM Orders WHERE Amount > 100; SELECT * FROM Orders WHERE Amount <> 50; -- 不等于
| 运算符 | 含义 |
|---|---|
| = | 等于 |
| <> / != | 不等于 |
| > / < | 大于 / 小于 |
| >= / <= | 大于等于 / 小于等于 |
注意字符串比较区分大小写因 DBMS 而异,必要时用 LOWER() 统一。
二、逻辑运算符
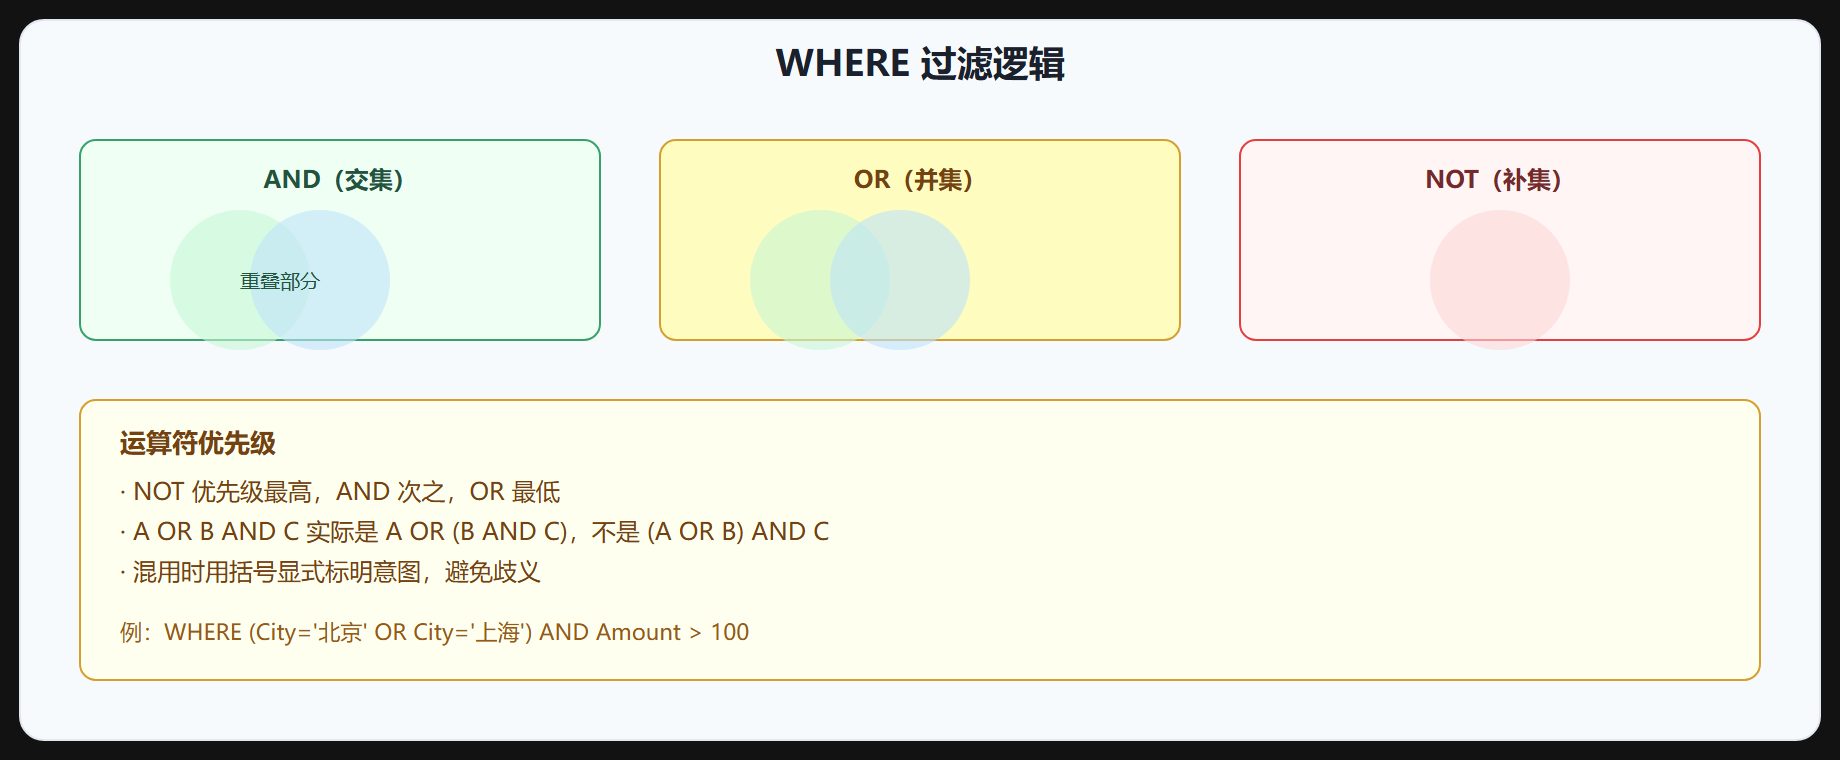
用 AND/OR/NOT 组合多个条件:
-- 北京且名字是 Alice SELECT * FROM Customers WHERE City = '北京' AND FirstName = 'Alice'; -- 北京或上海 SELECT * FROM Customers WHERE City = '北京' OR City = '上海'; -- 不在北京 SELECT * FROM Customers WHERE NOT City = '北京';
图 3-2 WHERE 条件过滤示意
三、特殊运算符
BETWEEN:范围
SELECT * FROM Orders WHERE Amount BETWEEN 50 AND 200;
包含边界(50 和 200 都算)。等价于 >= 50 AND <= 200。
IN:枚举
SELECT * FROM Customers WHERE City IN ('北京','上海','广州');
等价于 City='北京' OR City='上海' OR City='广州',但更简洁,且列表长时性能好。
LIKE:模糊匹配
配合通配符 %(任意多字符)和 _(一个字符):
WHERE FirstName LIKE 'A%'; -- A 开头 WHERE LastName LIKE '%son'; -- son 结尾 WHERE City LIKE '_ondon'; -- 任意一字符 + ondon(如 London)
⚠️ 常见坑:
LIKE '%xxx%'前后通配的查询走不了索引,大表上很慢。能避免就避免,或用全文索引。
IS NULL:判断空值
SELECT * FROM Customers WHERE City IS NULL; -- 为空 SELECT * FROM Customers WHERE City IS NOT NULL; -- 非空
记住 NULL 不能用 = NULL,必须用 IS NULL。
四、组合条件的写法
复杂条件用括号显式分组:
SELECT * FROM Orders WHERE (City = '北京' OR City = '上海') AND Amount > 100 AND OrderDate BETWEEN '2024-01-01' AND '2024-06-30';
不写括号靠优先级容易出错,写出来别人也难读。生产代码建议关键组合都加括号。
五、过滤的常见坑
| 坑 | 说明 | 正确写法 |
|---|---|---|
= NULL |
查不到空值 | IS NULL |
LIKE '%x%' |
走不了索引,慢 | 能用前缀匹配就 LIKE 'x%' |
| 类型不匹配 | WHERE id = '1'(id 是 INT)隐式转换可能不走索引 |
类型一致 |
| 函数包裹列 | WHERE UPPER(City)='BJ' 可能不走索引 |
看情况,必要时建函数索引 |
| 日期字符串格式 | WHERE date = '2024-6-1' 可能格式不符 |
用标准 '2024-06-01' |
💡 关键直觉:WHERE 是过滤行的主力,掌握比较/逻辑/特殊运算符能写 80% 的过滤。混用运算符时用括号显式分组,NULL 用 IS 判断,模糊匹配注意性能。
要点速记
- 比较运算符:=、<>、>、<、>=、<=,字符串比较大小写因 DBMS 而异。
- 逻辑运算符:AND(交集)、OR(并集)、NOT(补集),优先级 NOT>AND>OR,混用加括号。
- 特殊运算符:BETWEEN(含边界范围)、IN(枚举)、LIKE(% 任意多/_ 一个)、IS NULL(判空)。
- 坑:
= NULL查不到、%x%不走索引、类型不匹配、函数包裹列、日期格式。 - 复杂条件用括号显式分组,避免靠优先级。
下一节讲排序——ORDER BY。
常见疑问
Q1:AND 和 OR 混用时为什么结果不对?
因为 AND 优先级高于 OR。City='北京' OR City='上海' AND Amount>100 实际被解析成 City='北京' OR (City='上海' AND Amount>100),北京客户不管金额都返回了。想表达"北京或上海的客户,金额都大于 100",必须加括号:(City='北京' OR City='上海') AND Amount>100。括号是写条件的必备习惯。
Q2:LIKE 通配符怎么用才能走索引?
LIKE '北%'(前缀匹配)通常能走索引;LIKE '%京%'(前后都有通配符)大概率全表扫描。所以能确定前缀就尽量用前缀匹配。另一个选择:IN、= 能走索引,别为了"像"就滥用 LIKE。
Q3:WHERE 里对列做函数为什么慢?
因为一旦对列做运算(UPPER(City)、YEAR(OrderDate)、Amount+1),索引就失效了——索引存的是原始值,没法按函数结果查找。所以尽量写 City='北京' 而不是 LOWER(City)='北京',日期用范围查询而不是 YEAR(date)=2024。
Q4:NULL 参与条件判断的坑还有哪些?
除了 = NULL 查不到,还有 NOT IN 的坑:WHERE x NOT IN (1,2,NULL) 会返回空集,因为 x 和 NULL 比较结果是未知,整行被过滤。所以有 NULL 风险时优先用 NOT EXISTS 或先排除 NULL。这类问题在子查询章节会再遇到。
动手做一做
过滤条件的坑,几乎都可以靠动手踩一遍来记住。
建议准备一张练习表,插入若干条数据,其中故意包含:空值、重复值、相似但不相同的字符串、大小写不同的字符串。
然后依次做这几个练习:
第一个,用等号判断空值,再改用正确的空值判断关键字,对比两次的结果,记住空值必须用专门写法。
第二个,分别用前后通配符和前缀通配符查询,观察哪些写法能命中、哪些命中不了,体会通配符的匹配规则。
第三个,写一个混合了逻辑与、逻辑或的条件,先不加括号跑一次,再加上括号跑一次,对比结果差异,亲眼看看括号对分组判断的作用。
第四个,用范围关键字和枚举关键字各写一遍同样的需求,体会它们和比较运算之间的等价关系。
这四个练习做完,过滤条件里最经典的几个坑——空值判断、通配符、括号优先级、范围与枚举——就都变成你的实战经验了。光是读规则容易忘,踩过一遍才会长记性。
一句话记忆
过滤的本质是"给每一行做判断,留下为真的行"。空值要专门判断,通配符分前缀和非前缀,逻辑组合记得加括号,这三点记住了,过滤就基本过关了。