1.2 TensorFlow与PyTorch选型对照
1.2 TensorFlow 与 PyTorch 选型对照
本节摘要:TensorFlow 与 PyTorch 不是「有无功能」之争——张量、自动微分、层库、优化器、数据加载两边都有。真正分叉的是默认计算图形态、训练循环的封装程度、以及部署工具链的历史重心。Google Brain 维护的 TensorFlow 长期把生产导出(Serving、Lite、JavaScript)当作一等公民;Meta 研究团队推动的 PyTorch 长期把动态图和 Python 调试体验当作一等公民。选型按你此刻缺的是「更快看到拟合曲线」还是「每一步梯度可见」,而不是按阵营站队。
本节目标
阅读完本节,你应当能够:
- 列出两边重叠的五块核心能力,避免把营销词当成差异
- 对照动态图 / 即时执行对调试与控制流的影响
- 说明 Keras
fit与手写循环分别牺牲了什么、换来了什么 - 按研究原型、服务端部署、移动端、浏览器四类场景给出倾向性建议
先承认重叠,再谈分叉
原文把选择这两套框架的理由写得很硬:它们是业界与学界使用最广的两套,学习成本会转化成读论文、读生产代码的能力。这个判断今天仍然成立,但入门者常犯的错是把「最流行」直接翻译成「我应该只学一套」。对照教程的立场相反:正因为两套都会在你的职业生涯里出现,才值得把对应关系一次建好。
重叠的部分可以压缩成一张表。你会发现,后面第 2 到第 4 章对照的不是「会不会做」,而是「默认怎么做」。
| 能力 | TensorFlow 侧常见入口 | PyTorch 侧常见入口 | 入门时真正要注意的 |
|---|---|---|---|
| 张量计算 | tf.constant / tf.Variable |
torch.tensor / nn.Parameter |
设备字段、dtype、是否可求导 |
| 自动微分 | tf.GradientTape |
autograd 与 requires_grad |
谁记录、何时 watch、何时 no_grad |
| 层与模型 | Keras layers / Model |
torch.nn / nn.Module |
Sequential 对 __init__+forward |
| 优化器 | tf.keras.optimizers |
torch.optim |
学习率是否显式传到构造函数 |
| 数据加载 | tf.data.Dataset |
Dataset + DataLoader |
预取与多进程的默认坑不同 |
功能表看完,差异才开始有意义。TensorFlow 把 Keras 收成官方高层 API 之后,入门路径几乎被 Sequential → compile → fit 锁死,好处是十分钟能看到准确率往上走;坏处是训练循环内部的清梯度、反向、更新被藏起来,对照 PyTorch 时会突然觉得「怎么突然要写这么多」。PyTorch 从一开始就把循环留给用户,好处是和教材上的伪代码一一对应;坏处是漏写 zero_grad 或忘了 model.eval() 会以一种很安静的方式毁掉实验。
把两套框架比成单反与无反相机更合适,而不是「专业与玩具」。都能拍照,取景、对焦、换镜头的手感不同。Keras 像把光圈快门交给自动挡,PyTorch 像每次自己转拨盘。自动挡不是低级,拨盘也不是高级;你在赶交付时需要自动挡,在查过拟合从哪一轮开始时需要拨盘。本教程两套都写,就是为了让你能按场景切换挡位。
独特优势:部署链对调试链
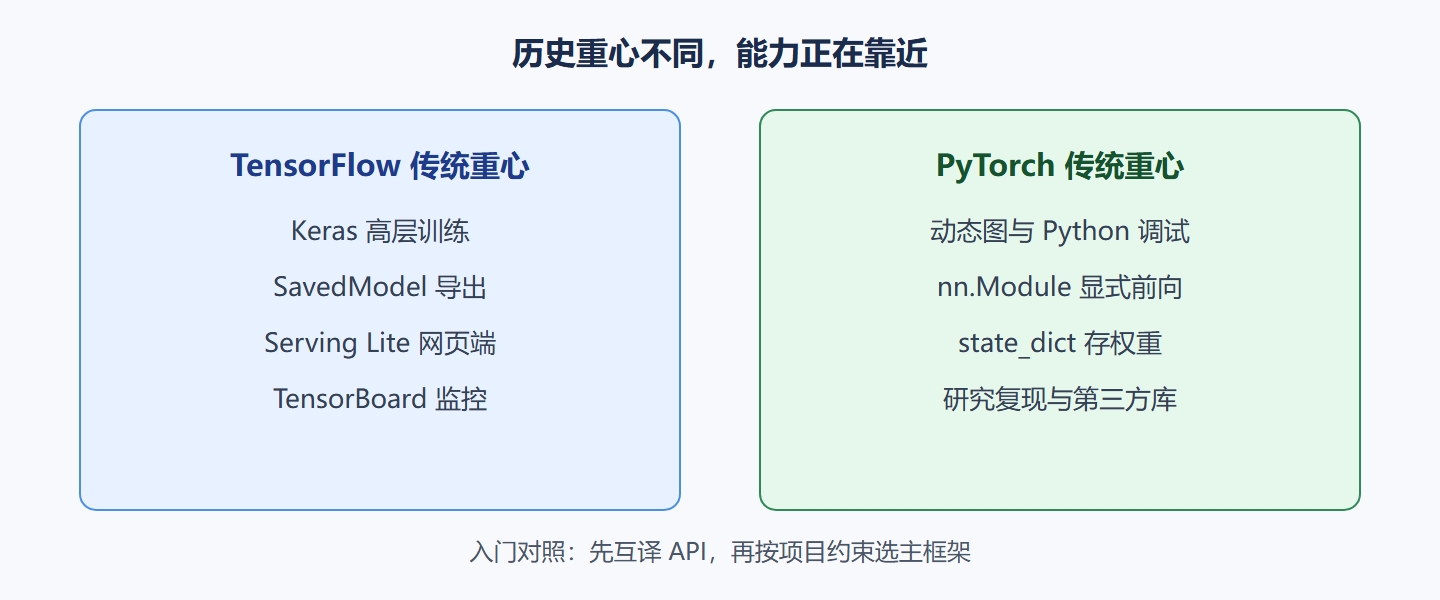
原文对 TensorFlow 的三条优势写得很具体:生产部署生态、大规模分布式训练的历史投入、以及 TensorBoard 这一套可视化。对 PyTorch 则强调动态计算图(在 TensorFlow 里对应即时执行,但 PyTorch 更早把它当默认)、更贴 Python 的 API,以及研究社区与第三方库(自然语言处理里常见的预训练模型库、视觉增强库)的活跃。这些不是广告词,它们会直接决定你第一周的挫败来自哪里。
部署链上,TensorFlow 的传统路径是训练完成 → 导出 → 按目标环境分支:服务端用 Serving,移动与嵌入式用 Lite,浏览器用 JavaScript 侧方案。你在入门阶段未必真的会走完这三条,但「导出格式是一等公民」会体现在 model.save 默认走向 SavedModel,而不是一个只含权重的字典。PyTorch 传统上更常保存 state_dict,加载时必须先有一份同结构的 nn.Module;整模保存也能做,但原文明确更推荐状态字典,以免序列化绑定到当时的类定义细节。
研究想法 → 动态图代码 → pdb 式调试 → 论文或原型 产品需求 → 稳定导出 → 服务 / 移动 / 网页 三端分流
调试链上,动态图意味着 Python 的 if 和循环就是图的控制流。变长序列、按样本走不同分支的网络,在 PyTorch 里通常更顺手。TensorFlow 2 默认即时执行之后,这条鸿沟已经缩小,但生态惯性还在:你在论文仓库里看到的复现代码,统计上仍大量是 PyTorch。若你的工作是「本周复现一篇视觉论文」,先看作者给的框架,再决定本周主环境,比先赌一套更省时间。
⚠️ 常见坑:用「TensorFlow 不能动态图」或「PyTorch 不能上生产」这种过期口号做选型。两边都在补对方的短板——TensorFlow 有即时执行,PyTorch 有导出与服务方案。要以你项目的约束为准:移动端包体、团队已有的 Serving 经验、合作方的代码语言。
💡 关键直觉:把「谁写训练循环」当成第一分水岭。想先看到曲线,走 Keras 的
fit;想看清每一步,走 PyTorch 的五步循环。本教程第 4.3 节会把fit展开成那五步,两边就能互译。
分布式训练与可视化不要在入门周当成决胜负的点。原文提到 TensorFlow 对大规模分布式的早期投入,以及 TensorBoard 对图、指标、嵌入的监控;PyTorch 侧同样可以打日志、同样可以接到同类可视化后端。入门数据是 Fashion MNIST,单机 CPU 或一块入门 GPU 就够。等你真的要把批次拆到多卡,再去对照各自的分布式策略不迟——那时你已经有第 4 章的循环作为共同语言。
社区与生态是「你卡住时能问到谁」。两边官方文档都完整,问答站点与代码托管平台上都有海量片段。预训练模型方面,原文点到 TensorFlow Hub 与 PyTorch Hub,以及第三方对两套都提供的模型卡。入门分类器用不到预训练,但你要知道:以后做迁移学习,框架选择有时会被「这个权重文件先以哪边发布」决定,而不是被你的个人偏好决定。
融合趋势也写进原文了:两边互相借鉴,即时执行、Keras 3 多后端、ONNX 这类中间格式,都在降低「选错就锁死」的风险。对照学习的附加好处是,你看到融合时能认出「这是在把对方的默认体验搬过来」,而不会以为出了第三套全新哲学。
图 研究侧与生产侧的历史重心
一张可执行的选型表
把「我该学哪套」改写成三个可回答的问题,比看排行榜有用。第一,你这四周的产出是论文复现还是要进一个已有的 TF Serving 流水线?第二,团队里已有的代码审查语言是 Keras 回调还是手写循环?第三,目标设备有没有 Lite / 浏览器这类硬约束?三个问题若指向同一边,就以那一边为主环境、另一边当对照阅读;若指向分裂,本教程的结构就是为你准备的——主环境仍建议先选一个把 Fashion MNIST 跑通,避免两套都装到半残。
我的倾向(仅作对照起点,不是命令):个人研究与课程作业,PyTorch 的循环更贴教材;已有 Keras 代码基或需要尽快给非算法同事看曲线,Keras fit 更合适;移动端包体和算子覆盖要先查 Lite 转换是否支持你用到的层,再决定训练侧框架。ONNX 可以作为「两边都不想绑死」时的中间层,但入门周不要把转换工具链也加进来,否则对照轴会从五条变成八条。
原文还提到两者都提供 GPU 加速的张量运算,这是相对 NumPy 的共同优势,不是彼此之间的差异。选型时不要把「能不能用 GPU」写成 PyTorch 特有或 TensorFlow 特有。能用、怎么指定设备、形状在设备间复制的代价,才是第 2.1 节要对照的内容。
对初学者「先学哪套」这个问题,原文的态度很宽松:搭建第一个模型,选哪个都可以。本教程同意这句话,但加一个约束——你必须在同一数据上看到另一套的对应代码,否则「都可以」会变成「我永远只碰先碰到的那套」。第 5 章会强制这个约束:同一 Fashion MNIST、相近的 128 隐层容量、两侧都训练若干 epoch,再谈准确率差异来自框架还是来自预处理(像素除以 255 对 Normalize 到 0.5 均值)。
融合并不等于差异消失。即时执行让 TensorFlow 也能逐步调试,但 Keras 的默认心智仍是「编译一次,拟合多次」;PyTorch 2 系列对编译加速的投入在增加,但入门代码仍以eager 循环为主。读文档时看到「现在另一边也有了」,把它记成生态补齐,不要记成「所以不用对照了」。对照的价值在约定:标签是稀疏整数还是 one-hot,损失是否 internally softmax,保存的是图加权重还是纯字典。
把口号翻成约束清单
「TensorFlow 更工业、PyTorch 更学术」曾经接近事实,当口号用已经误导。翻成约束更有用。约束一:现有代码库是 Keras 回调还是 nn.Module。约束二:目标设备有没有 Lite 转换清单上的算子限制。约束三:合作论文或开源权重先以哪边发布。三条指向同一边就定主环境;指向分裂就以本教程的对照结构当工作方式——主环境跑通,对照环境阅读。不要用社交媒体上的框架战代替这三条。
可视化也不该当决胜负。TensorBoard 确实出身 TF 生态,但指标、直方图、图结构这些需求在 PT 侧同样能打日志接到同类后端。入门阶段你甚至只用打印损失。等曲线要给非算法同事看,再上可视化,那时选你团队已经在用的那套,而不是为了「正统」强行安装另一套仪表盘。
分布式训练同理。原文写 TF 早期就为大规模集群设计,这影响了数据并行、策略 API 的成熟度叙事。你的 Fashion MNIST 用不到。等到真要把 batch 拆到多卡,再按当时文档对照 tf.distribute 一类策略与 PT 的分布式数据并行,两边都在演进,本课不锁版本号。入门把「单机五步」练熟,分布式只是把五步里的梯度做一次跨卡归约,概念上不是第三种学习算法。
问题:能不能只学 Keras,把 PyTorch 当选修?
可以当作四周计划,不可以当作职业策略。论文仓库、预训练模型卡、同事丢过来的 state_dict,会在你不选修的那个月出现。本教程的最低要求是:Keras 路径能独立跑通,PT 路径能读懂循环并改一处超参。反过来亦然。只学字符串 'adam' 而不知道 lr=0.001 写在哪,对照表会缺一行。
一节小结
- 重叠先划掉:张量、自动微分、层、优化器、数据加载两边都有;差异在默认路径与工具链重心
- 第一分水岭:Keras 把循环收进
fit,PyTorch 把循环留给你;互译比站队重要 - 部署对调试:TF 传统强在导出三端,PT 传统强在动态图与研究复现;口号过期,约束不过期
- 社区会反向选择你:论文代码与 Hub 权重有时先决定框架,个人偏好排第二
- 入门策略:主环境跑通一个分类器,对照环境读对应 API,第 5 章强制双侧成绩可比
- 融合是补齐不是合并:即时执行与编译加速在靠近,稀疏交叉熵与 Softmax 约定仍要记
下一节把安装与笔记本环境摊开对照:命令可以不一样,验证标准必须一样——做一个最小张量加法,确认 GPU 可见性,再进入第 2 章。