1.3 开发环境对照
1.3 开发环境对照
本节摘要:对照实验的前提是两套框架都能在同一台机器上被导入、做一次张量加法、并报告设备列表。原文要求 Python 3.6 或更高,推荐 Conda 管理环境;TensorFlow CPU 用
pip install tensorflow,PyTorch CPU 示例为pip install torch torchvision torchaudio。GPU 必须按官方 CUDA 对照安装,本教程不编造具体驱动版本。Jupyter 适合逐步对照单元格,Colab 适合没有本地 GPU 时借一块加速卡。先验证安装,再下载 Fashion MNIST。
你能学到什么
阅读完本节,你应当能够:
- 说明为何对照学习要用独立虚拟环境,而不是往系统 Python 里混装
- 复述原文给出的 CPU 安装命令,并解释 GPU 安装不能抄命令、要对表
- 写出两侧最小验证:导入、打印版本字符串、做一次加法、列出物理 GPU
- 在 Jupyter 与 Colab 之间按「是否需要本地 GPU、是否需要长期保留数据」做选择
环境是对照的第三套「框架」
两套深度学习库会争依赖:NumPy 大版本、CUDA 运行时、甚至某个间接库的编译选项。把它们直接塞进系统 Python,过几周你会得到一种很难复现的状态——「昨天还能 import,今天某一侧报 DLL」。对照教程对这件事零容忍:每一侧一个环境,或者一个环境里同时装但把版本冻结下来。原文推荐 Anaconda 或 Miniconda,不是因为它们神秘,而是因为「建环境、装科学计算栈、删环境」比手动改系统路径更可逆。
Python 下限按原文写:3.6 或更高。这是当时教程的门槛,不是要你去装 3.6。实践里用发行版当前支持的 3.x 即可,但不要在未经验证的超前版本上同时开两套 GPU 包。本教程不写死小版本号,避免三个月后变成错误文档。
Pip 与 Conda 可以混用,但规则要简单:用 Conda 管 Python 与 CUDA 工具链,用 Pip 装框架本体——或反过来,全程 Pip,但不要两套包管理器轮流升级同一个 NumPy。Windows 上 PyTorch 的 DataLoader 多进程在原文里被点名:num_workers 出问题先改回 0。这不是安装节的主线,但你现在就要知道:环境问题有时会伪装成数据管线问题,第 3.2 节会回头钉死。
⚠️ 常见坑:在一个已经装过旧版 TensorFlow 的环境里再
pip install torch,然后用「能 import」当成成功。真正的成功标准是两侧都能完成一次张量加法,并且tf.config.list_physical_devices与torch.cuda.is_available的输出符合你的预期(没有 GPU 时应当明确打印 CPU,而不是报错)。
安装命令对照:CPU 可抄,GPU 必须对表
原文把 CPU 路径写得很短,这是好事。TensorFlow:pip install tensorflow,默认 CPU。需要可视化时另装绘图库,原文示例是与 matplotlib 一起装。PyTorch:到官方页面按操作系统、包管理器、Python、CUDA 勾选;CPU 示例命令为 pip install torch torchvision torchaudio。torchvision 不是装饰,第 5 章加载 Fashion MNIST 会用到它的数据集接口;TensorFlow 侧则走 keras.datasets.fashion_mnist,不依赖 torchvision。
GPU 路径不能从教程里抄死命令。驱动、CUDA、cuDNN、框架编译版本四者要对齐,官方用一张表维护,本课若写死某一行,过期后会变成大规模装失败。原则只有三条:先看显卡驱动是否被框架支持;再按官方生成器给出的命令装;最后用设备列表验证,而不是用任务管理器里「好像有占用」验证。没有独立显卡的读者,全程 CPU 即可完成对照,第 5 章的 10 个 epoch 在 Fashion MNIST 上可以接受。
| 步骤 | TensorFlow 侧 | PyTorch 侧 | 共同验收 |
|---|---|---|---|
| 建环境 | Conda 新建环境后激活 | 同左,或另一独立环境 | python 指向环境内解释器 |
| CPU 安装 | pip install tensorflow |
pip install torch torchvision torchaudio |
import 无异常 |
| GPU 安装 | 按官方 CUDA 对照 | 按官方勾选生成命令 | 设备列表非空且运算能放到 GPU |
| 验证 | 常量加法并打印设备 | 张量加法并打印 device |
结果张量数值合理 |
验证代码保持概念性,不要在安装节引入模型。TensorFlow 侧用常量张量相加,并列出物理设备;PyTorch 侧构造两个张量相加,打印 torch.cuda.is_available()。版本字符串用库自带的版本属性打印即可,用来做实验记录,不要在口头交流里把它说成「必须是这个版本才能学本课」。
Colab 的价值是把 GPU 安装从你的电脑上拿走。适合「今晚想看第 5 章两侧曲线、家里没有显卡」的场景。代价是会话结束数据与环境会重置,长期对照笔记更适合本地 Jupyter。Jupyter 的单元格很适合左右对照:一个笔记本里用章节分隔 TF 与 PT,避免在同一单元格混用两套张量对象。混用不是语法禁止,而是心智负担——numpy() 与 .numpy()、.cuda() 与 tf.device 会在疲劳时写错。
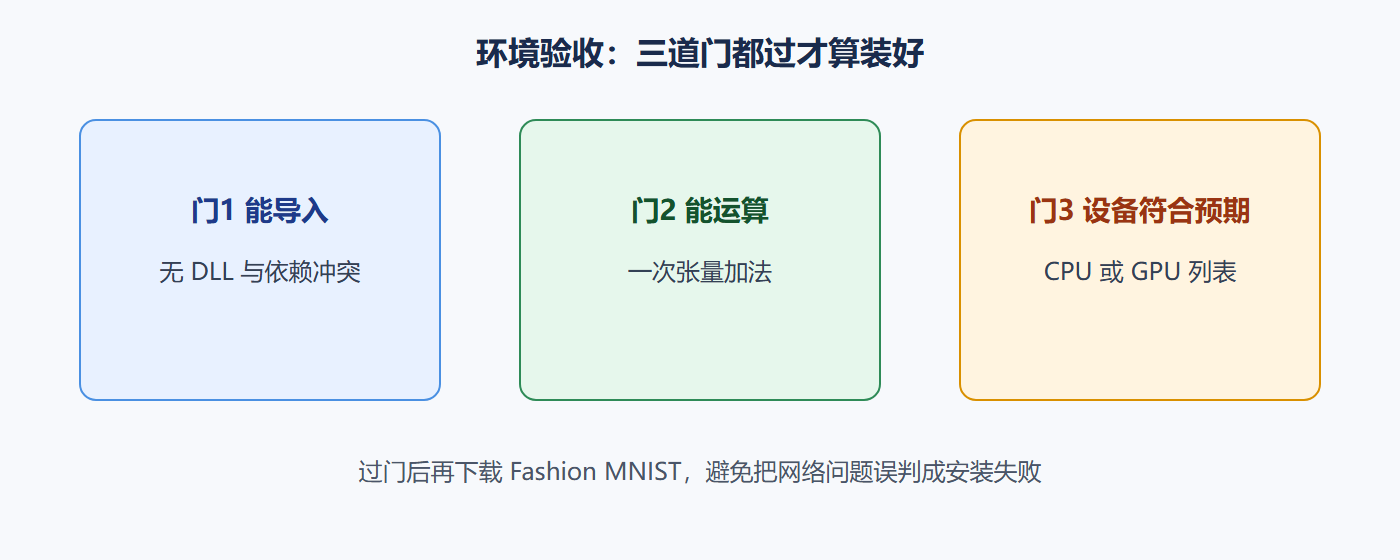
图 安装验收门,而不是安装仪式
对照实验的工作习惯
同一台机器上同时保留两套环境时,命名要能看懂:按框架而不是按日期。笔记本文件也不要叫「新建 12」。第 5 章会同时出现 Keras 的像素除以 255.0 与 PyTorch 的 Normalize((0.5,), (0.5,)),预处理不一致会导致你以为「框架准确率差了两个点」,其实只是输入分布不同。环境节就要立规矩:对照实验必须把预处理差异写进笔记第一行。
依赖范围按原文:TensorFlow 侧另需绘图库才能画曲线;PyTorch 侧另需 torchvision 才能用内置 Fashion MNIST。不要提前安装一长串「也许用得到」的扩展,以免对照被无关升级打断。科学计算基础(NumPy)两边都会用到,张量与 NumPy 的互转留到 2.1 节。
# 概念性验证:只确认导入与一次加法,不在这里训练 import tensorflow as tf a = tf.constant([1.0, 2.0]) b = tf.constant([3.0, 4.0]) print(a + b) print(tf.config.list_physical_devices()) import torch x = torch.tensor([1.0, 2.0]) y = torch.tensor([3.0, 4.0]) print(x + y) print(torch.cuda.is_available())
若加法能打印而 GPU 列表为空,对 CPU 读者这是正常验收通过;对「我以为装了 GPU 版」的读者,这是失败,回到官方对照表,不要用训练速度自我安慰。Colab 里切换加速卡后必须重新运行导入单元格,旧的 CPU 会话不会自动变 GPU。
💡 关键直觉:安装成功的定义是「最小运算 + 设备列表符合预期」,不是「pip 退出码为 0」。退出码为 0 只说明包解压完了。
磁盘与网络也要预算。首次加载 Fashion MNIST,Keras 与 torchvision 可能各下一份缓存,对照学习等于准备两份副本。把下载放到验证安装之后,是为了把「证书 / 镜像 / 代理」问题从「框架损坏」里拆出去。公司网络拦截时,先解决数据获取,再怀疑框架。
最后谈 Jupyter 内核。每个环境对应一个内核,笔记本右上角要能看出当前是哪一侧。在 TF 内核里 import torch 失败不一定是 PyTorch 没装,可能只是你选错了内核。对照课把这种「像框架 bug、其实是环境指错」的事件当成基本功,而不是丢脸。
对照实验的环境纪律再加几条
版本打印不只是为了好看。把两侧版本字符串贴进实验卡片,过几个月你才知道「当时那次 128 隐层的成绩」是在哪套二进制上跑出来的。本课不要求锁定小版本,但要求记录。升级某一侧之后,先重跑张量加法,再重跑第 5 章基线,不要假设「小版本不会改默认学习率或随机算法」。
混合精度、XLA、编译模式都不要在安装周打开。它们改变数值与速度,会让对照实验多出第三变量。CPU 读者更不必为了「专业」去装一堆加速插件。等 MLP 基线稳定、你怀疑瓶颈在计算而不是数据时,再按官方文档开这些开关,并且一次只开一个。
权限与公司代理:download=True 的数据集获取失败时,错误栈很长,末行才是连接问题。先用浏览器或系统工具确认外网,再怀疑 pip 源。镜像源能加快装包,但 GPU 轮子必须仍与 CUDA 对照表一致,不要从来路不明的地方捡编译好的包。安全上,权重文件接近可执行代码,安装节就要形成「不乱加载来历不明检查点」的习惯,4.4 会再强调。
Jupyter 里 %pip install 有时装到了错误的内核。验收时在「即将跑实验的那个笔记本」里执行导入,而不是在系统终端里导入成功就宣布胜利。终端与笔记本不是同一解释器的故事,对照课里每周至少发生一次。把内核名称显示在界面上,比写一长段环境变量教程更有效。
问题:必须同时装两套吗?
不是必须同一环境同时装。可以两个 Conda 环境,笔记本选不同内核。同时装的好处是对照单元格切换快,坏处是依赖冲突概率上升。磁盘与耐心都够就分环境;只做周末速成、只在 Colab 里,可以用两个笔记本文件分别装,不要在同一运行时里反复卸载重装。无论哪种,验收门不变:导入、加法、设备列表。
GPU 版安装失败最常见的原因不是 pip 退出码,而是驱动与轮子不匹配:能 import,加法在 CPU 上能跑,list_physical_devices 或 cuda.is_available 为假。这时不要开始训练还自我安慰「CPU 也一样」。若你的计划包含第 5 章在分钟级看完 CNN,没有 GPU 就要接受墙钟更长,而不是反复重装。有 GPU 却显示不可用,回到官方对照表,检查是否装成了 CPU 轮子。不要同时用 Conda 装一套 CUDA、Pip 再装一套,两套抢。选一条链走到底。
Jupyter 与脚本的差异:脚本里 if __name__ 保护对 PT workers 重要;笔记本里每个单元格的顺序即状态,重启内核后必须重跑导入与模型定义。对照实验在笔记本里最容易出现「我改了类定义但实例还是旧的」。养成改 Module 类之后重新实例化、重新 to(device)、必要时重新创建优化器(优化器持有旧参数引用)。Keras 重新 compile 有类似必要。这是环境纪律在交互式环境里的延伸。
核心回顾
- 环境可逆:用 Conda 或 venv 隔离;系统 Python 混装是对照实验的第一杀手
- CPU 命令可抄:原文
pip install tensorflow与pip install torch torchvision torchaudio;GPU 必须对官方表 - 三道验收门:能导入、能加法、设备列表符合预期;pip 成功不等于装好
- 笔记本选择:本地 Jupyter 利于长期对照;Colab 利于临时借 GPU,会话结束会丢环境
- 预处理笔记:两侧输入规范化可能不同,必须写在实验第一行,否则准确率不可比
- Windows 伏笔:
DataLoader的num_workers出问题先改 0,别在安装节误判为 PyTorch 损坏
下一章进入张量对照:同一份像素,在
tf.Tensor与torch.Tensor里形状、dtype、设备如何表达,以及为什么 NumPy 不够用。
安装对照还有一条容易忽略:绘图库与 torchvision 不是同一侧的对称依赖。Keras 路径画曲线常另装绘图库;PyTorch 路径加载 Fashion MNIST 需要 torchvision,画曲线同样可能要绘图库。缺 torchvision 时,torch 能 import,数据集类却没有,错误看起来像「PyTorch 没装好」。分流:能加法说明核心包在,缺数据集类说明视觉附属包不在。不要为此重装 torch。Colab 预装情况随镜像变化,仍以当前会话里能否 import 为准,不要凭上周的记忆跳过验收门。
三道验收门再执行一遍:导入、加法、设备列表符合预期。pip 退出码为 0 不是第三道门。附属包缺了当附属包问题。GPU 不可用而计划用 CNN 分钟级看完,要接受 CPU 墙钟。内核与终端不是同一解释器。改 Module 后重新实例化并在 to 之后重建优化器。两套环境可以分开。记录版本字符串。混合精度本周关闭。这些是环境纪律,后面所有对照都假设纪律已执行。未执行而出现的 DLL 错误,不要写进框架对比结论。