4.3 训练循环对照
4.3 训练循环对照
本节摘要:Keras 用
fit走完训练、用evaluate报告测试损失与准确率、用predict得到概率再argmax。PyTorch 用双重循环:外层 epoch,内层 DataLoader;每步zero_grad、前向、criterion、backward、step;评估时eval加no_grad,用torch.max取预测类。两者执行的是第 2.5 节同一套五步。原文 Keras 常把validation_data交给 fit;原文 PT 每 100 个批次打印一次运行损失。对照时对齐 epoch 数、批次、学习率,再比较曲线,否则比较的是日志格式。
核心问题
阅读完本节,你应当能够:
- 把
model.fit(..., epochs=10)展开成与 PT 循环一一对应的步骤 - 写出 PT 评估循环中正确数与总数的累加,并解释为何要
no_grad - 对照预测:
np.argmax对torch.max(..., 1) - 列出三件必须写进循环模板的事:设备迁移、train/eval、清梯度
一边是函数,一边是试卷上的伪代码
教材里的训练伪代码从来都是双重循环。PyTorch 几乎原样落地,所以研究代码好对论文。Keras 把内层循环藏进 C++ / 图执行,Python 层只留 epoch 与回调。入门体验上,Keras 更快看到第一条准确率;理解上,PT 更快看到 backward 在哪一行。对照课要求你会双向翻译,而不是嘲笑某一边啰嗦。
原文 TF 训练:history = model.fit(train_images, train_labels, epochs=10),可加验证集。评估:test_loss, test_acc = model.evaluate(..., verbose=2)。预测:predictions = model.predict(test_images),看 predictions[0] 十个数,np.argmax 得类别,和 test_labels[0] 比。这些是 SOURCE 引言与 3.5 的具体动作,不是泛泛 API 列表。
原文 PT 训练:num_epochs = 10,model.train(),枚举 train_loader,解包 inputs, labels,.to(device),optimizer.zero_grad(),outputs = model(inputs),loss = criterion(outputs, labels),loss.backward(),optimizer.step(),running_loss += loss.item(),每 100 步打印 running_loss / 100 再清零运行损失。评估:model.eval(),with torch.no_grad(),torch.max(outputs.data, 1),累加 correct 与 total,打印百分准确率。预测示例用类别名字元组格式化四张图。同样是 SOURCE 原句级流程。
💡 关键直觉:如果你能在 Keras 的 progress bar 每一跳心里默念「这是一批五步」,你就已经在用对照方式读
fit了。
并排模板与必须对齐的旋钮
| 旋钮 | Keras 原文 | PyTorch 原文 | 公平对照 |
|---|---|---|---|
| epoch | 10 | 10 | 相同 |
| 批次 | 数组 fit 有默认;Dataset 则显式 | 64 | 改成同 64 |
| 优化器 | adam 字符串 | Adam lr=0.001 | 显式同一 lr |
| 损失 | sparse_categorical_crossentropy | CrossEntropyLoss | 检查 Softmax 次数 |
| 验证 | validation_data | 手写 evaluate 函数 | 每个 epoch 都要有 |
| 日志 | 每 epoch 一行 | 每 100 step | 画图用 epoch 点 |
Keras 也可以写自定义训练循环:Tape 包前向,tape.gradient,optimizer.apply_gradients。那时候两侧代码长度接近。原文入门不走这条,但你要知道它存在——否则会以为「TF 不能手写」。相反,PT 也有高层封装库把循环收走;本课不引入,以免第三条方言。
评估指标实现差异:Keras accuracy 对多分类是 argmax 后比较。PT 你必须自己写对。写错维度(torch.max 的 dim 不是 1)会得到离谱准确率。dim=1 表示在类别维取最大,批次维是 0。与 np.argmax(..., axis=1) 对应。单张图 predictions[0] 用 argmax 不带 axis 也可以,因为已经是一维十个数——原文 TF 预测第一张就是这样做。
设备:Keras fit 数组路径通常不用你写 to。PT 每批都要写。漏写只在 CPU 训练时碰巧能跑,换 GPU 立刻爆。模板里把 to(device) 放在解包后第一行,不要放在 Dataset 里。
⚠️ 常见坑:PT 循环里
loss.backward()之后忘记step,损失打印在下降(因为你算了损失)但权重不变,准确率随机。或step了但没zero_grad,等效学习率失控。Keras 侧对应坑是fit了没 compile,或 compile 了却在 fit 前又改了模型结构未重新 compile。
verbose=2 在原文 evaluate 出现:少打印进度条、仍出结果。Colab 里进度条刷屏时有用。这不影响数值。不要把 verbose 当成超参调。
history 对象让 Keras 用户天然拥有 epoch 级曲线。PT 用户要自己 append。5.3 诊断过拟合依赖这些点。对照课从第一轮训练就记账,不要只看最后打印的一个 test acc。
预测、回调、以及何时该手写
预测阶段两侧都不要更新权重。Keras predict 默认如此。PT 必须 eval+no_grad,否则 Dropout 抖动,且浪费显存。原文还演示从 test_loader 取一批 next(dataiter) 打印四张的预测名与真实名。类别元组仅用于显示。模型仍然输出索引。
回调是 Keras 给封装循环开的窗:早停、存盘、调学习率。PT 把窗变成你写的 if。功能一一对应,不是 Keras 独有魔法。ModelCheckpoint 放到 4.4。早停:验证准确率若干 epoch 不升就 break 或 stop_training。原理仍是 2.5 的「停止更新」。
图 封装边界:同一五步,切口不同
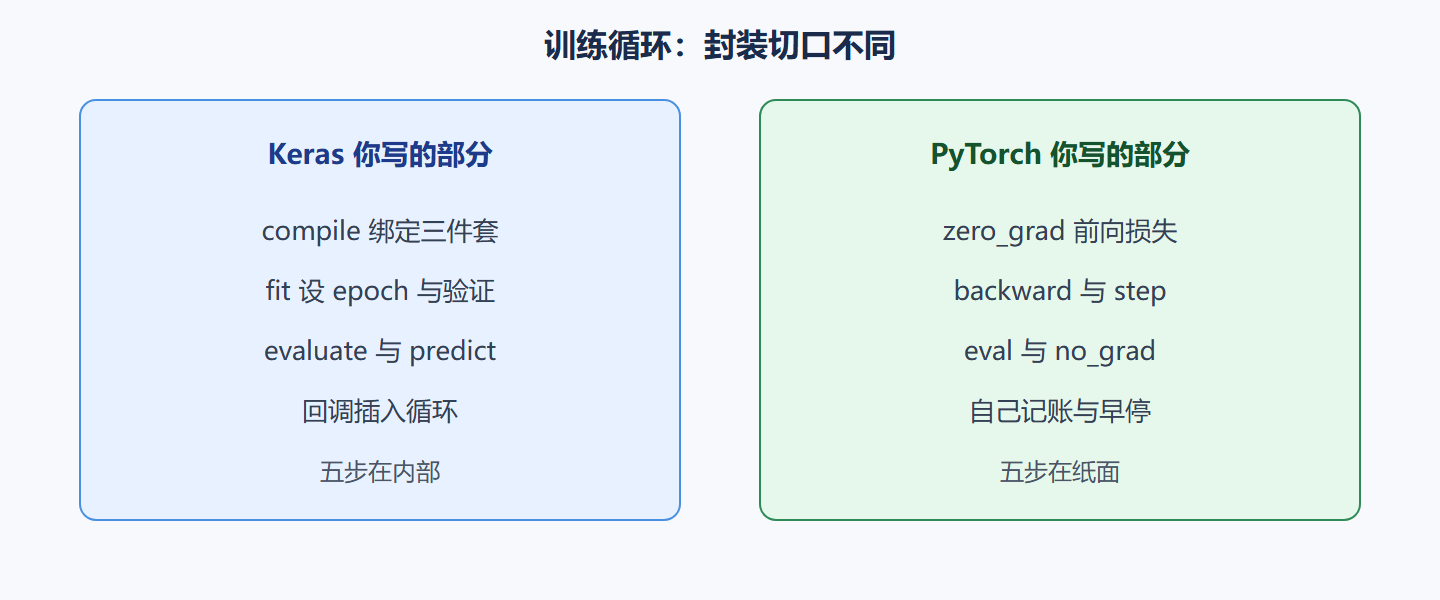
何时必须手写(即使你爱 Keras):对抗训练、每步改损失权重、梯度裁剪要插在 backward 与 step 之间、与非 Keras 组件交替更新。那时用 Tape 循环。何时不必手写:标准分类、标准验证、标准早停——fit 更少出错。原文入门任务属于后者。本课仍要求你读懂前者,因为对照的目标是互译,不是让你把 PT 也写成伪 fit。
运行损失 running_loss / 100 是 100 个批次的平均,不是 epoch 平均。和 Keras 一个 epoch 的 loss 粒度不同。画对照曲线要用 epoch 级:PT 在 epoch 末用全部训练批次再平均一次,或对 running 做正确加权。不要把 100-step 的点直接叠到 Keras 的 epoch 点上,横坐标都对不齐。
最后,关于「PT 更慢」的观感:Python 内层循环有开销,但 Fashion MLP 的瓶颈通常不在这里。真差距来自数据管线、GPU 核、以及是否用了编译加速。入门不要用墙钟时间给框架判死刑。用测试准确率、曲线形状、以及你能否指出每一行对应五步中的哪一步来判。
日志、梯度裁剪与混合精度先别上
梯度裁剪插在 backward 与 step 之间,是 RNN 类任务的常客,Fashion MLP 很少需要。一上裁剪就多一个超参,对照又难。损失爆炸时先降 lr、查归一化。混合精度能加速 GPU 训练,也会改变数值,入门对照关闭。等基线稳定且你确认瓶颈在计算,再按官方 AMP 文档开,并单独记一次实验。
日志频率原文 PT 每 100 步。60000/64≈938 步每个 epoch,大约打 9 行。Keras 默认每个 epoch 一行带进度条。把 PT 的 100 步平均换算成 epoch 平均再画图:对 100 步的 running_loss 再按步数加权,或在 epoch 末单独算一遍训练集损失(更贵)。图上横坐标只标 epoch,避免 100-step 点与 epoch 点混在一张图上误导 5.3 的过拟合判断。
train_on_batch / test_on_batch 是 Keras 的半手写接口,适合你想保留 compile 绑定又想插入自定义逻辑。它仍比 Tape 循环短。需要 Tape 的标志是:你要碰到梯度张量本身(裁剪范数、梯度惩罚)。只想在每个 batch 后改学习率,用回调或 train_on_batch 循环即可。
问题:验证每个 epoch 做一次会不会太慢?
Fashion 测试一万张,评估比训练便宜得多,因为无反向。每个 epoch 评估一次完全可接受,也是早停的前提。若评估集极大,可以每个 epoch 抽一个固定子集,但子集必须固定,否则曲线抖来自抽样。不要为了「快」完全不验证,那是在闭眼训练。PT 评估循环写得笨(Python 累加)在一万张上仍然很快。先正确,再谈把评估搬到 GPU 的细节。
把 Keras 的 history.history['loss'] 和你在 PT 里 append 的 train_losses 画在同一张示意图上时,只使用 epoch 级点。若 PT 只有 100-step 的 running_loss,先在 epoch 末用训练集再跑一遍前向算平均损失(eval+no_grad,不算更新),成本可接受。不要把 9 个 100-step 点硬压缩成一个 epoch 点却不说明算法。5.3 的过拟合判断对横坐标敏感:误把 step 当 epoch,会以为「第 3 个点就开始过拟合」,其实才过了 300 个批次,连一个 epoch 都不到。
criterion 与 model 都要和数据在同一设备。损失模块本身若有参数(有的损失有),也要 to(device)。CrossEntropyLoss 通常无参数,忘了 to 在 CPU 模型上仍能跑,换 GPU 有时会报设备不匹配。模板里写上 criterion = nn.CrossEntropyLoss().to(device) 省事。Keras 的损失在 compile 里,设备由框架管。又一次:能力相同,切口不同。
原文 PT 评估用 outputs.data 再 torch.max。现代写法更常在 no_grad 里直接 torch.max(outputs, 1)。两者在入门语义上等价。对照时认「在类别维取最大索引」,不要和 Keras np.argmax(..., axis=-1) 吵属性名。第一张图的十维向量,TF 原文打印整个概率分布,适合建立「不是只输出一个整数」的直觉;PT 原文打印四张的类别名,适合建立「索引到名字」的直觉。两种打印都做一次,收获不同。
要点速记
- 同一五步:fit 隐含,PT 显式;翻译比站队重要
- 原文数字:10 epoch;PT batch 64、每 100 步打印、Adam 0.001
- 评估三件套:eval、no_grad、argmax/max;Keras evaluate/predict 已封装
- 模板纪律:to(device)、train/eval、zero_grad 缺一不可
- 记账粒度:对齐到 epoch 再画对照曲线
- 手写的正当理由:要在 backward 与 step 之间插入自定义逻辑时再用 Tape/循环
循环对照验收:两侧 epoch 都是 10,批次都是 64,Adam 都是 0.001,损失约定已按 2.4 检查。PyTorch 模板含 to、train、zero_grad、backward、step;评估含 eval 与 no_grad。日志换算到 epoch 再画图。漏 step 时用权重均值变化揭穿。Keras verbose 不是超参。自定义循环只在需要碰到梯度张量时才上 Tape。验证每个 epoch 一次,Fashion 评估集很小。预测阶段 argmax 与 torch.max 在类别维上对齐。把模板空跑通过当作进入第 5 章的门票,门票不是测试准确率。
把漏写清单当成循环节的默写:漏 to,CPU 碰巧能跑 GPU 立刻炸;漏 train 或 eval,有 Dropout 时验证抖;漏 zero_grad,等效学习率失控;漏 backward,权重不变但损失仍打印;漏 step,同上;漏 no_grad,验证吃显存。六漏对应六条模板行,抄写时逐行打勾。Keras fit 把六漏收成 compile 与 fit 两行,漏 compile 会吵,漏把数据传进 fit 会形状错。自定义 Tape 循环会把六漏重新展开,那时回头看本节清单。墙钟比较禁止在打印每步损失时进行。epoch 级记账才能和 history 对齐。criterion 与模型同设备。outputs.data 与直接 max 在 no_grad 下等价,认动作不认属性名。早停是政策不是新传播算法。需要碰到梯度张量再手写,标准分类不必为了「更专业」拒绝 fit。
把六漏清单抄在循环模板上方,每跑一次空跑打一遍勾。勾不齐不准进 Fashion。Keras 用户把六漏理解成 fit 内部事件,仍要能在纸上展开,否则读不懂 PyTorch 仓库。PyTorch 用户不要因为会写六行就拒绝 Keras,交付曲线给非算法同事时 fit 更少出错。两种能力并存才是对照目标。记账只在 epoch 末写入四条列表。100 步打印只供人看,不供画对照图。墙钟比较关掉打印。验证每个 epoch 一次。预测用 argmax 或 max 在类别维。需要梯度张量再 Tape。标准分类不必表演手写。
把六漏勾完当作循环节毕业。毕业之前的 Fashion 成绩不入报告。毕业之后,Keras 用户应能展开 fit,PyTorch 用户应能在交付场景选择 fit 同类封装或继续手写。并存是目标。epoch 记账。验证每轮一次。需要梯度张量再 Tape。毕业标准与准确率无关。
审查空跑日志里有没有出现 NaN 或负数准确率。负数说明你把正确数减反了。NaN 说明约定或 lr。两种都禁止进入真数据。真数据不会修复空跑失败,只会把失败画成更长的曲线。更长不是更真。真是有限损失加变化的权重。这两项在随机张量上就必须成立。成立之前不要下载数据集,下载会把网络问题混进来。
循环节毕业是六漏勾齐加 epoch 记账四条列表已经有位置。位置可以是空列表,但不能没有变量。没有变量,5.3 会要求你回忆损失,回忆不是曲线。曲线必须事先准备好容器。容器在本节准备。准备好,才允许 Fashion 往容器里填数。容器名字四件套不要改。改了 5.3 会对不上 Keras 的 history 键。对不上就无法画对照图。
下一节对照如何把跑完的权重留下,以及留下之后能去往服务端、移动端还是仅能再
load回来继续玩。