4.4 保存加载与部署对照
4.4 保存加载与部署对照
本节摘要:训练不是终点。Keras 可用
model.save把结构、权重、优化器状态写入 SavedModel(默认)或 HDF5;也可用save_weights只留参数。加载用load_model或先重建结构再load_weights。ModelCheckpoint在 fit 时按验证指标自动留最佳。PyTorch 原文推荐保存state_dict,加载时先构造同结构的nn.Module再load_state_dict;整模型torch.save(model)能做但不推荐。部署上,TF 传统分叉 Serving / Lite / 网页端;PT 常见路径是状态字典进自有服务或经中间格式导出。入门先保证「存得回、加载后预测一致」,再谈端侧。
本节地图
阅读完本节,你应当能够:
- 说明整模型保存与仅权重在「换代码结构再加载」时的不同命运
- 对照 Keras SavedModel/HDF5 与 PT
state_dict各含什么 - 配置一个「只保留验证最优」的检查点策略
- 按目标环境(仅 Python 续训 / 服务端 / 移动)选出更顺的导出故事
保存到底在保存什么
权重是张量。结构是层怎么连。优化器状态是 Adam 的缓冲。训练超参、预处理均值,常常根本不在模型文件里——这是两边共同的坑:你加载了网络,却用错了 Normalize,预测就漂。对照课把「预处理合同」与权重一起记,而不是幻想 save 函数什么都包。
Keras model.save 默认 SavedModel:一个可恢复的目录式产物,含图与变量,适合后续 Serving。HDF5 是单文件旧格式,原文仍支持 save_format='h5'。仅权重:save_weights,加载必须自己把 Sequential 再写一遍,结构稍改就对不上。原文 3.6 把这三种都写了,并演示加载后 summary 应与原模型一致,以及用加载模型 predict。
PyTorch 的 state_dict 是名字到张量的有序字典:fc1.weight、fc1.bias……原文推荐存这个,因为类定义可能变,字典仍可手工映射。加载:model = SimpleNN(),load_state_dict(torch.load(...)),再 to(device)。保存整模型会把类和 pickle 绑在一起,换环境、换类定义位置就脆。原文验证加载成功的方式包括比较参数或再跑测试预测。
💡 关键直觉:只存权重,是在赌「将来的代码还能长出同一棵层树」。赌得过就文件小、灵活;赌不过就加载报 key 不匹配。
检查点、续训、设备
ModelCheckpoint 原文用法:路径格式字符串可含 epoch 与指标;save_best_only 只留验证准确率最高的一份;作为 fit 的 callbacks。训练结束去检查点目录找最佳,重建模型,load_weights,再 evaluate。这是「不是最后一个 epoch 最优」的工程承认,和 5.3 过拟合诊断配套。PT 没有官方同名回调,你在评估后 if val_acc > best: torch.save(model.state_dict(), ...)。逻辑相同。
续训:Keras 整模型加载后可继续 fit,优化器状态若在文件里,Adam 不从头热身。PT 只存 state_dict 时,续训应另存 optimizer.state_dict() 和 epoch 编号。只加载权重再 Adam(...) 新优化器,前几个 epoch 行为会变。不是 bug,是你选择了「当新训练接着旧权重」。把选择写进实验日志。
设备:torch.load 默认试图把张量放回保存时的设备。在只有 CPU 的机器上加载 GPU 保存的文件,需要映射到 CPU。Keras 加载通常更少踩这个。对照时在无 GPU 的笔记本上打开同事的检查点,是 PT 用户的基本功。
| 需求 | 更顺的 Keras 路径 | 更顺的 PyTorch 路径 |
|---|---|---|
| 明天同一脚本续训 | model.save 整模型 |
权重 + 优化器 + epoch |
| 改了层名只想迁移部分权重 | load_weights 小心形状 |
state_dict 手工过滤 key |
| 给另一语言服务加载 | SavedModel → Serving | 导出或保持 Python 服务 |
| 移动端 | TF Lite 转换 | 移动端运行时或先转中间格式 |
| 最小文件只为推理 | 仅权重 + 另附结构代码 | 仅 state_dict + 类定义 |
⚠️ 常见坑:PT
load_state_dict默认严格模式,多一个 key 或少一个 key 就失败;有人strict=False吞掉错误,结果部分层仍是随机初始化还去报测试准确率。Keras 加载 HDF5 遇到自定义层没注册,也会在反序列化时倒。先让 strict 失败,再决定。
原文 TF 还演示保存后立刻加载、对同一批新数据 predict。数值因浮点与随机性不必 bit 级相等,但类别应稳定。若加载后准确率掉成随机,结构重建错了,或加载了未训练的检查点路径。路径管理用「实验名 + epoch + 指标」命名,避免覆盖。教程不写具体磁盘绝对路径,用检查点目录与文件名模式描述。
部署对照:导出之后去哪
选型节画过 TF 的三端:Serving 服务端、Lite 移动嵌入式、JavaScript 浏览器。这是历史重心,不是说 PT 不能上生产。PT 常见是:Python 进程里 eval+no_grad 提供服务;或导出到中间表示再进统一运行时。ONNX 一类格式两边都能走向,入门不配转换流水线,以免对照轴爆炸。你只需要判断:目标环境是否强制某种运行时。强制 Lite 就倾向 TF 训练或愿意付转换成本;强制某研究仓库的 PT 权重,就不要为了「公司以前用 TF」而在第一周重写网络。
图 保存物与去向
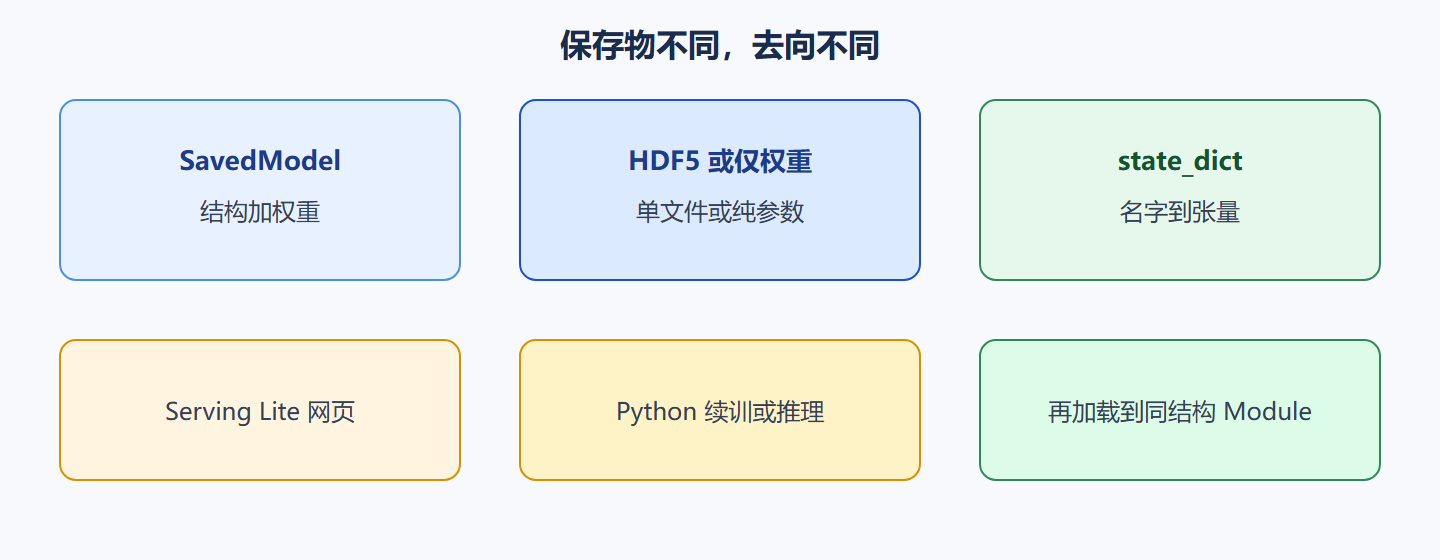
量化、剪枝、TensorRT 这类加速不在本课展开,相邻主题会有。这里只强调:导出格式决定了你能用哪些加速器工具链。SavedModel 与 Lite 有自己的转换器;PT 有另一套。入门模型 10 万参数量级,CPU 推理足够,不要为 Fashion MNIST 上加速器。
安全:torch.load 的 pickle 属性意味着不要加载不信任来源的检查点。Keras HDF5 风险面不同但仍不要随便来源。对照课不讲攻击细节,只把「权重文件是代码的亲戚」这句话留下。
与第 5 章的衔接:实战结束应留下一份最佳检查点,而不是只打印一次 test acc。报告里写:框架、预处理、epoch、验证最优还是最后一轮、文件里是整模型还是纯权重。没有这些字段的准确率数字,对照没有意义。
协作时检查点怎么交接
交接清单:框架与大致版本、模型类或 Sequential 代码、预处理(除以 255 还是 Normalize)、state_dict 或 SavedModel、是否含优化器、最佳 epoch、验证指标定义(accuracy 的样本集)。缺预处理这一项,加载方会用错输入分布,准确率掉一截还以为权重损坏。缺结构代码,PT 的字典无法变回 Module。把清单写成纯文本放在检查点旁边,不要只丢一个二进制文件。
strict=False 的正当用途是:新模型多了一层分类头,旧骨干权重仍能对上。不正当用途是:懒得看 key 不匹配。打印 missing keys 与 unexpected keys,确认符合预期再继续。Keras load_weights 的 by_name 类似,按层名对齐,层数变化时可能 silently 跳过。加载后立刻 evaluate,数字应接近保存前的验证指标。差很多就回滚,不要在坏权重上继续调参。
问题:SavedModel 能不能给 PyTorch 用?
不能直接当 state_dict 用。要跨框架,通常走中间表示转换,且算子覆盖不是百分之百。入门不要把「导出一次到处跑」当成已购买的能力。产品若强制单一运行时,在训练侧就选更顺的那条,或接受转换验证成本。本课双侧都保存自己的格式,对照的是流程而不是文件互通。
加密与签名超出范围,但「不要加载不信任的 pickle」足够当纪律。公司环境把检查点当制品管理,版本号与实验卡片一致,比在笔记本目录里堆 final_final2 更像工程。教学阶段用含指标的文件名已经比覆盖同一个 model.h5 强。
原文 Keras 检查点路径用格式字符串纳入 epoch 与 val_accuracy,这是 SOURCE 3.6 的具体写法。好处是目录里一眼能看出哪份最好;坏处是文件变多,要定期清理。save_best_only=True 减轻堆积。PT 自己维护 best_acc 变量,只覆盖一个 best_state.pt 风格的名字即可,同时在日志里记下当时 epoch。两种策略都能复现「验证最优」。不要一边保存 10 个文件一边只加载最后一个,那等于没做 best。
HDF5 单文件便于拷贝;SavedModel 是目录,拷贝时要整目录走。邮件发送检查点时注意这一点。PT 的一个字典文件最像「单文件」。协作时问对方「你发给我的是目录还是文件」,能避免一上午的加载失败。加载后做一次 evaluate 或测试循环,数字应接近保存前。若差到随机,结构重建失败或加载了未训练权重。先怀疑自己,再怀疑框架序列化。
导出到移动端前,确认用到的层在转换器支持列表里。入门的 Flatten、Dense、ReLU、Softmax、简单 Conv 通常支持。自定义 Python 控制流可能不支持。这会反向影响 4.1/4.2 的构建选择:若目标是 Lite,少写动态 if。研究原型则相反。部署对照的最后一句:先定目标运行时,再定训练侧能用多动态的图。
一节小结
- 三件可能被保存:结构、权重、优化器状态;预处理常常不在其中
- Keras:SavedModel 默认整存;HDF5 可选;weights + Checkpoint 管最佳
- PyTorch:推荐
state_dict;加载先建类;整模 pickle 脆 - 续训:要不要 Adam 缓冲,必须显式选择
- 部署分叉:TF 三端传统强;PT 以字典 + 服务或导出为主;按目标运行时选
- 加载验收:summary 或参数名对齐,再跑一批预测,准确率不得掉成随机
下一章用 Fashion MNIST 把声明、管线、循环、保存串成可比较的双侧实战。
保存验收:加载后 summary 或参数名对齐,同一批预测类别稳定,验证指标接近保存前。Keras 分清 SavedModel 目录、HDF5 文件、仅权重。PyTorch 推荐字典,加载先建类,strict 先保持 True。续训要不要优化器缓冲必须写明。检查点文件名含指标,避免覆盖。部署先问目标运行时再选训练侧动态程度。不要加载不信任来源的序列化文件。预处理合同与权重一起交接。跨框架不直接互读检查点。入门模型不必上量化加速器。把「最佳验证」而不是「最后一轮」交给下一章报告。
加载后立刻评估,不要先继续训练。继续训练会把坏权重也往前推,你分不清是加载错还是后来训崩。评估接近保存前,再决定续训。续训若新建 Adam,写明「从旧权重热身、优化器失忆」。目录型 SavedModel 拷贝要整夹走。字典文件注意 pickle 来源。key 对不上先打印 missing 与 unexpected。Lite 转换前查算子覆盖,动态 if 可能挡住移动端。入门先保证 Python 里能 load。把最佳验证点交给第 5 章报告,最后一轮若不是最佳,不要用最后一轮对外吹牛。
把加载后先评估写成铁律。数字接近保存前才能续训。新建 Adam 必须声明失忆。SavedModel 拷贝整目录。strict 先 True。missing key 打印出来再决定。预处理合同一起交接。不信任来源不加载。移动端先查算子。Python 里能 load 是入门终点。最佳验证点进报告,最后一轮若更差就不要它。铁律比格式战争有用。格式战争留给真正要上 Serving 或 Lite 的那一周,不要占用 Fashion 的晚上。
把先评估后续训写成不可谈判。谈判会把坏权重推去更多 epoch。推过了,你无法证明加载曾经是对的。证明不了,4.4 等于没做。没做就不能进 5.3 的最佳点叙事。叙事缺保存,调参无法回退。无法回退的调参,不是调参,是随机游走。
审查加载评估的数据集必须与保存前评估的是同一划分。换划分得到的接近是巧合。巧合不能证明序列化正确。正确证明是同一划分、同一预处理、同一模型结构。三同一,数字接近,4.4 才毕业。
下一章用 Fashion MNIST 把声明、管线、循环、保存串成可比较的双侧实战。