第4章 模型与训练循环
第 4 章 · 模型与训练循环
章节摘要:本章把「模型如何声明」和「训练如何发生」并排放。Keras 提供 Sequential、函数式、子类化三条构建路径,入门以 Sequential 为主,函数式解决多输入。PyTorch 以继承
nn.Module、在__init__注册层、在forward写数据流为主。训练上,compile+fit+evaluate+predict对五步手写循环。保存上,SavedModel / HDF5 /save_weights对state_dict,并点到 Serving、Lite、导出这些部署分叉。读完你应能把一侧的训练代码翻译成另一侧,并选出适合续训还是适合交付的保存方式。
上手前先明确
阅读完本章,你应当能够:
- 判断何时 Sequential 不够、要换函数式或
forward里的 Python 控制流 - 实现一个最小
nn.Module分类器,参数被parameters()收集到 - 把
fit展开成清梯度—前向—损失—反向—更新,并写出 PT 对应代码 - 在整模型保存与仅权重之间做选择,说明续训还需要什么
核心概念速览
金句:声明模型是在说「有哪些层」;写训练循环是在说「层怎么被更新」——两边都可以很短,但短的位置不同。
图 本章从声明到交付
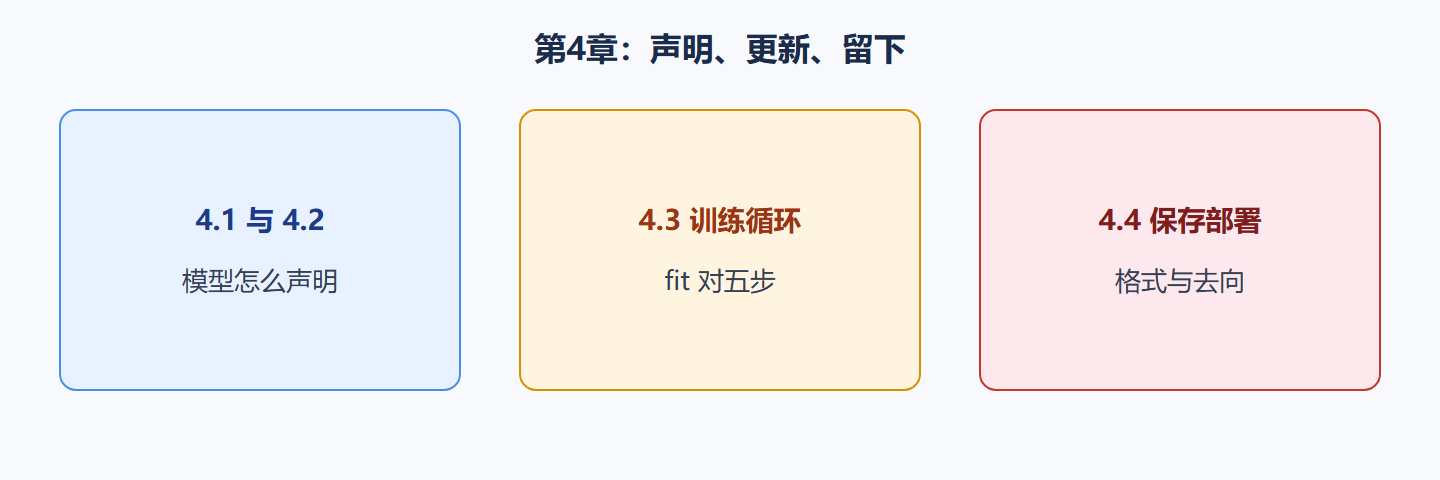
子章节导航
4.1 Keras 三种构建方式
Sequential 堆叠、函数式多输入、compile/fit 在构建之后立刻能用。
4.2 nn.Module 构建方式
__init__ 与 forward、train/eval、把模块挂到 self 才能被注册。
4.3 训练循环对照
Keras 训练评估预测三件套,对 PT 手写循环与 no_grad 评估;吸收 Sequential 分类与 PT 循环原文细节。
4.4 保存加载与部署对照
SavedModel、HDF5、权重检查点、ModelCheckpoint,对 state_dict;部署路径只对照到「导出后去哪」,不展开集群。
本章怎么对照着读
把 4.1 的 Sequential 列表和 4.2 的 SimpleNN 当场互译一次,不要等第 5 章。互译卡在 Softmax 位置,说明 2.3、2.4 的约定没进长期记忆。4.3 建议对着原文循环逐行标注「这是五步里的哪一步」,包括 zero_grad 这一步半。4.4 至少做一次「存了再加载、再 predict 同一批」,数值类别应稳定。加载失败时先看结构是否重建,再看路径是否指向未训练文件,最后才怀疑框架。
若时间不够,优先保证 4.3 模板能在 CPU 上空跑一个假批次(随机张量),再进第 5 章真数据。空跑能暴露设备与 shape 问题,比一上来下载数据集更干净。
子章节之间的逻辑关系
先会声明,才会谈更新;先会更新,保存才有意义。部署是保存格式的消费者。
| 节 | 切口 |
|---|---|
| 4.1 与 4.2 | 模型怎么声明 |
| 4.3 | 五步谁来写 |
| 4.4 | 留下什么格式 |
4.1 Keras声明 ─┐ ├─► 4.3 循环对照 ──► 4.4 保存部署 4.2 Module声明─┘
前置知识与后续延伸
- 前置:第 2 章层与五步原理、第 3 章如何取出批次
- 后续:第 5 章用同一 Fashion MNIST 把两侧声明+循环跑成可比较的曲线
本章是对照轴里「最像在写框架代码」的一章,也是封装差异最刺眼的一章。Keras 用户在 4.1 会觉得顺,到 4.3 看见 PyTorch 那五步会嫌烦;PT 用户在 4.2 会觉得顺,到 4.1 看见 compile 会问「优化器怎么跑到模型身上了」。这两种不适都正常。不适消失的标志是:你能把 fit 在白纸上展开,也能把五步收成「相当于一次 fit」。做不到就还在背两套咒语。
保存一节常被当成附录。请不要。没有检查点,第 5.3 节的「最佳 epoch」只是口头禅;没有分清整模型与仅权重,协作时会把一个 HDF5 丢给只会 load_state_dict 的人。部署三端(服务、移动、网页)在入门任务上不必真做转换,但要能回答「假如产品经理明天要上手机,我更可能从哪条训练路径出发」。答「都可以随便」的人,通常还没读 1.2 的历史重心。
建议的阅读节奏:4.1 与 4.2 同一天左右对照着读,当天就把 MLP 结构互译一遍;4.3 单独安排时间把循环模板抄进笔记本;4.4 在第一次 fit 跑完之后立刻做,不要等「以后要部署了」再学保存。保存是训练的一部分,不是训练的下游项目。
Keras 与 PyTorch 在这一章还会暴露「错误发生的时间点」不同。Sequential 写错 input_shape,往往在 summary 或第一次 fit 就爆。nn.Module 写错 view 的 784,可能在第一个批次才爆。函数式多输入接错,Keras 在构造 Model 时就可能抱怨;PT 在 forward 里 torch.cat 维度不对,也是运行时。对照调试时,不要用「哪边报错更早」判断哪边更好,那只是静态声明与动态执行的差异。把报错时间点写进预期:TF 偏声明期,PT 偏第一次前向。预期对了,心态才稳。
本章与第 5 章的分工:这里把模板抄熟,那里把真数据填进去。不要在第 4 章就开始调 Fashion 的 Dropout,也不要在第 5 章才第一次写 zero_grad。模板空跑用随机张量,真数据用契约卡片,两段实验目的不同,混在一起会让你分不清失败来自 API 还是来自像素范围。
声明、循环、保存是同一条流水线的三段切口。Keras 把循环切口藏进 fit,把保存切口做成 model.save;PyTorch 把循环切口摊在纸上,把保存切口做成 state_dict。不要用切口的显眼程度判断能力高低。本章结束时的验收是:随机张量空跑一个批次不报错,参数在一步之后确实变化,存盘再加载后预测类别稳定。三项过了再进第 5 章填真数据。空跑与真数据混做,失败原因会纠缠到无法对照。
空跑门票用随机张量,不要用 Fashion。目的是验证声明与循环,不是验证数据契约。数据契约是第 5 章的门票。两张门票分开买,失败才能分开修。
本章也不引入第三种高层封装去把 PyTorch 循环再藏起来。对照的意义就是看见切口。藏起来等于删掉 4.3。需要封装时,等你能手写五步再选。