3.3 数据管线对照与取舍
3.3 数据管线对照与取舍
本节摘要:
tf.data用一条转换链描述从样本到批次;PyTorch 用 Dataset 加 DataLoader 两个对象描述同一件事。意图上几乎一一对应:切片创建对__getitem__,map对 transform / getitem 内预处理,shuffle对 DataLoader 的 shuffle,batch对batch_size,prefetch对 workers 加 pin_memory 的组合。取舍不看哪边「更现代」,而看数据是否已在内存、是否要随机增强、以及训练循环是fit还是手写。Fashion MNIST 这种小数组,两条管线都可以简化,但对照学习仍建议都写一遍,以免换大数据时只会其中一种方言。
本节目标
阅读完本节,你应当能够:
- 画出两边从「一条样本」到「一个批次」的对应步骤
- 说明预处理放在 map/transform 而不是训练循环里的理由
- 对内存小数据集给出「可以简化」的条件,避免为了仪式搭过重管道
- 列出对照实验必须对齐的三项:批次大小、打乱与否、输入取值范围
同一意图的双语词典
把管线当成翻译练习。左边 TF,右边 PT,中间是意图。你会发现没有哪一边缺「组批」这种能力,缺的是默认发生的位置。Keras fit 吃 NumPy 时,组批发生在 Keras 内部,你甚至可以不写 tf.data;PT 几乎总要 Loader,因为循环是你写的。这不是 PT 更麻烦,是封装边界不同——和第 4 章 fit 对手写循环是同一哲学在数据侧的投影。
| 意图 | tf.data | PyTorch | 对照时怎么对齐 |
|---|---|---|---|
| 定义一条样本 | slices 之后的元素 | __getitem__ 返回值 |
都不要带批次维 |
| 预处理 | map |
transform 或 getitem 内 |
随机增强不要进梯度 |
| 打乱 | shuffle(buffer) |
shuffle=True |
训练集开,测试集关 |
| 组批 | batch(n) |
batch_size=n |
统一 64 |
| 重叠准备 | prefetch |
workers + pin_memory | 小模型收益有限 |
| 接到训练 | fit(dataset) |
for batch in loader |
验证集单独一条 |
缓冲区打乱对索引打乱是细微差别。tf.data.shuffle(buffer) 从缓冲窗口抽,窗口小于全集时不是均匀置换。DataLoader 默认对索引做一轮置换,更接近「每个 epoch 全打乱」。内存放得下时,把 TF 缓冲设成样本数,两边统计上接近。写进对照笔记:若一边窗口 1000、一边全打乱,不要把准确率差归到框架。
预处理的取值范围是第三节的主角。Keras 原文除以 255.0,像素落在 0–1。torchvision 原文 ToTensor 已是 0–1,再 Normalize 0.5,大约 -1 到 1。同一 MLP 容量下,输入分布不同,最优学习率也可能不同。公平对照要么两侧都 0–1,要么两侧都标准化到同类统计量,并在表头写明。第 5.2 节实现时会再钉一次。
💡 关键直觉:管线对照的验收不是「代码看起来像官方教程」,而是「第一批张量的形状、dtype、min/max、标签编码」四件事一致或已知差异。
预处理放哪,增强放哪
训练循环里做 resize 和归一化也能跑,但会把五步弄脏,且难以在两侧复用同一函数。正确位置:TF 的 map,PT 的 transform。循环只拿准备好的批次做 2.5 节的事。增强(随机裁剪、翻转)同样放在管线,且仅训练集。测试集只做确定性预处理。有人在两侧都忘了关测试增强,准确率会抖,还以为是 Dropout。
缓存与增强冲突。TF cache 若包住随机 map,随机只发生一次。PT 没有同等的 Dataset.cache 默认,但有人把增强结果存成列表,犯同一错。规则:随机部分每个 epoch 现做;昂贵且确定的解码可以缓存。Fashion MNIST 已是现成数组,缓存收益接近零。
内存小数组:fit 直接吃 NumPy vs TensorDataset+Loader 磁盘大图: tf.data 读文件链 vs 自定义 Dataset 读文件 流式数据: from_generator vs IterableDataset
三种场景选管线重量。第一种,原文引言用 Keras 直接吃数组是合理简化;PT 仍需要 TensorDataset 或 torchvision 类,因为没有 fit。第二种才是管线真正赚回来的地方。第三种两边都更脆,入门避开。对照课要求你在第一种上仍碰一次完整管线,只为了把词典背熟,不是因为 Fashion 需要 prefetch 才能跑。
⚠️ 常见坑:一侧 batch 32、一侧 64,还比较 epoch 曲线的平滑程度。平滑程度强烈依赖批次。另一坑:一侧 shuffle 测试集,导致「每次评估准确率不同」被写成框架不稳定。
多进程与 prefetch 都是「让数据准备与计算重叠」。GPU 满载时它们重要;CPU 上训小 MLP 时,开 8 个 worker 可能更慢,因为进程开销大于 28×28 拷贝。原文 Windows 先 0 worker,不仅是稳定性,也是性能上的诚实:小数据不要表演并行。TF prefetch 成本较低,开着通常无害。策略:PT 先 0,需要时再 2;TF prefetch 1 或自动调优。
一张对照验收单
每次双侧实验,用同一张表打勾,比事后争论有用。表可以贴在笔记本第一格。
| 验收项 | 你要打印的东西 | 合格标准 |
|---|---|---|
| 批次形状 | 第一维 | 同为 64,或已知不同并记录 |
| 通道维 | 4D 还是 3D | 与模型输入声明一致 |
| 取值范围 | min/max 或均值 | 两边同分布,或记录 Normalize |
| 标签 | dtype 与取值 0-9 | 稀疏整数,不是 one-hot 除非损失配套 |
| 打乱 | 训练集连续两 epoch 首批是否相同 | 训练应不同,测试应相同 |
| 设备 | 批次 .device |
与模型一致,仅 PT 必查 |
图 管线对照:链条对双对象
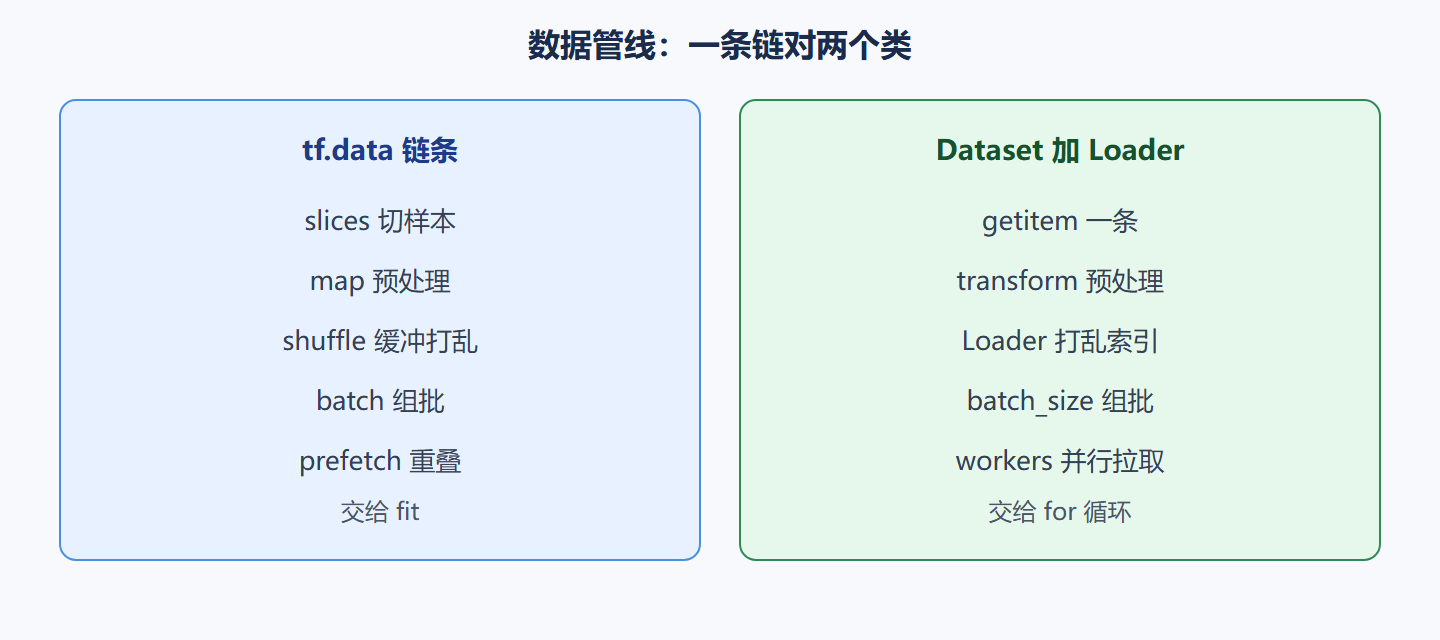
何时可以偷懒。教学演示、数据已在内存、不需要增强:Keras 直接 fit(x, y, batch_size=64) 合法。PT 用 TensorDataset 包数组,仍要 Loader,但可以不写自定义类。何时不能偷懒:样本变长、需要按文件名解析标签、增强依赖样本内容。那时两侧都必须上完整抽象,翻译表开始值钱。
与第 4 章的接口再强调一次。TF 管线的「消费者」可以是 fit,也可以是自定义训练里的 for x, y in dataset。PT 管线的消费者几乎总是 for 循环。自定义 TF 训练循环时,你突然发现自己在写和 PT 很像的东西——这正是对照课想要的时刻:封装卸掉以后,五步和取批次两边长得一样。
复现性:TF 有数据集选项与随机种子;PT 有 generator 参数给 DataLoader 以及全局种子。完全咬死两边每一个随机源成本很高,入门做到「种子固定后同一框架两次运行接近」即可。跨框架比特级一致不是目标。目标是差异可解释:来自 Normalize,还是来自打乱窗口,还是来自 Softmax 约定。
把管线写进实验卡片的固定栏
除了模型超参,卡片应有「数据栏」:加载入口(keras.datasets 还是 torchvision)、是否除以 255、是否 Normalize 0.5、batch、train shuffle、val shuffle、workers、是否从训练再切验证。缺一栏,三天后期末无法解释为何数字变了。框架对照比单框架实验更需要这栏,因为默认值两侧不同,记忆会骗人。
增强策略若两侧不一致,更是灾难。Keras 有 ImageDataGenerator 或 Dataset map 里的随机翻转;PT 有 transforms.RandomHorizontalFlip。服装数据集水平翻转通常可接受,垂直翻转会把靴子倒过来,语义坏掉。本课基线关闭增强。若你要开,两侧用同一概率、同一变换集合,并只加在训练管线。测试与验证关闭。写进数据栏的「增强:无 / 水平翻转 p=0.5」比写进模型栏更正确——它改的是数据分布。
问题:内存放得下时,tf.data 是不是浪费?
对 Fashion 这种已在内存的数组,直接 fit(x,y) 更短,性能差异可忽略。仍建议你写一次 from_tensor_slices 链条,当作翻译练习。浪费的是十几行代码,换来的是以后文件数据到来时不用重学。PT 没有同等的「直接 fit 数组」,TensorDataset 已经是最小仪式。不要因为 TF 能偷懒就嘲笑 PT 必须 Loader;那是封装边界,不是性能高下。真要抠 CPU 占用,再 profile,不要用观感判。
把「第一批张量」当成管线的单元测试,写成固定单元格:打印 shape、dtype、min、max、labels[:8]。Keras 从 Dataset take(1) 取;PT 从 next(iter(loader)) 取。两次打印贴在一起看。通道维不同是预期(3D 对 4D),取值范围必须是你卡片上写的那种。标签必须是 0–9 整数。这一单元格不过,禁止 fit 和禁止进入训练循环。它比任何 prefetch 参数都更能决定对照是否成立。
打乱的可复现:TF 在 Dataset 上设种子选项;PT 给 DataLoader 传 generator。完全对齐成本高。最低要求是评估集不打乱,这样错例的「第 3 张」今晚明天是同一张。训练打乱则应每个 epoch 不同,否则你在用固定顺序的 SGD,动力学变了,还拿来和另一侧带 shuffle 的曲线比。卡片上写「train shuffle yes, val shuffle no」,实现里核对,不要凭记忆。
重点提炼
- 意图可翻译:样本、预处理、打乱、组批、重叠、接入训练,六行对照表足够日常
- 封装边界不同:Keras 可直接吃数组;PT 循环需要 Loader
- 公平对照三件套:batch、shuffle 策略、输入取值范围
- 增强只在训练管线:测试确定性预处理;cache 不要冻住随机
- 小模型先正确后并行:Windows workers=0;prefetch 可常开
- 验收打勾:形状、通道、min/max、标签、打乱、设备
下一章进入模型怎么声明、训练循环谁来写、以及保存格式怎么选——对照轴的后两段。
对照验收单六行都要打勾才能进入第 4 章空跑:批次、通道、取值范围、标签编码、打乱策略、设备。缺通道勾,CNN 会炸;缺取值范围勾,准确率差两个点会变成框架神话;缺打乱勾,曲线平滑度不可比。增强若开启,只在训练,两侧同一概率同一变换。内存小数组允许 Keras 直接 fit 数组,但打印批次这一格不能省。跨框架比特级一致不是目标,可解释的差异才是。把验收单抄进第 5 章实验卡片的数据栏,不要另发明一套字段。
取舍的最后一句:封装边界不同,不是道德不同。Keras 能直接吃数组,是因为 fit 内部会组批;PyTorch 循环是你写的,所以需要 Loader。不要嘲笑哪一边仪式多。真项目里文件数据到来,两边都要上完整抽象,翻译表开始值钱。此刻用 Fashion 把表背熟。验收单六行是出门证。出门证和实验卡片数据栏是同一张纸的两面,不要各写各的字段名,否则 5.2 对不上 3.3。跨框架不追求比特一致。可解释差异来自 Normalize、打乱窗口、Softmax 约定,这三件事在管线与模型边界上,正好由本章与第 4 章分担。
把验收单六行印在第 5 章卡片数据栏,字段名不要改。改名会导致 5.2 对不上。封装边界那句话再读一次:仪式多的那边不是落后,是切口靠用户更近。文件数据到来两边都要完整抽象。跨框架不比特对齐。可解释差异三件套:Normalize、打乱窗口、Softmax 约定,分别由管线章与模型章分担。出门证与卡片同一张纸。这张纸比任何 workers 数字重要。
把六行验收单执行成打勾而不是阅读。打勾在打印之后。打印在训练之前。训练之前的勾比训练之后的准确率更决定对照是否成立。成立了,才允许讨论哪边仪式多。仪式多不是落后。这句话可以当本章金句引用。金句后面跟着出门证,出门证不过金句无效。
审查六行勾是否来自打印而不是来自记忆。记忆会把上周的 Normalize 当成这周的。打印是这一次运行的事实。事实才能对照。对照不是回忆录。回忆录里的框架差异通常是记混了默认值。默认值必须当场打印。
下一章进入模型怎么声明、训练循环谁来写、以及保存格式怎么选——对照轴的后两段。