5.2 同一任务双侧实现
5.2 同一任务双侧实现
本节摘要:在 Fashion MNIST 上用相近容量实现同一个分类器,才能谈框架差异。Keras 原文:Sequential 的 Flatten、Dense(128, relu)、Dense(10, softmax),compile adam + sparse_categorical_crossentropy + accuracy,fit 10 epoch。PyTorch 原文:
view到 784、Linear 128、ReLU、Linear 10、CrossEntropyLoss、Adam lr=0.001、手写循环 10 epoch、batch 64。简单 CNN 作为加分对照:KerasConv2D+池化,PTnn.Conv2d+MaxPool2d,证明换层不必换框架。实现后比较的是测试准确率与曲线形状,前提是预处理已对齐。
本节导航
阅读完本节,你应当能够:
- 默写出两侧 MLP 的层清单与损失优化器约定
- 指出 CNN 相对 MLP 改了哪些层、没改哪些训练步骤
- 列出对照实验记录里必须出现的字段
- 解释「一侧高两个点」时先查哪三件事再查框架
MLP 基线:把第 4 章接到真数据
Keras 侧按原文拼起来即可。数据除以 255。模型三层。fit 可传入验证。evaluate 得测试准确率。predict 看第一张的十维概率。到这里,你已经完成引言承诺的「第一个 TF 模型」。没有新算法,只有把 4.1 与 4.3 填上 5.1 的数组。
PT 侧按原文类定义 + 循环。注意 CrossEntropyLoss 与输出无 Softmax。device 对称迁移。10 epoch 后 eval+no_grad 算测试准确率。打印四张图的名字。到这里完成「第一个 PT 模型」。两边都完成后,对照才开始——单边完成只是安装验证的延长。
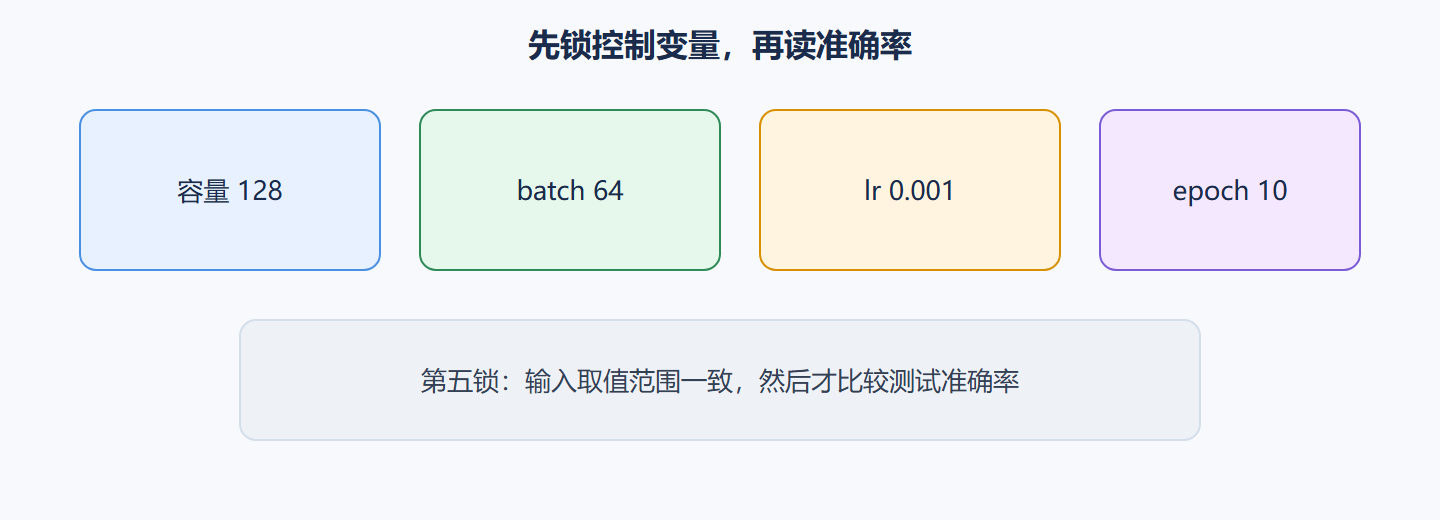
容量对齐:隐层都 128,输出都 10。不要一侧 256 一侧 64 还说框架更强。epoch 都 10。批次都 64——Keras 若直接 fit 数组,请显式 batch_size=64。学习率都 0.001 显式 Adam。这四条写进实验卡片。
预处理对齐是第五条,也是最常被偷掉的。若 Keras 0–1、PT -1–1,先不要比谁高。改成同分布再比。很多「PT 更低」来自 Normalize 把输入变了而学习率没变,或反过来。
💡 关键直觉:框架对照实验里,模型容量和数据分布是控制变量,框架是处理因素。控制不住,实验作废。
简单 CNN:换层不换五步
原文 5.2 / 5.3 给了 MLP 之外的卷积路径。意图:图像有空间结构,卷积共享局部权重,通常比展平 MLP 更适合。本课卷积保持简单:少量 Conv+池化,再 Flatten/view,再 Dense/Linear 到 10。不要在入门对照里上残差。
Keras:输入若是 (28,28),Conv2D 需要通道维,先 reshape 成 (28,28,1) 或 expand_dims。这是数组路径相对 PT 的额外一步。PT 的 ToTensor 已经给了通道。卷积核大小、滤波器数两侧要对齐,例如 32 个 3×3,再池化 2×2。填充默认 valid 时空间尺寸会缩小,summary 对一下。
训练步骤不换:仍 compile/fit 或五步循环。这是本章想钉死的迁移:换架构是换 Sequential 列表或 forward,不是换框架。有人一听 CNN 就「必须上另一套生态」,本课用同一优化器同一数据反驳。
| 模块 | Keras MLP | PT MLP | Keras CNN | PT CNN |
|---|---|---|---|---|
| 输入处理 | Flatten 28,28 | view 784 | 增通道维再 Conv2D | 已有通道 Conv2d |
| 隐层 | Dense 128 relu | Linear+ReLU | Conv+池化+Dense | 同结构模块 |
| 输出 | Dense 10 softmax | Linear 10 | 同左 | 同左 logits |
| 训练 | fit | 五步 | fit | 五步 |
参数量 CNN 不一定更大,因为卷积核共享。打印参数量,避免「我以为卷积更重所以更准」。更准通常来自归纳偏置,不是参数个数。若 CNN 反而更差,检查通道维、学习率是否仍 0.001、是否忘记把 Keras 输入改 4D。
原文 MLP 的 compile 行再次出现:optimizer='adam',loss='sparse_categorical_crossentropy',metrics=['accuracy']。CNN 同样这行,除非输出改 logits 才动 from_logits。PT CNN 仍 CrossEntropyLoss。不要 CNN 换套损失。
差异归因与实验卡片
跑完先看三个数:训练准确率、验证准确率、测试准确率。训练远高于验证:过拟合,去 5.3。三者都低:欠拟合或 bug(学习率、未归一化、标签错)。两侧测试接近(一两个点内):预处理对齐且容量相同的正常结果,随机种子就能解释。一侧随机水平(约 10%):那一侧图断了或损失约定错了,不是框架弱。
实验卡片字段 框架 / 模型 MLP或CNN / 预处理 / batch / lr / epoch 验证怎么划 / 最终是最优检查点还是最后一轮 测试准确率 / 备注 Softmax次数
⚠️ 常见坑:用测试集调 CNN 的滤波器个数,再报告同一测试集。教学演示可以,报告里要写。另一坑:Keras
fit的 shuffle 默认 True,你 PT 忘了 shuffle,曲线更抖或更差,归到框架。
图 控制变量后再比
代码保持概念性。Keras 列表声明三层;PT 类声明三步 forward。CNN 只多几行层。不要在教程里贴完整可运行仓库,平台也不要文件路径。读者应能根据本节表和前文章节把代码拼回来。拼不回来说明前面互译没完成,回来补 4.1–4.3,而不是在本章堆更多层。
衬衫类(索引 6)与 T 恤(索引 0)的错误,两侧都会有。若一侧完全不犯这个错,另一侧狂犯,先怀疑标签有没有对上类别名打印,而不是卷积实现。可视化错例比再加一层 Dense 更有信息量。
保存:本节结束至少 save 或 save_state_dict 一次。文件名含框架与 MLP/CNN。下一节调参会覆盖「最后一轮」,没有这版基线你无法知道调参是变好还是变差。
实现当天的操作顺序
先空跑一个假批次:Keras model(tf.zeros((2,28,28))) 看输出 (2,10);PT model(torch.zeros(2,1,28,28).to(device)) 看 (2,10)。再跑 20 个 step,损失应低于纯随机的交叉熵(约 ln(10)≈2.3)。若损失从第一步就是 NaN,停,查归一化与 lr。不要直接 10 epoch。空跑通过后再拉满,同时打开验证记账。
CNN 的 Keras 输入:train_images[..., None] 或 reshape 成四维。忘记这一步,Conv2D 报通道相关错误。PT 不要把 (N,1,28,28) 再 Flatten 到卷积前。卷积核 3×3、32 通道、ReLU、2×2 池化,再可能第二段卷积,然后 flatten 到全连接。两侧滤波器数一致。训练仍 10 epoch 先看,CNN 有时收敛更快,过拟合也可能更晚或更早,以曲线为准,不要假设「卷积一定更不容易过拟合」。
种子:同一框架内固定,便于你比较「加 Dropout 前与后」。跨框架不要求同一准确率。差两个点,优先写「可接受的实现差」;差十个点,当 bug。随机水平 10% 当断图。把这三条阈值写在实验卡片背面,避免情绪化解读。
问题:必须把两侧准确率训到一样吗?
不必。本课成功标准是流程可复述、差异可归因。强迫咬到小数点后三位会把你推向同时调十个超参,对照死亡。更有价值的是:两侧都过拟合了衬衫类,说明问题在数据与容量,不在框架。那才是对照课的收获。刷到 93% 而说不清预处理的人,并没有比停在 88% 但能讲清五步的人更完成教程。
实现时把 Keras 的 model.summary() 和 PT 的参数量统计贴在同一张卡片上。784×128+128 + 128×10+10 = 101770,左右应接近这个整数。差一个数量级,多半 Flatten 没生效或输入维写成了 28 而不是 784。差几十,可能是偏置没算或某一侧多了 Softmax 层(Softmax 无参数,所以更可能是多了一层 Linear)。参数量是形状契约的校验和,比第一轮准确率更早发现问题。CNN 换算更麻烦,仍建议打印总数,避免「我以为卷积很轻/很重」的错觉进入 5.3 的诊断。
原文 Keras 训练可以 validation_data=(test_images, test_labels)。你若跟着写,请在卡片上标注「验证=官方测试,仅教学」。更干净的实现是从 train 再切。PT 同样:不要把 test_loader 既当验证又当最终测试而不声明。双侧声明必须一致,否则「过拟合来得早晚」不可比——一侧在看测试,一侧在看从训练切出的验证,曲线横坐标含义已经不同。
循环内部的打印不要太勤。PT 原文每 100 步一次,足够看见下降趋势。每个 step 都打印会拖慢 Python 循环,让你误以为 PT 比 Keras 慢一个数量级。慢的是打印,不是反向传播。对照墙钟时间时关掉多余打印,或只在 epoch 末打印。
重点提炼
- MLP 原文结构:Flatten/view 784 → 128 ReLU → 10;Keras softmax+稀疏交叉熵;PT logits+CrossEntropy
- 旋钮对齐:容量、64、0.001、10 epoch、输入分布
- CNN 只换层:五步与损失不变;Keras 记得加通道维
- 10% 准确率是 bug:不是「Fashion 太难」
- 实验卡片:没有字段的数字不许进对照结论
- 留下基线检查点:供 5.3 比较调参
双侧实现验收:控制变量五锁——容量、批次、学习率、epoch、输入范围——都写在卡片上。MLP 结构 Flatten 或 view 到 784 再到 128 再到 10。Keras softmax 配稀疏交叉熵,PyTorch logits 配 CrossEntropyLoss。参数量接近 101770。假前向过门,短循环损失低于 ln(10),再拉满 10 epoch。CNN 只换层不换五步,Keras 补通道维。一侧 10% 当断图。差五个点以上先查控制变量。保存基线检查点。测试若当验证,卡片标注教学简化。打印不要每步都做以免墙钟误导。
CNN 对照时把空间尺寸变化写下来。3 乘 3 卷积无填充,28 会变成 26;2 乘 2 步幅 2 的池化再减半。两侧算完应为同一空间大小,再 flatten。一侧 same 填充一侧 valid,全连接输入维会对不上,有的实现会用自适应池化遮住这个问题,本课不用,以免隐藏形状错误。滤波器数 32 对 32,不要一侧 16 一侧 64 还比较框架。训练仍用同一 Adam 与同一 epoch 上限。CNN 若第一个 epoch 损失不降,先打印卷积输入 ndim,Keras 缺通道维是第一嫌疑。基线 MLP 检查点保留,CNN 另存,不要覆盖,5.3 需要两条曲线对比「换层」这一种处方。实验卡片上模型一栏只允许一个词:MLP 或 CNN,不要写 MLP 加了一点卷积。混装无法归因。种子在同一框架内固定,便于你比较加卷积前后;跨框架仍然允许两个点以内的抖动。超过五个点停下来查五锁,不要加层。
把五锁写成禁止事项:禁止一侧 batch 32 一侧 64;禁止一侧 0 到 1 一侧负一到一还不声明;禁止一侧 20 epoch 一侧 10 epoch 比最终点;禁止一侧 256 隐层一侧 128;禁止一侧字符串 adam 默认一侧 lr 0.01。五条禁止比五条口号好记。CNN 另开卡片,不与 MLP 混锁。假前向、短循环、满 epoch 三道门仍有效。短循环损失不降,不要满 epoch,否则你用墙钟购买一条从随机到随机的直线,还以为框架不行。直线的正确动作是停下来查 Softmax 次数与标签。参数量校验和在实现当天第一小时完成,不要放到画曲线之后。曲线好看但参数量差十倍,说明你比较的不是同一容量。
把五条禁止事项贴在实现当天的屏幕上。贴上之后还犯,就停笔写卡片:犯的是哪一条。卡片比准确率优先。CNN 另卡。三道门仍在。参数量校验和第一小时做完。做完这些,框架差异若还在五个点以外,才允许怀疑实现细节,仍然不允许怀疑「某一框架不会分类」。分类能力两边都有,差异在约定。
审查实验卡片五锁是否写了具体数字而不是「默认」。默认在两侧含义不同,写默认等于没锁。没锁的实验禁止进入 5.3 诊断。诊断建立在可比曲线上。不可比曲线上的过拟合是幻觉。幻觉会让你开错处方。错处方比不调参更坏,因为它污染了基线。基线一脏,整章作废。作废之后只能回到五锁,不能靠再加一层卷积挽救。
实现节毕业不是 10 个 epoch 跑完,而是卡片五锁有数字、参数量接近心算、假前向过门、基线检查点已留下。四项缺一,5.3 开门就会把你的脏基线当成病人来开药。开药给脏基线,是对照课里第二贵的错误,仅次于骂框架。第三贵是覆盖基线检查点。覆盖了就没有对照的「之前」。没有之前,调参叙事无法开始。
下一节读曲线:过拟合还是欠拟合,以及第一轮只动哪几个旋钮。