5.3 结果分析与调优
5.3 结果分析与调优
本节摘要:训练结束不等于完成。要同时看训练集与验证集的损失、准确率:两者一起变好是健康学习;训练继续变好而验证变差是过拟合;两者都差是欠拟合或实现错误。原文 5.4 把诊断放在调参之前:先读曲线,再动容量、正则、epoch、学习率。第一轮调参只改一个旋钮,并与 5.2 的基线检查点比较。最终报告测试集一次,并写明用的是验证最优还是最后一轮。
读前必看(上)
阅读完本节,你应当能够:
- 从四条曲线(训练/验证 × 损失/准确率)判断健康、过拟合、欠拟合
- 列出第一轮允许的调参动作,并拒绝同时改四个旋钮
- 说明 Dropout、早停、减小模型如何对应过拟合
- 把「最佳检查点」写进对照报告,而不是只报最后打印的 test acc
曲线比最后一个数字诚实
原文强调:训练指标说模型有没有记住训练数据;验证指标说泛化。理想情况两者同向。Keras 看 history;PT 看你每个 epoch append 的列表。没有验证曲线,你只是在看模型背书的进度。
过拟合:训练损失下降、训练准确率上升,验证损失上升、验证准确率停滞或下降。Fashion MNIST 上 MLP 很容易在 10 epoch 内开始显露。这不是框架故障。欠拟合:训练准确率也低,曲线平。可能模型太小、学习率太小、没归一化、忘了 step。先用训练损失是否下降区分「没学」和「学过头」。
随机水平约 10%。若验证 11%,不要调 Dropout,去查标签和 Softmax 次数。若训练 99% 验证 85%,才进入过拟合工具箱。两侧用同一诊断树,不要一侧说「还要再训」一侧说「已经过拟合」却看的是不同划分。
💡 关键直觉:调参是对诊断的处方。没有诊断的调参是同时给病人开四种药。
第一轮旋钮:少而可逆
原文提到更复杂模型(CNN)、正则、学习率调度、批次归一化等,作为展望。本课第一轮只开放这些:
| 诊断 | 优先动作 | 不要同时做 |
|---|---|---|
| 欠拟合且训练也差 | 查归一化与 lr 是否过小;再加大宽度 | 一上来加 Dropout |
| 过拟合 | 早停;Dropout 小比例;略减小 128 | 再加两层卷积又加宽 |
| 曲线震荡 | 略降 lr 或略增 batch | 乱改损失 |
| 衬衫/T恤混淆 | 看错例;考虑 CNN | 改类别名 |
Dropout:Keras Dropout(0.2) 放在 Dense 后;PT nn.Dropout(0.2) 放在 forward 的 ReLU 后,且必须 train/eval 切换。只在过拟合时加。加了验证更差,撤回来,不要留着当装饰。
早停:验证准确率连续若干 epoch 不升就停,加载此前最佳权重。Keras 回调;PT 自己 best 变量。这是成本最低的抗过拟合。10 epoch 若最佳在第 4,报告第 4,不要报告第 10。
学习率调度原文列为后续。第一轮用固定 0.001。若震荡再减半。不要用复杂余弦去掩盖未对齐的预处理。
CNN 作为架构旋钮:在预处理已对齐的基线上,用 5.2 的简单卷积替换 MLP。通常验证会升,因为空间归纳偏置。若下降,回到通道维问题。架构改动也要单独一次实验,不要和 Dropout 同一晚。
⚠️ 常见坑:在测试集上看一眼准确率,不满意就改模型再看测试集。几次之后测试集变成验证集。对照报告会虚高。测试只碰最终那一次。
混淆矩阵比准确率细。十类里凉鞋、包、鞋子相对好认,上装难。两侧若难类集合不同,怀疑标签映射。难类集合相同,说明是数据难度,换框架不会消失。这是对照课想要的「共同的错」:证明你们在解同一题。
报告格式与本课边界
对照报告建议包含:数据契约(5.1)、控制变量(5.2 卡片)、四条曲线描述(不必上漂亮图,可以说「验证损失自 epoch 4 上升」)、最终测试数字、检查点类型(SavedModel 还是 state_dict)、未解决的混淆类。读者应能复现你的选择而不是你的运气。
图 诊断到处方
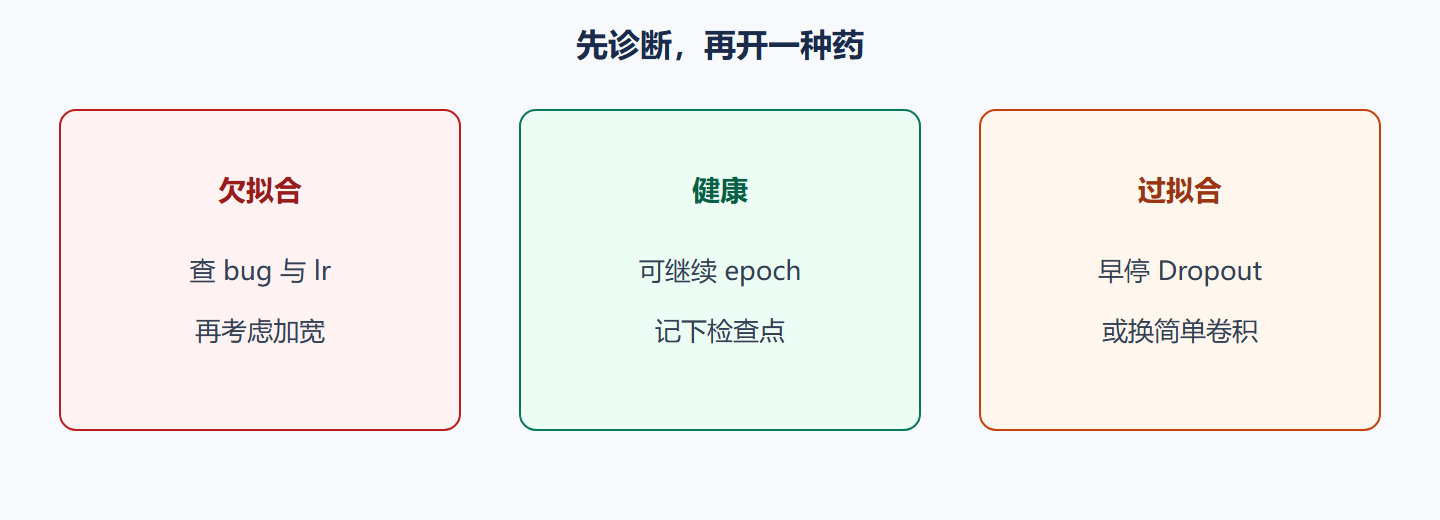
本课不做的事:超参搜索网格、AutoML、蒸馏、半监督。也不把测试准确率当成招聘指标。学完的证明是:你能在另一套框架里复述同一诊断并给出对应处方。若只能在 Keras 里点 EarlyStopping 却不会在 PT 循环里存 best,对照目标没达成。
与部署衔接:过拟合的模型不要急着转 Lite。先早停再导出。导出后的端侧准确率还可能再掉一点(量化),那是后话。本课把「验证最优权重」交给 4.4 的保存格式即可。
回顾全书五条轴:张量形状在 CNN 通道维再次出现;自动求导在你加 Dropout 后仍默默工作;管线决定增强有没有泄漏到测试;循环决定早停写在哪;保存决定别人能不能复现你的最佳点。实战章是五轴的汇合,不是另一本视觉书的开头。
若时间只够做一件调参:做早停。它不改模型定义,两边实现都短,直接针对过拟合诊断。第二件:对齐预处理后再比框架。第三件才是 CNN。这个顺序能避免「我把所有进阶技巧堆上去了但不知道哪件有效」。
错例阅读比再加一层更优先
从测试集或验证集里抽出模型判错的图,看是不是衬衫对 T 恤、外套对套头衫。若是,加宽度往往只把训练准确率再往上推,混淆结构还在。这时简单 CNN 比再叠一个 Dense(256) 更对症,因为它看局部针脚与领口,而不是把 784 像素当独立特征。若错例是随机的、各类都有,更像欠拟合或 lr 问题。若错例集中在某一侧独有,查标签映射与类别名打印是否用了同一顺序。原文十类元组的顺序必须与标签整数约定一致,写反一整列名字会造成「看起来蠢、其实只是图例错了」。
学习率衰减放在第一轮之后。验证损失已经上升时,衰减可能让过拟合来得稍慢,也可能只是让训练变慢。早停仍然更干净。调度器是第二轮工具。批次归一化同理:它改变训练动态,引入评估模式依赖,加载检查点时多状态。过拟合优先 Dropout 与早停,不要把 BN 当万金油。
问题:验证曲线比训练还好,是不是实现反了?
有时出现:Dropout 只在训练开启,验证关闭,验证准确率可以略高于训练。这不是反了。若高出很多,检查是否把增强只加在训练(正常)或是否验证集太小碰巧简单。若训练损失高于验证损失很多且训练准确率也低,才怀疑数据和标签是否接反、是否在训练循环里误用了 no_grad。诊断树把「训练是否在学」放第一位,不要第一眼就宣布过拟合。
报告里写清「验证最优 epoch=k,测试准确率=…,测试只评估一次」。Keras 与 PT 各一行。读者应能判断你有没有泄漏测试集。这比把数字印得很大更符合本教程的对照伦理。
把「只改一个旋钮」写成操作清单:从基线检查点加载,改 Dropout 或改宽度或换 CNN,重新训练同样的 epoch 上限(可配合早停),验证指标写入新卡片,测试仍不看。只有新验证优于基线验证,才允许碰测试一次。两侧实验各走一遍清单,不要 Keras 改了三处、PT 改了一处,还开总结会。对照的单位是「同一种处方在两套框架上的效果」,不是「我今晚一共改了多少行」。
混淆矩阵的行与列顺序必须与类别元组一致。打印「第 6 类」时同时打印名字 Shirt。有人矩阵画对了,口头把 Shirt 说成 Coat,会议纪要会变成另一种错误。工具不重要,行列契约重要。两侧用同一顺序,才能说「两边都把衬衫认成 T 恤」。这是数据难度,不是某一框架的卷积实现更差——前提是 CNN 容量也对齐。
学习率减半作为震荡处方:若训练损失上下跳且不下降趋势,减半;若平滑下降只是验证变差,那是过拟合,减半可能无益,应早停。不要对过拟合一律降 lr,那会把过拟合拉长,曲线更难看,浪费 epoch。处方对症,是 5.3 相对「再训一会儿」的全部区别。
本章回顾
- 四条曲线:训练/验证 × 损失/准确率;先诊断再调
- 过拟合 vs 欠拟合:训练很好验证差,对训练也差
- 第一轮单旋钮:早停、Dropout、宽度、固定 lr 的减半、简单 CNN
- 测试集一次:调参用验证
- 报告含检查点类型:让对照可复现
- 五条轴在此汇合:形状、梯度、管线、循环、保存缺一则数字不可信
到这里,第一个 AI 分类器已经在两套框架里跑通、读懂、留下。下一步若继续,应换任务或加深模型,而不是再换一套入门数据重复同一对照。
诊断验收:四条曲线都在,先看训练损失是否下降,再看验证是否分家。欠拟合先查 bug 与学习率,过拟合先早停。一次一个旋钮,从基线检查点出发。测试集只评估最终一次。混淆看衬衫与 T 恤是否两侧共同,共同则是数据难度。Dropout 必须配合 eval。报告含最优 epoch、检查点类型、预处理。五条对照轴在数字里都要找得到对应字段,缺字段视为对照未完成。处方对症:震荡才减学习率,过拟合不要靠把学习率拖慢来假装还在学。
处方顺序再锁一次:早停,对齐预处理,简单 CNN,Dropout,减半学习率。同时开两个视为实验设计失败。从基线检查点加载再训,不要在已经过拟合的最后一轮权重上继续加 Dropout,那是在病危病人身上叠药。混淆矩阵行列与类别元组同序。验证优于训练可能来自 Dropout 关闭,不一定反了。测试泄漏几次之后数字会虚高,对照伦理不允许。报告双侧各一行,字段对齐到检查点类型。五轴字段都能回溯,才叫完成实战,而不是完成一次 fit。
把处方顺序当检查单:早停,对齐预处理,CNN,Dropout,减半学习率。从基线加载。混淆同行说明数据难度。验证高于训练可能来自 Dropout 关闭。测试一次。报告字段能回溯五轴。不能回溯就补字段不补层。检查单执行完,本课的对照实战结束。结束标准不是准确率数字,是你能对另一框架复述同一诊断并开出同一类处方。
把「能复述诊断并开处方」写成毕业标准。标准达到,准确率是附带数字。标准未达到,再高的准确率也只是单框架作业。本课要的是对照作业。对照作业的分数写在字段回溯上。回溯失败补字段。补层是另一种失败。
审查报告最后一行是否写了测试只碰一次。没写就补写。补写比补层优先。优先顺序本身就是对照伦理的一部分。