02 供应链定时炸弹:使用含漏洞组件
02 供应链定时炸弹:使用含漏洞组件
使用含已知漏洞的组件指应用依赖的第三方库、框架、公有包存在已被公开的漏洞,却因版本滞后、依赖树太深或扫描缺失而被带入生产。由于依赖通常不止一层,一个小库的漏洞会被整个依赖树放大。治理靠组件清单管理、版本锁定与定期扫描更新。
第四幕继续把目光伸向你引用的第三方代码。现代应用几乎没有“零依赖”,登录用一个 SDK、图片处理用另一个包、序列化用官方库——这些都不是你写的,但每一行都可能带洞。把多少第三方放进来,就相当于把那么多的“别人审计压力”背到自己身上。
一、问题与直觉:依赖越深,越险
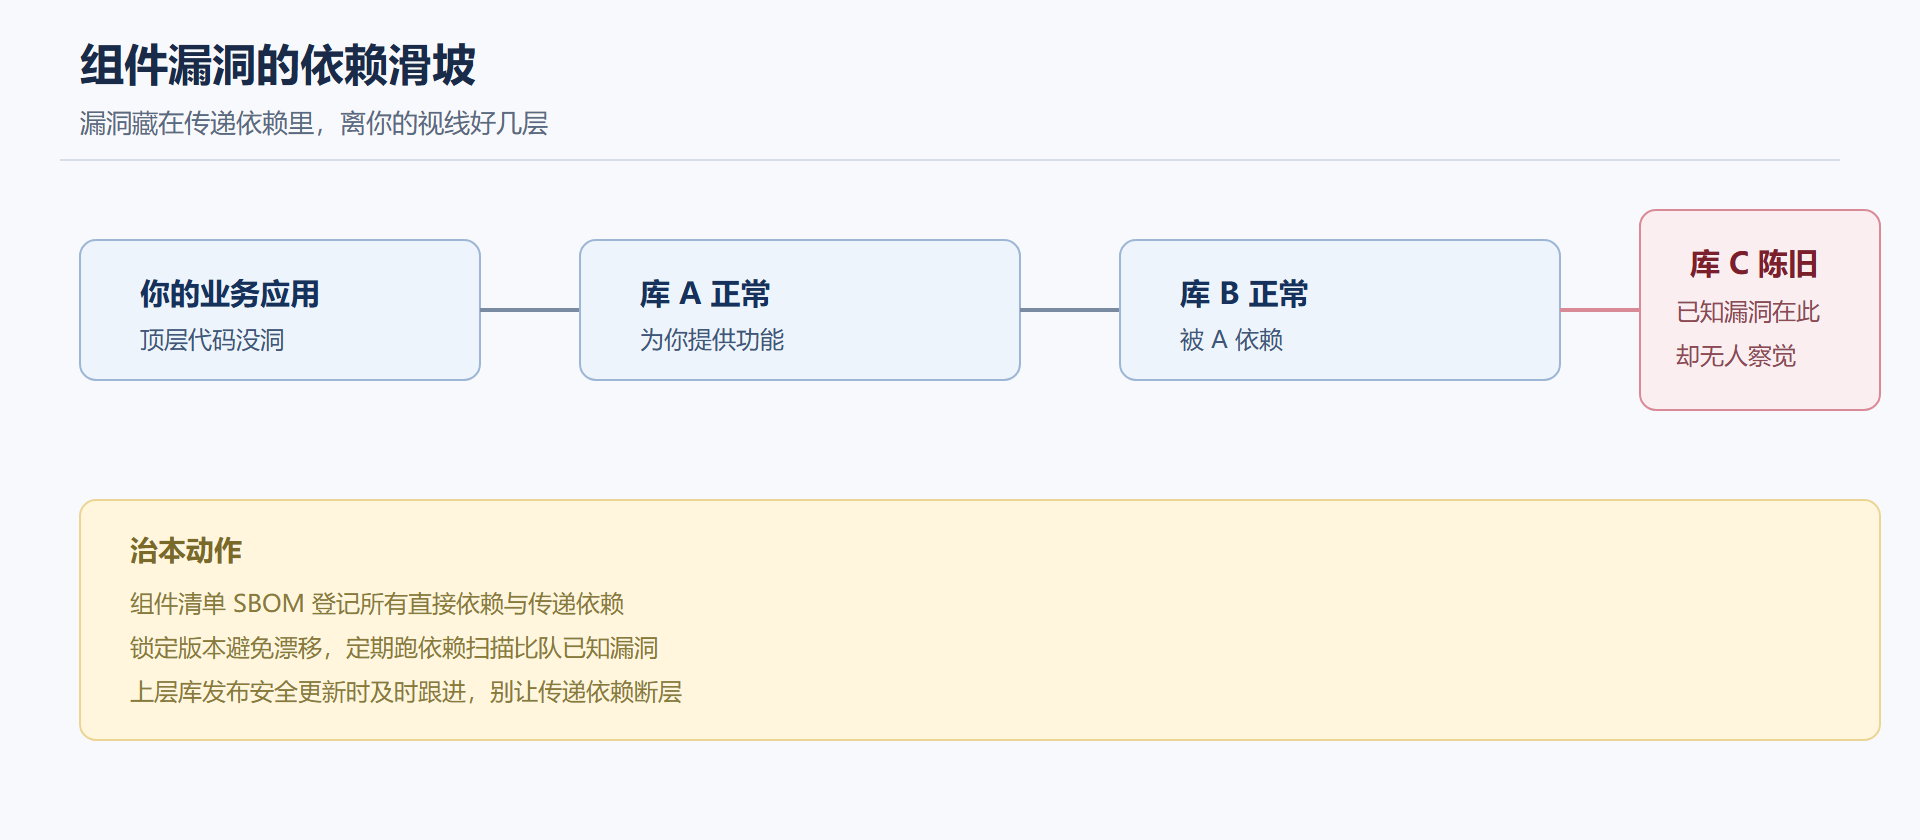
依赖树不是扁平的。你的顶层库 A 又依赖 B、B 又依赖 C,C 的旧版本有个已知 RCE,但没人发现 A 用了它的脆弱路径。这种“传递依赖”让漏洞藏在离你视线好几层的地方。滞后不更新的理由五花八门:怕破坏兼容、没时间、没人告诉我升级了什么——但拖得越久,攻击者拿公开 PoC 命中你的概率越高。
二、核心原理:为什么“别的库”也能要你的命
漏洞数据库(CVE、安全公告)会给已公开漏洞登记编号与受影响版本区间。只要你的依赖树里存在命中区间的版本,理论攻击路径就成立。攻击者拿到 PoC 后可以倒查“有哪些应用装了这个带洞版本”,批量扫一遍就完事。组件的漏洞因此具备“一洞通杀一批应用”的放大效应。
三、工程实践要点
- 组件清单(SBOM):维护一份完整的直接与传递依赖清单,知道“自己到底装了谁、什么版本”。
- 版本锁定与可复现构建:锁定依赖的精确版本,避免“升级一次环境,依赖静悄悄乱飘”。
- 定期漏洞扫描:把依赖扫描接进 CI,提交即查已知漏洞,命中高危则阻断发版。
- 及时跟进安全更新:顶层库发布修复更新就尽快评估升级,别因“怕麻烦”长期停在带洞版本。
- 最小依赖:可少引的库就不引,减少暴露面,也减轻后续升级义务。
⚠️ 常见坑:只看“直接依赖”的安全公告,漏了传递依赖。扫描器可能要求锁定锁文件里所有直接与间接依赖,而不是只查顶层 package 声明。
四、升级不是“点一下按钮”那么轻
一讲升级,常有人误解成“我跑一把更新命令就行了”。现实比这麻烦:升级可能破坏 API 兼容、改变行为、牵连一堆依赖它的旧代码,还可能引入新的传递依赖。所以“及时跟进”的正确姿势是分批处理:先看修复版本变更了什么(读变更记录),评估影响面;在有测试覆盖的隔离环境验证;确认无回归后再合入生产并重扫。这套流程慢一点,但远比“为了不麻烦而永远不升”或“为了看起来勤快而盲升、上线即翻车”都更可持续。核心是把“升级”从一次性的操作,变成一条带评估与验证的例行流水线。
五、当依赖无修复时怎么办
不是所有带洞版本都有修复版本。有的库已停维护、有的只有收费修复、有的修复迟迟未发。这种情况下别停在“没辙”,仍有几条可走:一,换一个生态里更活跃、功能等价的替代库,把风险从“无解”换成“可控”;二,用网络层与运行环境隔离把漏洞的可达触发面关掉,比如封掉该库用到的端口、限制其权限,让它“有洞也难以被利用”;三,在边界层(如 WAF、网关)针对该漏洞加过滤规则,作为等待修复期的临时兜底。记住一个判断:组件漏洞的处置不是“修或不修”二选一,而是“修复、替换、隔离、监控”的组合选择,按可操作性排序落实。
六、一次完整的演练
背景:项目锁了一份依赖清单,里面某传递库版本落在已知漏洞区间。操作:跑一次依赖扫描,对照 CVE 公告定位加载路径。结果:扫描标记出带洞的传递库及其顶层引用者。解读:漏洞在深层,顶层业务代码看起来完全正常。变式:把该库升到修复版本(或更换等价的替代方案),重跑扫描命中归零;同时把“提交即扫、命中阻断”的 CI 规则加上,防止同类问题再生。
七、把“供应链安全”变成日常习惯而非年度活动
组件漏洞治理最怕做成“一年来一次大扫除”,平时没人看。让它在日常转起来,给三个可持续的动作。一是让扫描器成为“常驻安检”,每次提交、每次构建都跑依赖扫描,命中高危直接在合并前报警,而不是攒到月底手动拉一遍——高频上来的漏点才不会堆成山。二是给“未来的自己”留升级余地,新引入第三方库前先问三个问题:它维护活跃吗(有没有人继续打补丁)、它的依赖健康吗(下游是否也带洞)、能在不过度耦合的前提下替换它吗。三是建立“已知带洞且无修复”的看板清单,给每一笔记上缓释措施与复查时间,到期就回头确认替代方案有没有落地。把供应链安全从一次性的“都在做吗”变成每周的真正常态,才能跟得上第三方漏洞一个接一个发布的节奏,让组件治理真正咬住依赖树的每一次变化。
八、出一个“谁在背供应链风险”的归属表
组件漏洞治理常卡在“没人认领”:扫描器报了一堆,却谁都不觉得自己该负责。给一张归属表能把责任钉到人:为每组依赖指定一个 owner——比如登录 SDK 归身份组、图片处理库归媒体组、序列化包归基础设施组;owner 负责跟踪它生态里的安全公告、安排在评估周期内升级、在出现“带洞且无修复”时落实替换或隔离。归属表不只为追责,更是为了有人在“该升级却没人动”时被第一时间叫到。再把每项带上“上次评估时间”和“下次复查时间”,供应链治理就从“扫描器的喊话”变成“有眼睛、有手脚、有时间点”的日常经营,漏洞才不会被晾在那里等大事发生。归属表最初建起来要花一点时间,但它省下的是日后“这库到底归谁管”的反复扯皮,也让进了清单的每一条都有被按时续命的机会。
本节要点回顾
- 升级要分批评估:读变更、隔离验证、无回归再合入,让更新从一次性操作变成例行流水线。
- 无修复时组合处置:替换、隔离、边界过滤多项式落地,处置不是“修或不修”二选一。
- 使用含漏洞组件是把第三方已知漏洞背到自己身上,极小依赖树越深越险。
- 扫描/传递关系让一洞可通杀一批应用,放大效应明显。
- SBOM 清单 + 版本锁定 + 定期扫描 + 及时更新是治理四件套。
- 最小依赖减少暴露面与后续升级负担。
- 只查直接依赖会漏掉传递漏洞,务必覆盖整条依赖树。