01 入口与出口:输入验证与输出编码
01 入口与出口:输入验证与输出编码
输入验证与输出编码是代码层防御的一对双行道:入口侧用白名单校验输入是否符合预期(类型、长度、枚举),出口侧按上下文对要输出的数据做编码,让它在 HTML、属性、脚本、URL 里都不被当成代码执行。两者成对使用,分别堵住注入类与脚本类攻击,是一条防线缺一不可地走向纵深。
第五幕从代码层最基础的一对动作讲起。前面我们反复提到“数据与代码要分开”,输入验证和输出编码就是把它落成两个可执行动作:进货的验一遍(输入),出货的编一遍(输出)。只做其一,往往会在另一半被攻破。
一、输入验证:进货白名单
输入验证发生在“数据进系统”的边界。目标不是“过滤危险字符”,而是“只放行符合业务预期的值”。做法以白名单优先:字段类型(整型/日期/枚举)、长度上限、取值范围、格式正则。对不该含 ../、<script> 的字段(这是业务不该有的),白名单校验直接不让过。
import re def validate_username(raw): # 白名单:只允许字母数字与下划线, 长度 3 到 20 if not re.fullmatch(r'[A-Za-z0-9_]{3,20}', raw): raise ValueError('不合法的用户名') return raw
注意这里的立场:输入验证是“业务约束”,它管“是不是合法值”,但它不足以单独防住注入/XSS。因为仅靠输入验证很难挡住所有编码绕法,真正的兜底在出口侧的输出编码。
二、输出编码:出货按上下文打包
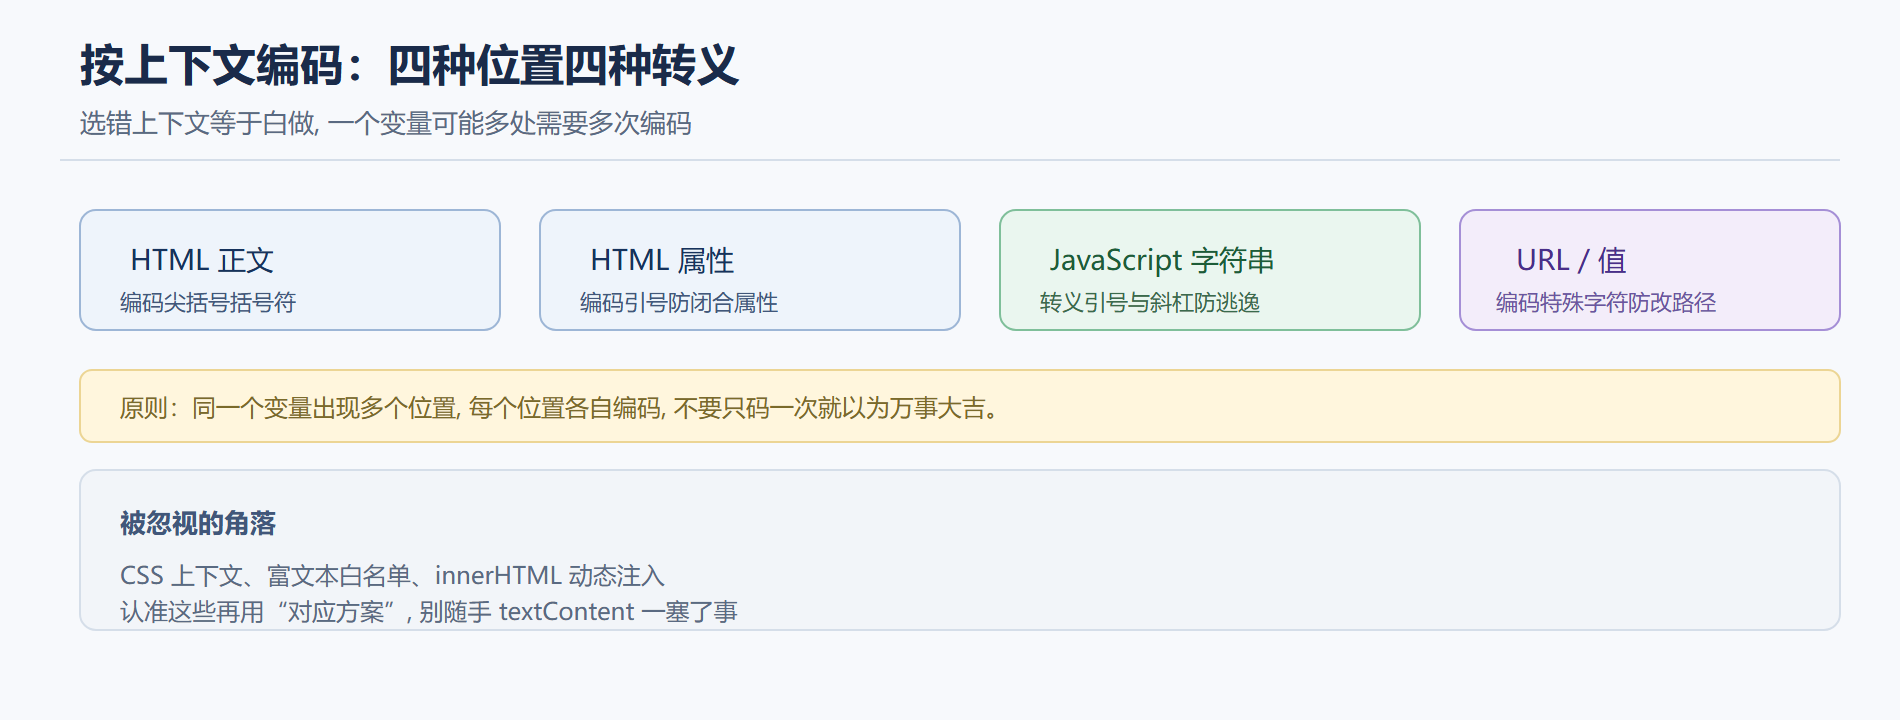
输出发生在“数据出系统、进页面”的地方。凡是用户可控的数据要写入 HTML,都必须按它所在的位置做对应编码:放在 HTML 正文里,< > 编码;放在属性里,引号编码;放在 JavaScript 字符串里,另有一套转义;放在 URL 里又是另一套。选错上下文 = 白做,例如把属性里的数据用正文编码,攻击者可能借引号关闭属性重新注入。
现代框架的模板引擎大多默认自动转义,关键是你别手动关掉它,也别把数据用 innerHTML 这类“当 HTML 解析”的接口注入 DOM。以下几点是必守:
- 模板渲染开着自动转义,逐一确认动态数据走编码输出而非原生拼接。
- 不用
innerHTML/outerHTML直接写用户可控内容,改用textContent或模板转义。 - 同一段数据进入 HTML 属性、脚本、URL 时,各用对应上下文编码。
三、为什么必须成对
只做输入不做输出:同源数据里那些“存储态就带着特殊字符、非本次用户直接提交”的值,绕过输入校验后在输出未编码时成为 XSS 源。只做输出不做输入:一些下游存储可能被多次反编码还原出危险字符,且输入侧给了白名单约束,很多反击能在入口就掐掉。输入验证管住“进”,输出编码管住“出”,两头都堵才称得上纵深。
同一段数据落到四种上下文,要用四种不同的编码——这是“按上下文编码”的字面意思。
四、工程实践要点与其他
- 输入校验用白名单,输出编码默认开启,两者缺一不可。
- 对富文本/帖子等确实需要“允许部分标签”的场景,用成熟的富文本清洗库做白名单化,比手写正则可靠。
- 数字、日期、枚举用类型化校验;接收任何字符串的字段,仍要在输出侧编码兜底。
- 定 CSP 作为最后一道:即便某处编码漏了,CSP 能限制脚本被加载执行的来源(第六幕详解)。
💡 关键直觉:判断该不该编码,看“这段数据最后以什么身份出现在哪里”。一个变量在页面不同位置出现,可能需要多次不同编码。宁可在输出统一编码,也别指望输入一次搞定。
五、一次完整的演练
背景:一个把用户昵称直接显示在页面正文的社区页,昵称经输入校验但输出原样进入 HTML。操作:提交一个含 <script> 的文字作为昵称(绕过输入白名单后保存),再看页面渲染。结果:脚本被执行(反射型 XSS)。解读:输入白名单允许了该格式字符,输出未编码。变式:输出侧把提炼值做 HTML 编码/改用 textContent 渲染,脚本变成纯文本;再用富文本白名单场景对比,验证“需要标签才清洗、纯文本全编码”的分工。
六、把“进出口”排进分支的一条可视规则
单看口诀容易在执行时漏,给一条能贴进评审的检查顺序:任何一个改动,先问它“有没有新开输入口”,有就补白名单校验;再问“有没有新吐出用户可控数据的出口”,有就落到“正文/属性/脚本/URL”四选一然后按上下文编码。两个问题都不答“没有”就合入,否则打回。把这条写进合并前的 checklist,团队就不会只在“昨天刚被攻破时”记得成对,而是把入口白名单与出口编码变成每次合入前的固定动作——这正是本节想把“成对”从道理沉淀成习惯的落点。
七、一套“防 XSS 的分级处理”用它收尾
把所有出口数据按来源与用途分级,处理时心里就有底:来自数据库、曾经被用户提交过的值,一律当作“不可信”看待,按所在上下文做编码;真正需要保留 HTML 的富文本(帖子、公告),走成熟清洗库白名单;纯展示文本(昵称、评论、标题),直接用编码输出或 textContent 渲染;密钥、令牌这类本就不该出现的值,一旦在出口出现就报错拦截而非静默输出。分级处理的妙处是让团队不必对“每个字符串接口都高度紧张”,而是按数据的“身份”决定严一度还是松一度——该严的严到底,该松的(富文本)有白名单兜底。配合上一节的进出口检查规则,这一条把“输入白名单 + 输出编码”从两条空泛原则,落成可逐条对表执行的实操。
本节要点回顾
- 进出口可视规则:改动先问是否开新输入口、是否吐新输出口,分别补白名单与上下文编码,不打勾不合入。
- 输入验证走白名单,管类型、长度、枚举,是“进的约束”。
- 输出编码按上下文(正文/属性/脚本/URL)做转义,是“出的打包”。
- 两者必须成对,单做一端都会留下被攻破的半扇门。
- 现代框架默认自动转义,别手动关掉,也别用 innerHTML 拼用户内容。
- 富文本场景用成熟清洗库做白名单,手写正则难以可靠。