2.1 图像采集与预处理
2.1 图像采集与预处理
本节摘要:图像采集把人脸的原始画面交给系统,预处理负责"把世界摊平"——去除噪声、校正亮度与尺度、固定色彩,让后段检测和特征不再被光线忽明忽暗、镜头畸变这类"世界噪声"干扰。本节讲清预处理在清理什么,并落地直方图均衡、尺寸与像素归一化这几件最常见的手段。
学习目标
阅读完本节,你应当能够:
- 说清预处理解决的是"环境的噪声"而非"人的长相",两者如何分家。
- 解释直方图均衡为何能对抗背光和暗角,及其代价。
- 说清尺寸归一化和像素归一化各在做什么,为什么能加速收敛。
- 判断一套真实系统里采集端该关注哪些硬件因素。
一、问题与直觉
设想凌晨班车上,你举着手机自拍,头顶一盏白炽灯把半边脸照成死白,另半边淹没在阴影里。同样这张脸,白天在窗边拍的却细腻分明。如果你把这两张照片原样丢给识别模型,前一张十有八九认不出——可这不是"脸变了",是"环境把脸涂花了"。人脸识别的预处理段存在的理由就一个:把没法预先控制的世界,尽可能摊成一个系统好处理的标准形状,把"光线、噪声、设备差异"这些和身份无关的变量尽量按平,再交到后段手里。
这不是可选项。堆了一堆深度学习模型的人会在预处理上省时间,结果同一人在不同光源下被反复拒识——根不在模型,在没把画面喂对。
二、核心原理:采集端与预处理端在清理什么
采集:谁把世界变成画面
摄像头把光变成电子信号再变成数字矩阵,这一步就埋了第一层偏置。RGB 分量是否平衡、白平衡错没错、低照度下感光噪点多不多、广角镜头边缘拉不拉变形,全在这里影响后段。采集端要做的,是选择合适的分辨率、帧率、光圈与补光,尽量把脸拍清楚——这一步做坏,后面所有算法都是给残缺证据拼案,花再多力气也是徒劳。
直方图均衡:把灰阶重新铺匀
很多实拍图的问题不是"内容",是"分布":亮度挤在暗区或亮区。直方图均衡通过重映射,让整幅图的灰阶铺展得更开,把被压缩的对比度重新拉开。背光人脸那条被压扁的明暗轮廓,均衡后能显出层次,检测与特征提取都有了下潜的空间。
# 用直方图均衡把灰阶重新铺匀(示意) import numpy as np def histeq(gray, bins=256): hist, _ = np.histogram(gray, bins=bins, range=(0, bins)) cdf = hist.cumsum() # 累积分布 cdf = (cdf - cdf.min()) * 255 / (cdf.max() - cdf.min()) return cdf[gray].astype('uint8') # 逐像素重映射 low = np.full((4, 4), 20, np.uint8) # 低对比场景示意 low[1:3, 1:3] = 30 # 只有一点点层次 print(histeq(low).ravel()[:4]) # 输出:0,0,0,0 …
这段只是演示重映射逻辑。真实的均衡需要考虑全局与局部光照,并有自适应直方图均衡(CLAHE)这类折中方案——它对局部阴影更温柔,也更要小心噪声放大。
归一化:统一尺度和数值口径
新手最容易踩的两件事,一是图片尺寸不统一,二是像素值口径五花八门。尺寸归一化把所有脸统一到一个正方形(如 112×112),让网络输入形状固定;像素归一化把 0 至 255 的灰度压到 0 至 1 或 -1 至 1,让梯度在反向传播时更稳、网络收敛更快。别小看这两步,它们几乎免费地决定了训练到可用要多少轮。
数据流:一张低对比图走过预处理的整体效果
下面这张示意图用"输入—中间各步—输出"的流程,把预处理对同一张脸的影响摆出来。它代表的是:世界噪声被逐步抹平,只把"这是谁"的信息交给下游检测与特征。
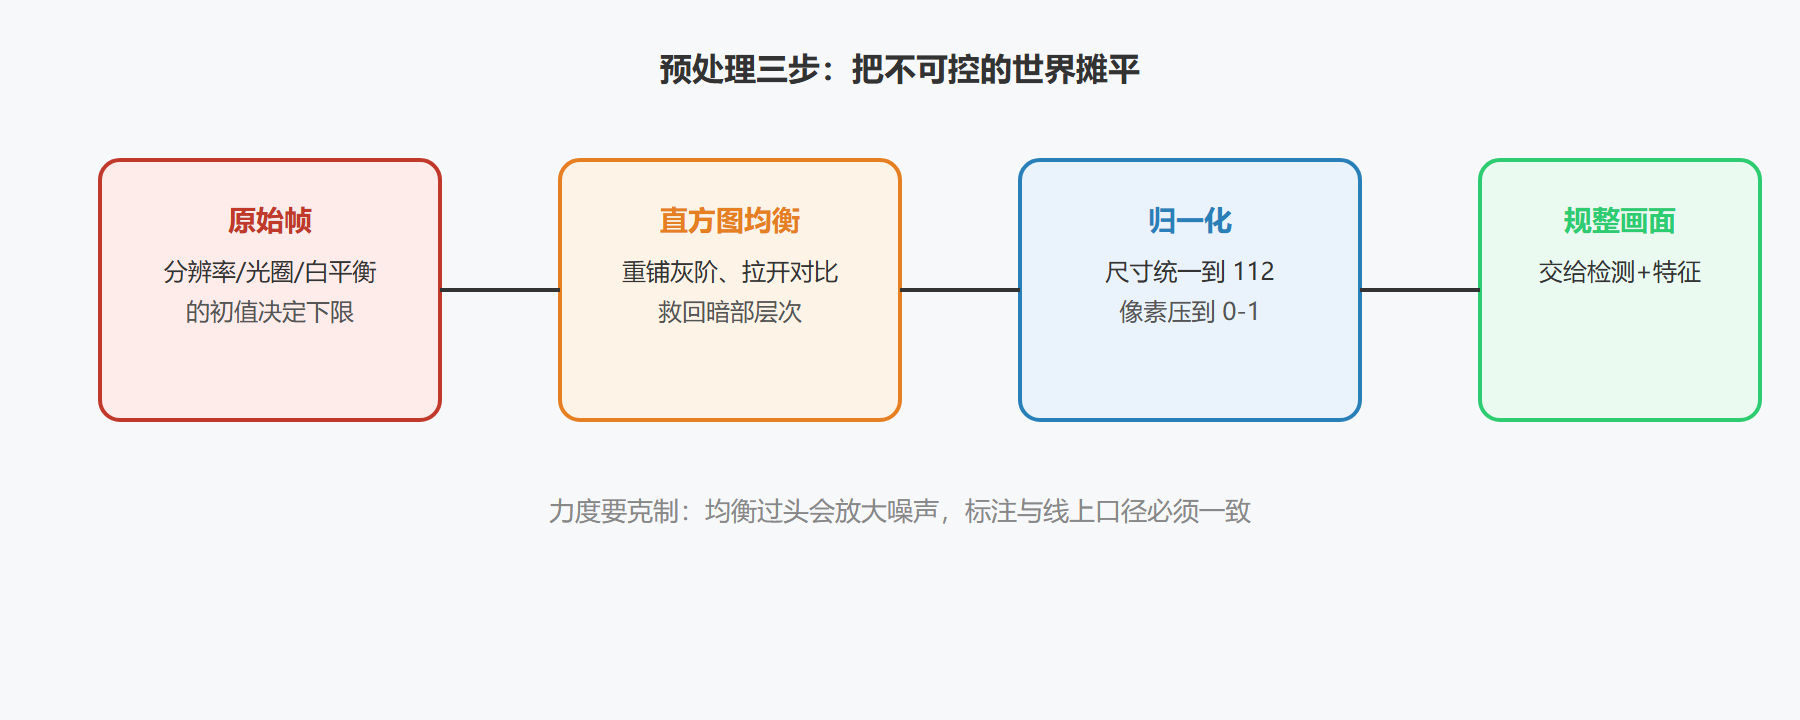
图:预处理三步的视频流示意
上面这张图把"原始帧→直方图均衡→归一化→规整画面"直接摊在眼前。箭头是数据的流动方向;每一步去掉一层世界噪声。右下角那句"力度要克制"不是奉劝,实测里均衡过头在平滑区域放大的噪声,往往比它救回的层次更让识别头疼。
补充:从一张"逆光失败"案例看为什么不能省
假设门禁白天录入用的是窗边顺光,而现场是逆光。若预处理没做均衡,现场那副压扁的轮廓在检测阶段就可能因为对比太弱而漏框,后面整个链条直接没饭吃。而一旦补了均衡+归一化,同一副轮廓就能被稳定框出、对齐、提取。这说明:预处理不是在"锦上添花",而是在决定"证据能不能进罗盘"。
预处理的四件常用招,各自清理哪类噪声、由什么代价换,一个表收干净:
| 手段 | 清理的噪声 | 主要代价 | 何时特别值得上 |
|---|---|---|---|
| 尺寸归一化 | 分辨率/比例不一 | 几乎无 | 所有系统都该做 |
| 像素归一化 | 数值口径不一、梯度不稳 | 几乎无 | 所有深度模型前置 |
| 直方图均衡 | 背光、逆光、低对比 | 平滑区可能放大噪声 | 夜间/逆光场景 |
| 去噪(高斯/中值) | 传感器噪点、压缩伪影 | 细节被抹 | 低照度高感光 |
三、工程实践要点
- 采集端优先保证"脸清楚":分辨率、对焦、补光比后端任何算法都重要,别把钱都砸在模型上。
- 背光、逆光、夜间场景优先做直方图均衡或 CLAHE,但均衡过头会在平滑区域放大噪声,要肉眼对照原图调。
- 尺寸与像素归一化是硬性前置,"跳过它也能跑"不代表"能上线",测试集和线上数据口径不一致是隐蔽的返工源头。
💡 关键直觉:预处理做的不是"增强人脸",而是"抹平无关变量",让后段只在"这是谁"一个维度上纠缠。
⚠️ 常见坑:对训练集做了均衡,却忘了对线上实时流做同样的预处理。数据口径不一致,模型一上线立刻水土不服。
本节要点回顾
- 目标:把不可控的世界噪声按平,只把"这是谁"的信息交到后段。
- 采集端:分辨率、对焦、补光决定证据下限,硬件优先于算法。
- 直方图均衡:重铺灰阶、拉开对比,救回被压扁的明暗层次,但留意噪声。
- 归一化:尺寸统一固定输入形状,像素归一化稳住梯度加速收敛。
- 纪律:训练与线上的预处理必须同一套口径。
画面已摊平,下一节我们开始第一道真正的"找人":在这张摊平的图上,把脸从背景里揪出来。