2.2 人脸检测
2.2 人脸检测
本节摘要:人脸检测回答最朴素的问题——"这幅画面上,有没有人的脸,脸在哪(一个框),大概多大、多偏"。它是整条流水线的"门岗",找漏、找多、找偏都直接决定后面所有环节能不能开工。本节从 Viola-Jones 的级联框架讲到 MTCNN 的级联网络,说清它们怎么在"快"和"准"之间取舍。
学习目标
阅读完本节,你应当能够:
- 说清检测和定位的区别,理解检测输出是一个带置信度的框。
- 复述 Viola-Jones 用 Haar 特征加级联分类器实现快速找脸的原理。
- 说清 MTCNN 三段级联如何把"先粗筛、再精修、最后给关键点"串起来。
- 比较传统检测与深度检测在速度、精度、鲁棒性上的取向。
一、问题与直觉
拿一张全家福问你"第几排第几个是外婆",你一眼就定位了——人眼天生强在这。可对机器,这一张图从上到下是一串亮度数字,没有人脸的知识。检测要做的,就是在漫无目标的像素里扫出"这里像脸的置信度够高"的若干块区域。为什么它是硬盘的第一步?因为后续的对齐、特征提取全都假设你手里有一个大致框住脸的边框——如果这个框偏了、漏了,后面提取到的就是半个额头或一条领带,识别自然全线崩坏。
二、核心原理:一条滑窗、一个尺度金字塔
Viola-Jones 的思路:人力设计特征,加法加速
这是 2001 年的经典,靠三件事把检测跑上消费级硬件:Haar 特征(相邻矩形区域的像素和差,描述眼睛比脸颊暗、鼻梁比眼窝亮这类局部对比)、积分图(把任一矩形和计算降成常数时间),以及 AdaBoost + 级联分类器(先用极便宜的粗筛把绝大多数"明显不是脸"的窗口秒拒,越靠后的级越苛刻,只留幸存者做细判)。它的问题是:特征由人设计,角度一偏、光照一变就失灵,现代复杂场景里基本被替换。
MTCNN 的思路:两件事一起干
2016 年的 MTCNN(多任务级联卷积网络)把检测玩出了新花头。它把网络分成三段:P-Net 用浅网络在大图上快速粗筛出大量"疑似框",R-Net 对粗筛结果精修、滤掉多数假阳性,O-Net 再精修一次,同时输出人脸关键点(双眼、鼻尖、嘴角)。三段一层层收紧,既有"先快筛后精修"的效率,又因为能端出关键点,把"检测"和"对齐"的接口都做好了。
这种"由粗到细再出关键点"的级联设计,后来成为 RetinaFace 等现代检测器的雏形。检测也被做进更加统一的框架:SSD、YOLO 这类单阶段检测器直接回归出类别和位置,把"扫窗口"替换成"一次前向全出框",速度起飞但需要更精致的训练来稳住小目标。
下面演示一个检测器使用方式的最小示意(概念性,接口演示):
# 检测的"门岗语义":给一帧图,吐若干带分的人脸框 faces = detector(img) # 返回框列表 for face in faces: x, y, w, h, score = face[:, :4], face[4] if score > 0.8: # 置信度门槛 crop = img[y:y+h, x:x+w] # 供下一步对齐使用
图:三种检测路线怎么看一家
下面这张对照图把"传统级联、MTCNN 级联网络、单阶段 CNN"三种路线摊在一起比,横轴是计算成本、纵轴是一张粗粗的复杂度。它说明检测不是一成不变,而是沿着"更准、更快、更稳"的方向不断换代。
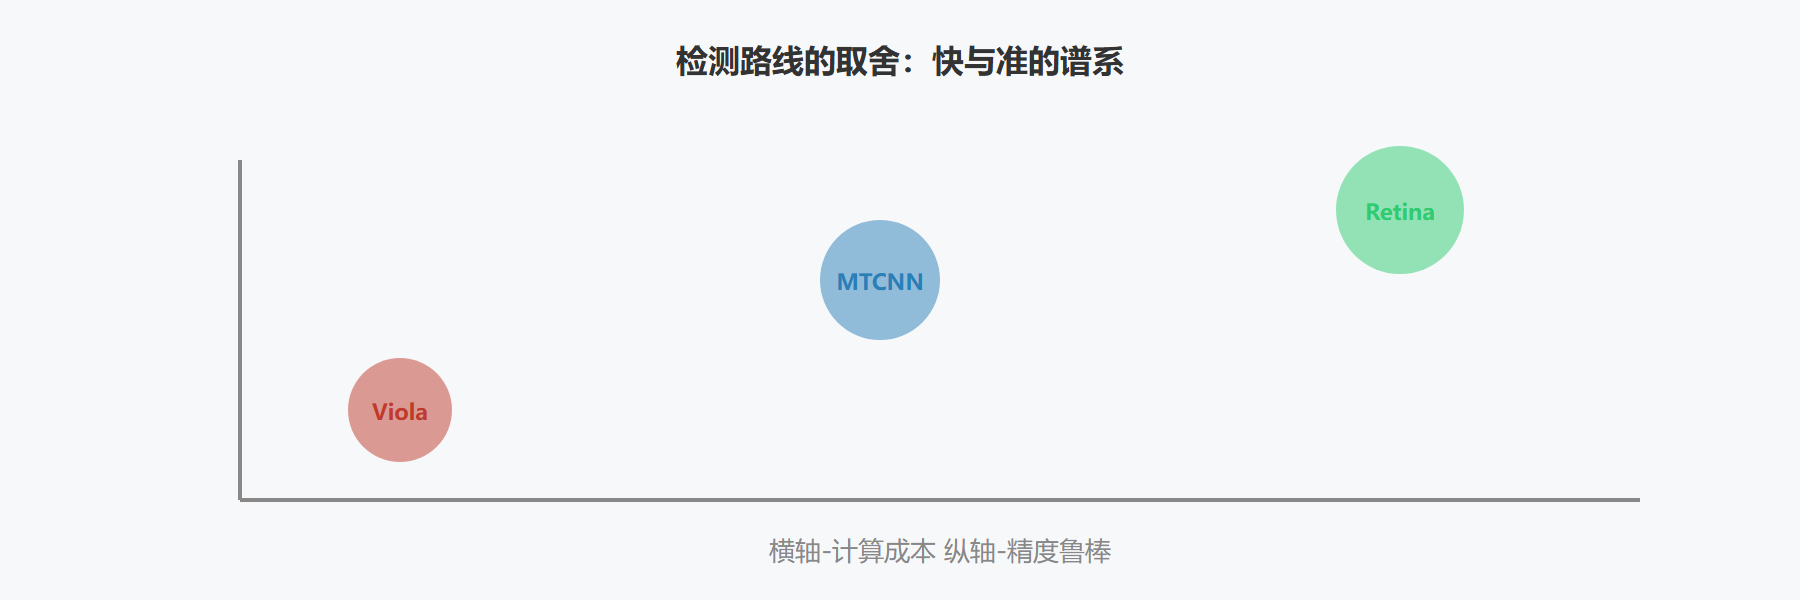
图:三种检测路线对照
这张图的圆由左下向右上依次变高、移右:Viola-Jones 轻快但鲁棒弱,MTCNN 在精度与算力间取均衡,RetinaFace 类单阶段检测器把当前精度天花板再抬一格、代价是更重。选型时你只需要在"算力预算"和"场景难度"之间,挑那个圆落在合适位置的方案。
补充:为什么现代检测几乎都会顺手给出关键点
你可能注意到,从 MTCNN 起,检测器输出的不只是四个角的框,还会带上左右眼、鼻尖、嘴角这些点。这不是顺手,而是"顺便":检测与对齐本来就是相邻的地皮,让同一个网络同时出框又出点,端到端地省一次前向、也让框和点天然对齐。这条"检测即对接口"的设计,也是为什么对齐那一节(2.3)能直接拿检测的输出当起点。
三代检测路线在速度、鲁棒性、是否带回关键点上差距明显,用一个表对齐最直观:
| 路线 | 代表作 | 特点 | 速度 | 鲁棒性 | 关键点 |
|---|---|---|---|---|---|
| 手工级联 | Viola-Jones | Haar 特征+级联,轻快 | 快 | 弱 | 无 |
| 级联网络 | MTCNN | P-R-O 由粗到细 | 中 | 中 | 有 |
| 单阶段 CNN | RetinaFace/YOLO | 一次前向全出框 | 快 | 强 | 有 |
三、工程实践要点
- 检测器的"快"常靠牺牲多尺度稳定性,视频流做逐帧检测可比逐帧跑特征便宜得多——同一帧里框一旦稳定,可做轻量跟踪降低重复检测成本。
- 小脸、侧脸、密集人群是检测重灾区,验收请用带这些难例的集测,别只看风景照上的表现。
- 现代系统普遍选基于 CNN 的检测器(其变体很多),传统 Viola-Jones 仅在与算力、可解释性硬绑定的老场景里还有剩用。
💡 关键直觉:检测先"快",判身份后"准"。把全图的难活压给检测,好让后面更贵的特征提取只处理少数已锁定区域。
⚠️ 常见坑:检测做得好不等于识别好。检测只负责把人揪出来,它的误报只是给后端添乱,识别准确率还要看特征和人两个环节。
本节要点回顾
- 职责:回答"有没有脸、框在哪",输出带置信度的边框。
- Viola-Jones:Haar 特征加积分图加级联,把快速找脸带上消费硬件。
- MTCNN:P-R-O 三段级联,由粗到细并顺带出具关键点。
- 现代取向:CNN 检测器与统一单阶段框架更鲁棒、更快更准。
- 节奏:检测为后段"筛人",快且稳优先。
框已经把你认的那个人圈出来了。下一节干的是把歪在这框里的脸"摆正"——对齐。