2.3 人脸对齐与标准化
2.3 人脸对齐与标准化
本节摘要:检测只给了你一个框,框里的脸多半歪着——侧转、低头、仰脖、大小不一。对齐(Alignment)要做的是根据双眼、鼻尖、嘴角这些关键点,把人脸做一次仿射变换,摆到"眼睛水平、鼻子居中、尺度统一"的标准网格上。本节拆开"关键点检测"和"仿射变换"的分工,算清这一步为什么能把后面的特征提取从姿态的泥潭里救出来。
案情回放:一道门禁不认老同学
拿同一张脸的两张照片对比:一张正脸平视,一张歪着头、下巴微扬。人眼一眼认出是同一个人,因为在你的大脑里,相貌是"去姿态化"的一张人脸模型。可机器没有这个先验——如果它把两张照片直接比,一个额头高、一个下巴长,纯粹的姿态差就把特征搅乱了。对齐的作用,就是先把那张歪脸"拧正",让"脸比脸"发生在一个可比的坐标系里,而不是在每次拍摄的角度差里比。
这一步是典型的隐藏功臣。很多团队调了半天的识别模型收效甚微,最后发现病根根本不是识别网络,而是对齐没做严——同一人的正脸和侧脸被当成两个人,根子不在识别,而在"没摆正就开比"。换句话说,前面检测给的只是"脸上有张脸",对齐才真正给出"脸长什么样、朝向哪边"。
两件工具的分工:关键点与仿射变换
对齐分两步,各管一件事。
第一步是找关键点(landmark)。 一般是双眼、鼻尖、嘴角,从最省的 5 点到密集的 106 点不等。它们是人脸的"地标",本身不表示身份,只描述"眼睛长在哪、嘴角翘了多少"。检测器(MTCNN 的 O-Net、RetinaFace 都直接输出关键点)负责把它们端出来。关键点数量不是越多越稳——5 点已经能扛住绝大多数验证场景,密集点更适合精细遮挡建模或表情分析,代价是更吃算力、也更容易被遮挡干扰。
第二步是仿射变换。 有了关键点,就解一个映射,用旋转、缩放、平移(必要时加轻微扭曲)把"实际人脸"搬到"标准人脸"的基准网格上:让检测到的双眼落在固定坐标线、鼻子居中、整张脸进一个统一尺寸的方框。同一个人的不同角度、不同身材、不同镜头下的照片,最终都落到同一套坐标系里,特征提取面对的就只剩"长相本身"的差异。
来看一段贴近直觉的实现逻辑(示意,不是生产代码):
import numpy as np def align_face(face_img, points, ref_points): # 解最小二乘仿射:让实际关键点尽量贴近基准关键点 M, _ = cv2.estimateAffine2D(points, ref_points) # 拆出旋转/缩放/平移 return cv2.warpAffine(face_img, M, (112, 112)) # 变换后裁出标准脸
真实工程会配合双目精确对准、更长关键点、多套模板基准来进一步压对齐误差,但内核不变:解一个映射,把姿态差异压到标准网格上。
标准模板:那个 112×112 的"基准脸"
"标准化"的落点通常是固定尺寸(112×112 是很多识别主干的默认),再叠像素归一化。这里有一条容易被忽略的纪律:训练时用什么对齐模板,线上也必须用同一套。如果训练喂的是 112×112、主线用 96×96,或训练用标准网格、线上直接裁检测框,特征语义就对不上——模型学到的是"标准网格里的脸",你喂进来的却是"同一张但坐标不同的脸"。这一条一致性,比多调几个损失项都更立竿见影。
# 模板对齐后再归一化(示意) std_face = align_face(face, points, ref_points) # 先摆正 norm = (std_face.astype(float) - mean) / std # 再像素归一化 # 训练与主线必须共用同一套 ref_points 与 (mean, std)
一张图:歪脸被拧正的几何过程
下面这张示意图把"关键点检测 → 仿射变换 → 标准网格"画成三步:左侧是歪脸,两眼连线是倾斜的、鼻子也不居中;中间经过仿射变换把关键点旋平、缩放、平移;右侧落进统一尺寸的方框、坐标对齐标准模板。
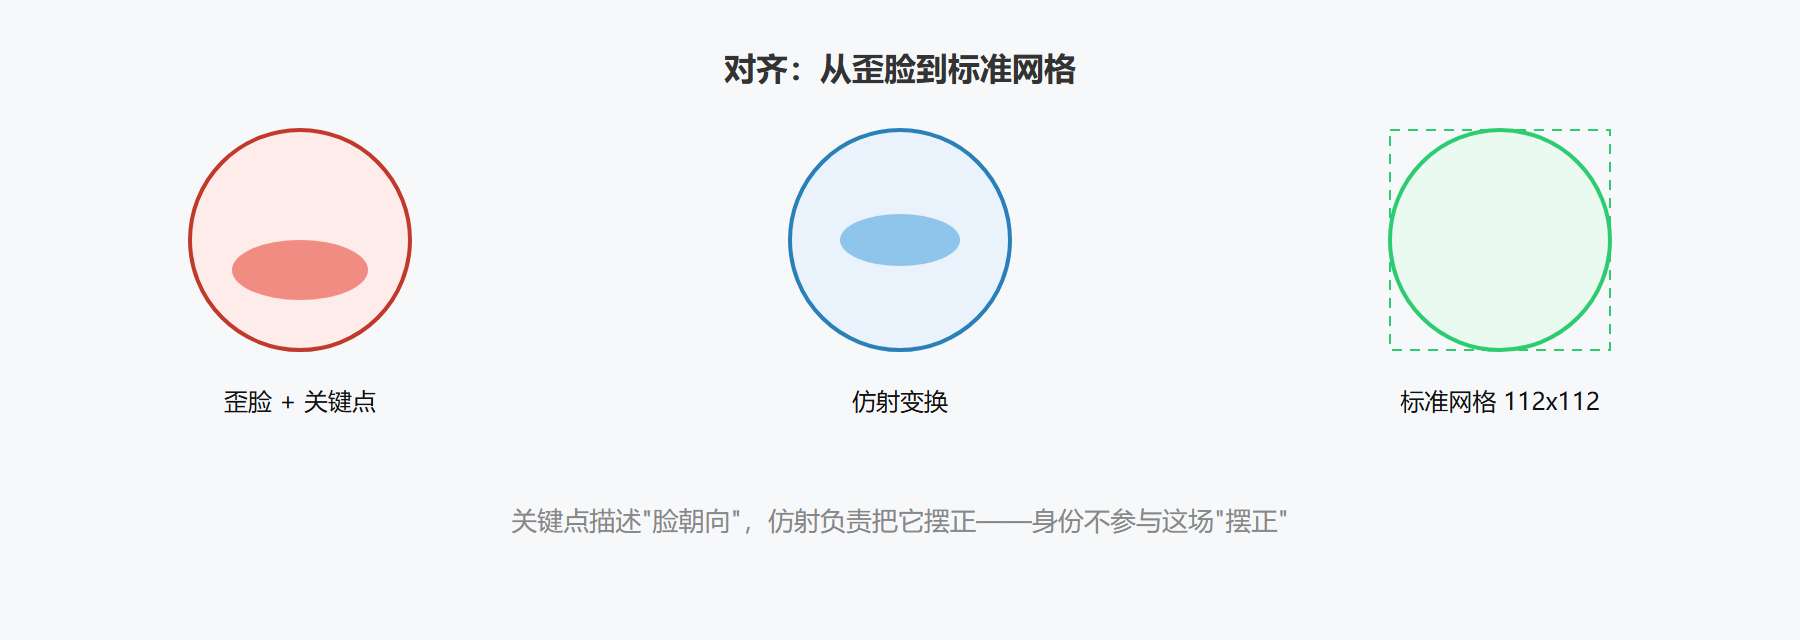
关键在于,这一步操作的是"几何",与"这个人是谁"毫无关系——它只是把每次拍摄姿态造成的差异抹掉,好让后面的特征提取面对纯粹的"长相差异"。
对齐误差这笔账,到底亏在哪
能用一句话记账:对齐哪怕偏几个像素,反映到嵌入向量的变化,都足以把本可判"同一个人"的相似度拉到阈值之下。原因是特征提取对输入里的"位置"异常敏感——眼睛差半毫米,它提取的局部特征就整体错位。因此工程上线通常会专门抽一组"对齐质量专项"样本做人工目检,确保每个录入与核验都落在同一套对齐基准上。
| 构成 | 做什么 | 输出 | 出错的影响 |
|---|---|---|---|
| 关键点检测 | 找眼睛/鼻子/嘴角 | 一组坐标 | 坐标偏 → 提取错位 |
| 仿射变换 | 旋转/缩放/平移 | 标准网格 | 姿态残留 → 特征受姿态牵制 |
| 标准模板 | 统一基准网格 | 规整脸 | 训练/模板不一致 → 语义对不上 |
| 拒收策略 | 过滤大角度/遮挡 | 或拒绝 | 硬对齐 → 畸形标准脸喂进模型 |
一句话直觉:对齐垫的是"坐标系",是让脸比脸的公平接线板。对齐做错,后面再精致的网络也只是在一个歪坐标系里逞强。
工程上的几条硬纪律
- 别拿检测框裁剪当"对齐"。检测框只框脸、不保证姿态;不进仿射到标准网格,特征提取依旧被姿态牵着走。
- 大角度侧脸、低头超过阈值时,先拒绝再对齐,别硬把"低质量证据"掰成畸形标准脸再喂给模型——宁可提示用户正脸重拍,也别硬扛出一个错误签名。
- 对比基准要统一:录入注册、日常核验、培训数据用哪套模板,全程共用一套;换模板是一等大事,务必同步重训重测。
- 对齐的失败模型可以先可视化(把每个样本的关键点、变换后的脸叠出来看),比盯着平均损失更早发现问题。
常见排错:对齐出问题怎么定位
对齐出问题常表现为"误识率忽高忽低、库里同一个人正侧脸对不上"。排错按三步来:第一步,把样本的关键点和变换后的脸可视化叠出来看,确认有没有"点在脸上乱跑"——这一步能立刻区分是检测关键点漂了,还是仿射矩阵解错了。第二步,验证训练和线上是否用了同一套基准模板与归一化参数,很多"训练很好、上线翻车"的问题都出在这里,把两边配置文件对一遍往往当场破案。第三步,排掉"端点条件"——比如 112 会不会被裁掉耳朵、超阈值的大角度是不是被硬塞进变换、旋转 180 度的照片有没有被误当正脸对齐。
还有一类隐性坑:多张脸同框时取哪张。检测常常框出多张脸,对齐前必须先按"人脸尺寸、是否正脸、与屏幕中心距离"排序取主脸,否则一张合影里取了路人甲的脸,后面的比对全白做。给顺序定一套稳定规则,比每次随机取再撞运气强得多。
对准端口再往下想一步:对齐的度量口径
装完排错三板斧,还差一道"度量口径"的收尾。深度嵌入大多按余弦相似度训练和比对,而对齐本身喂进去的是"几何摆好的像素"——它们之间唯一的纽带,是训练和线上共用同一套基准模板。如果训练用的双眼间距是标准值 60 像素,线上却用了 50 像素的模板,那么同一个人的特征在空间里的落点就不对齐,余弦分数会被系统性拉低。就此多一句话:这类"模板不一致"的故障伪装得像"模型不行",很容易让人白调很久的阈值,却始终补不回那零点几个点的差距。
顺带提醒一个升级路径:固定 5 点对齐在侧脸、大表情下往往不够稳,当误识率测来测去都高居不下时,可以试试切换更长关键点(如 68/106 点)加三角网格对齐,把更多几何约束吃进来——对遮挡、表情、姿态这几类难例常常立竿见影。代价是接近涨算力与检索速度,需要和 FRR/FAR 一起权衡后再定。
脸已摆正、坐标统一,下一节该给这张"标准脸"提取真正可分人的特征了。