3.1 传统方法:特征脸与纹理
3.1 传统方法:特征脸与纹理
本节摘要:深度学习横扫之前,人脸识别靠人手工设计的数学结构。本节把 PCA 特征脸、LDA 判别分析、LBP 纹理三条经典路线讲透,说清它们分别在"降维留信息""降维促可分""抓局部结构"三个方向上的数学灵魂、适用场景与硬伤。理解它们,你才真正明白深度方法到底赢在哪、赢了多少。
开场白:老算法还值不值得挖
今天算法供应商嘴边挂的都是"深度模型",但别急着把传统方法当过气废纸。它留下两样堪用的遗产:一是它的"降维思路"至今仍活在工程里——为省算力先在高维上压一手再交网络,这在端侧推理仍是常用招;二是它把"降维该不该用类别信息"这个判断讲得比任何营销话术都清楚。理解它,等于看懂了现代方法一半的雏形。
判定一套组合是不是"传统",有个最省力的问题:特征从哪来——人设计还是数据学。认准这个口径,后面所有流派都逃不出这把尺。
PCA 与特征脸:降维但不丢"最重要的信息"
主成分分析(PCA)用"方差看信息"。把人脸图拉成高维向量,几十万维里真正带区分能力的只有少数方向,PCA 找到方差最大的几个方向的组合,把所有人脸投影进去,得到的低维表示就保留了最"显著"的共性——这些方向拼起来就是特征脸。一句话:PCA 回答"哪几条方向最能解释差异",不问这些差异是不是"分人"的。
import numpy as np # PCA 的核:协方差矩阵的特征值分解,取方差最大的几个主成分 faces = np.random.rand(50, 128 * 128) # 50 张脸,拉平成向量 mean = faces.mean(axis=0) centered = faces - mean cov = np.cov(centered.T) eigvals, eigvecs = np.linalg.eigh(cov) # 特征值分解 top_k = eigvecs[:, np.argsort(eigvals)[-5:]] # 取方差最大的 5 个方向 proj = centered @ top_k # 投影,降到 5 维 print(proj.shape) # (50, 5) 低维特征
这套最直观的短处:它不识人。既然没吃进身份标签,它提取的"主要差异"可能全来自光照、发型这些与身份无关的方向——这正是特征脸识别率上不去的根因。它适合的位子是"通用降维预压",而不是"专职识人"。
LDA 与 Fisherfaces:降维时顺手"促可分"
LDA 是 PCA 的"升级纠偏"。它是有监督的——投影前先把每类均值算出来,设计的目标是"类内散度最小、类间散度最大",也就是让同一个人靠在一起、不同人拉开。Fisherfaces 的名字就是这么来的。
它的短板有个形象的叫法——小样本问题:当每类样本数远小于特征维度时,类内散度矩阵奇异、反不出来,模型直接罢工。工程破解通常两步走:先用 PCA 把维度压到类内矩阵可逆的规模,再上 LDA。这个"先降维再判别"的两段式,至今仍是判别类算法的通用套路。
LBP:不降维,直接抓局部结构
LBP 另辟蹊径,不问全局投影,而在每个像素周围比较局部明暗、编码成 0/1 序列再统计成直方图。它的高明在于吃"相对明暗"而非绝对亮度,对均匀光照变化钝感;局限是只抓局部纹理,全局结构、姿态一变就过敏。配统一 LBP、旋转不变 LBP 这些改良,它曾在轻量识别的时代占过一席之地,也在很多"低算力嵌入式"的老系统里活到今天。
三条路,三笔账
| 方法 | 是否用类别 | 目标 | 主要优势 | 硬伤 |
|---|---|---|---|---|
| PCA/特征脸 | 否(无监督) | 方差最大降维 | 理论清晰、可解释 | 不分人,易被光照带偏 |
| LDA/Fisher | 是(有监督) | 类内紧、类间散 | 目标直指"分得开人" | 小样本矩阵奇异 |
| LBP | 否(局部编码) | 抓局部明暗纹理 | 抗均匀光照 | 缺全局结构,姿态过敏 |
什么时候还用得上它们
- 把 PCA 当"普适降维预压"的辅助件,放在深度嵌入进入前先压维度、省算力,仍划算;但作识别主特征,会被深度嵌入甩开一个身位。
- LDA 在小样本、可解释优先的场景仍有用武之地,前提是先解决矩阵奇异。
- 传统方法最大的卖点:可解释、轻快、低算力。光照稳定、库小、要离线可解释的老场景,往往仍是划算的选择。
- 万一某天你拿到一个只有几百张图、又要离线推理、还要能给监管说清楚"凭什么判的"的项目,别急着上深度——把特征脸那一套捡回来,也许正好。
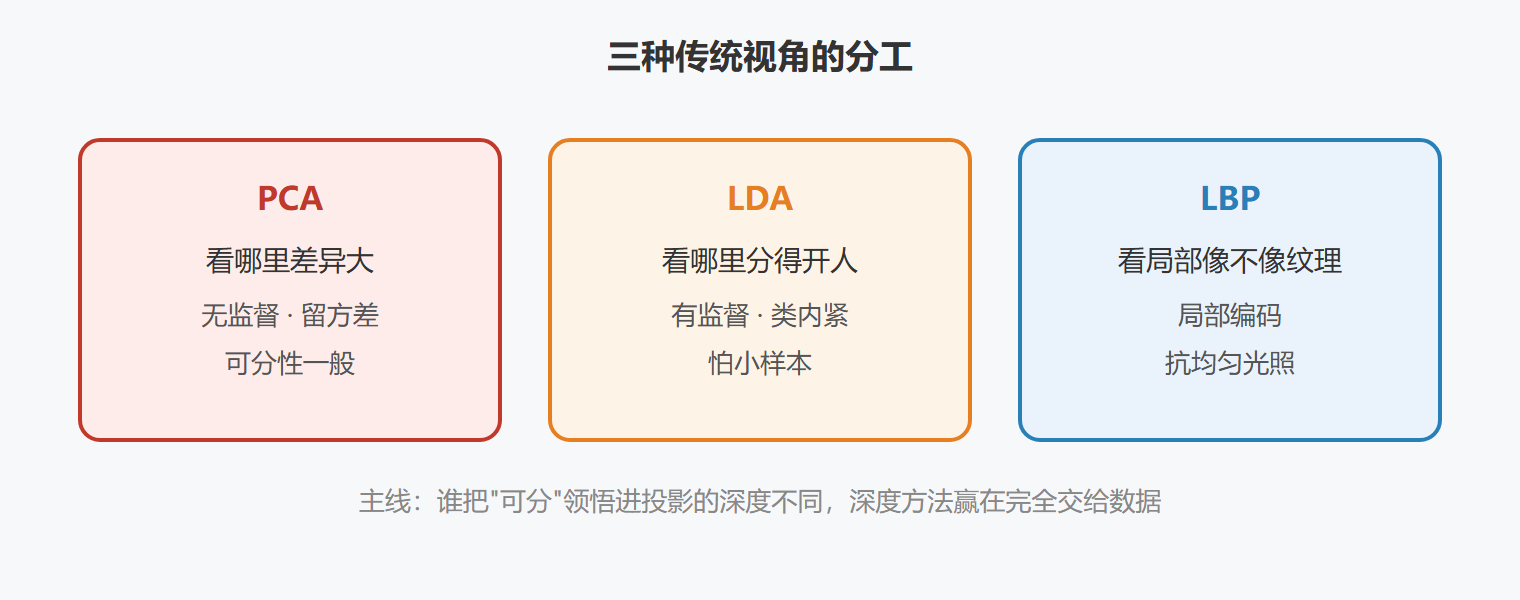
一句话直觉:PCA 看"哪里差异大",LDA 看"哪里分得开人",LBP 看"局部像不像纹理"——三者把"可分"领悟进投影的深度各不相同。
三个经典问题的动手答案
纸上谈兵不够,这里放出几道用代码就能验证的判断题。第一道:把 50 张脸做 PCA 降到 5 维,识别率普遍不如深度嵌入——为什么?因为 PCA 保留的是"方差最大",而方差最大的方向可能全是光照、发型,跟"这个人是谁"无关。你可以把一个类的均值减掉再看主成分,通常会发现前几个主成分大多在"描整体明暗"而非"描身份"。第二道:同样是降维,LDA 明确吃类别标签,对应"类内紧、类间散",所以它更适合识人——但这正是小样本问题的来源,当特征维度超过每类样本数时类内散度矩阵奇异、需要先 PCA 压维。第三道:LBP 用"相对明暗"编码,直接把相邻像素比大小,所以对整体光照均匀缩放天生不敏感——它是唯一一个"不做全局投影、只在局部做差"的路线。
这三道题的价值在于帮你建立一套判断框架:给定一个场景,先问"我的数据是否有干净的身份标签可监督",再问"光照稳不稳、要不要抗局部结构",最后问"算力与可解释性压力多大"——答案组合不同,传统方法的取舍也跟着变。
传统方法与深度混搭的一条路
别以为传统和深度是二选一。工程里有个常见的手艺:用传统方法做"降维预压"或"质量筛选",再用深度嵌入做最终比对。例如几百上千张图先 PCA 压成像、滤掉明显不合格的低质量样本,把高保真的候选喂给深度模型,这样既省算力又能保住深度模型的精度。反过来,当你想给监管方解释"凭什么判是这个人"时,PCA 这类可解释特征又是现成的说辞来源。理解传统方法的真正回报,不是照搬它上线,而是知道在深度流水线里哪些环节能借它的力。
传统方法的精神看完了。下一节我们换掉"人设计",请出今天的主角——能自己学特征的深度卷积网络。