3.2 深度卷积神经网络
3.2 深度卷积神经网络
本节摘要:卷积神经网络(CNN)是今天所有主流人脸识别模型的骨架。本节把卷积、池化、全连接、残差这几块最基本的积木讲清楚,说明它们如何层层递进地从"边缘角度"一路抽象出"五官乃至整张脸的可分特征",再交代为什么"越深反而会退化"、以及残差连接又如何两步破解。
从一张像素纸说起,网络自己决定看哪
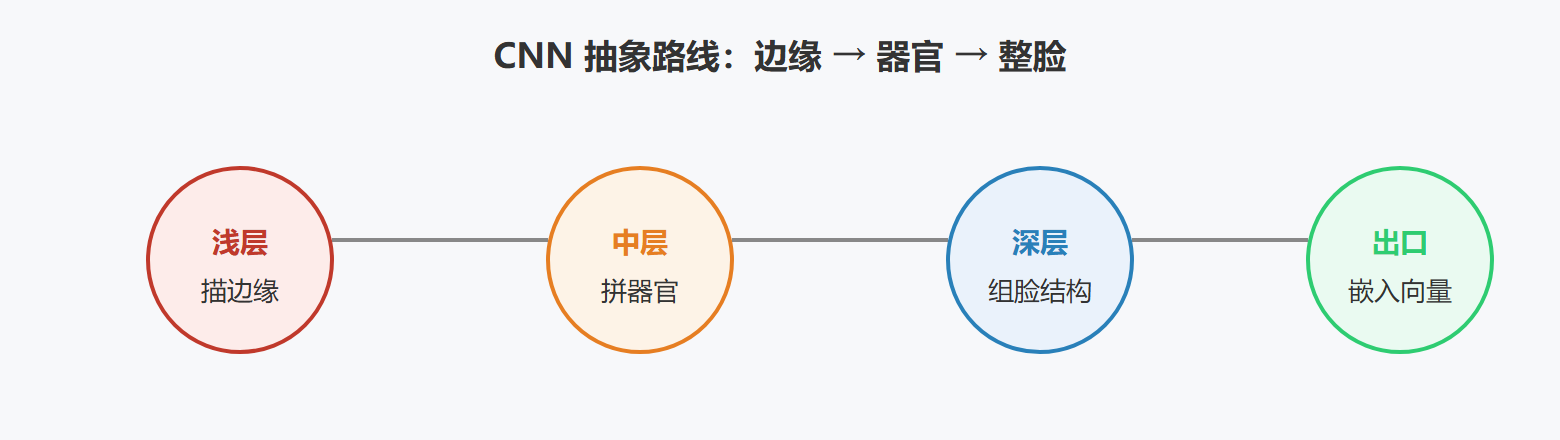
把一张脸交给传统算法前,你得事先告诉它"看眼睛还是看颧骨"。深度学习换了个路子:别管我负责哪一块,我自己一层层地决定先看什么、再组合成什么。给一张脸的像素,第一层卷积像在描边缘——水平的、垂直的、倾斜的线条;再往上的层把边缘拼成小块——眼睛、鼻梁的局部;更后面把这些块拼成五官乃至整张脸的粗壮结构。网络越深,它能抽象到的特征越"高、越靠近人",这个"味儿"到底是怎么一层层焗出来的,就是本节要解的事。
卷积层:局部的滑动扫描
卷积用一个可学习的"小窗口"(如 3×3 的核)在整张图上滑动,处处做点积求和,输出一张"谁在这个位置有这种局部模式"的特征图。一个核抓一种模式,几十上百个核并排放,就抓了几十上百种特征。关键在"权重共享"——同一个核在整图各位置复用,参数体积骤减,这正是 CNN 在当时算力下喂得动的道理。
你也许要问:为什么非要用卷积而不是全连接直接拍扁整张图?因为人脸识别要拿住"空间局部性"——眼睛这个模式在图像里的相对位置有意义,而一个核在滑动的过程中天然把"某个局部模式出现在哪个位置"编码进了特征图,全连接做不到这种平移性的高效表达。
池化层:降像素、稳位置
池化(常用最大池化)把相邻小块合并成一个代表值,作用是压缩空间尺寸、减少计算量,并让特征对"位置小幅移动、轻微形变"更钝感——脸稍微移了半个身位,特征仍大致对齐。
import numpy as np def max_pool2x2(x): # 2x2 最大池化示意 h, w = x.shape return x.reshape(h//2, 2, w//2, 2).max(axis=(1, 3)) x = np.array([[1, 3, 5, 2], [0, 8, 1, 4], [2, 6, 9, 1], [7, 0, 3, 5]]) print(max_pool2x2(x)) # 输出 [[8,5],[7,9]]
全连接层:把特征拧成向量
经过若干卷积与池化,空间信息被提炼成高层的语义特征图,再接几层全连接把"图"压平、组合,最后一层输出分类置信度或(人脸识别里)一段嵌入向量。全连接就是把"看到了什么"翻译成"可比对的向量"的出口。注意人脸识别多数时候并不直接用最后一层分类输出,而是取它前一层的特征向量来当"签名"——这一点在工程实践里非常关键。
残差连接:深而不退化
直觉是"网络越深越准",但现实给过一记重锤:层数堆到某个阈值后,训练误差不降反升——不是过拟合,而是前向传播中信息在逐层传递时衰减,梯度回传也变得不稳定。残差连接的对策很巧:让某几层学习"对输入板块的修正量",把"上一层输出"直接短路加到"本层输出"上。这样即使本层学不到东西,信息也能顺着旁路直达下游,深层网络才第一次能练得动。ResNet 能做到上百层而不退化,靠的就是这一手。
为什么"短路加修正"有效?可以这样想:让一个子模块去学"恒等函数"(什么也不改变)本来很难,网络很容易在这个目标上失调;但用残差结构,网络只需把旁路权重学成 0,子模块就天然等于恒等映射——这个目标对梯度友好得多,深层堆叠因此不再让误差恶化。
一条表:四块积木各管什么
| 积木 | 做什么 | 参数特点 | 关键作用 |
|---|---|---|---|
| 卷积层 | 局部滑动学特征 | 权重共享瘦身 | 抓"某位置有某模式" |
| 池化层 | 合并邻近降采样 | 无参数 | 稳位置、减计算量 |
| 全连接 | 压平组合出向量 | 稠密 | 把"看到什么"翻译成向量 |
| 残差连接 | 短路加修正量 | 几乎无新增 | 破"深即退化",让深层可练 |
工程上的三条判断
- 主干越深表达力越强,但越吃算力、越易过拟合。ResNet 这类在"深"与"可用"之间的经典,是直接可复用的基准线。
- 人脸识别里更看重最后一层之前盘出的嵌入向量质量,所以常把分类头拿掉、用倒数第二层特征做比对签名——这是"用嵌入做识别"和"训练时顺手分类"的根本差别。
- 迁移学习是省钱捷径:用预训练主干微调,比从头练又快又稳,小数据场景基本必选迁移。扩展一句:换场景时优先冻结前几层只微调高层,收敛更快、也更不容易把预训练学到的通用特征抹掉。
看一张特征图,读懂网络"到底在看什么"
想真正搞懂 CNN,与其背概念,不如亲手把某层的特征图打出来看。取一张正脸图过一遍主干,挑出第一层卷积的几十张特征图,你会发现有的在描水平边缘、有的只在某个颜色通道响应、有的对眼睛特别敏感;再取倒数几层的特征图,它们往往已经很抽象,几乎看不出人脸形状,而是某种局部分块响应。这个观察能击穿一个常见误区:网络"各层负责的东西"不是人设计出来的,而是梯度自己长出来的——你给它的数据里如果总是亮背景、居中脸,它学到的特征也会偏向这些,这正是换场景要重训的原因。
主干怎么选:深浅、宽度与算力的三角
人脸识别主干的选择要在一个三角里取平衡:层数越深表达力越强但越吃算力、越难训;通道越宽(同样层数下参数更多)越能抓细节但也越贵;而你要跑的硬件只能扛住某一档。判断口诀很简单:先定"部署硬件能跑多深",再在这个约束里挑最深、最准的那个。ResNet-50 一档是精度与速度的常见折中,轻量需求的 MobileFaceNet 则把精度让出来换体积和帧率。别一上来就堆最深的主干,除非你的硬件和数据都撑得住——否则训出来的模型要么跑不动,要么过拟合。
一个数据层面的坑:输入尺寸和归一化必须钉死
人脸识别对输入的口径极度敏感:训练时用 112×112 配某组均值方差,线上却用 96×96 或不同的归一化,特征就整体漂移,比对分数被系统性拉低。这比调卷积核更隐蔽。所以主干选型的一等大事,是把"输入分辨率+预处理流水线(对齐模板、减均值、除方差)"作为不可改动的常量锁进配置,训练与部署严格复用同一套。很多"训练很好、上线退步"的案例,根子都在这条不被注意的口径上。
一句话直觉:CNN 的三板斧合起来是"卷积抓模式、池化稳位置、全连接出向量",残差则让"更深"第一次变得可兑现。
网络底座搭好了。下一节把它的输出组织成"可分空间"——嵌入与度量学习,我们要解释特征到底该摆成什么形状。