3.4 损失函数设计
3.4 损失函数设计
本节摘要:损失函数是训练时牵引特征布局的"裁判"——它给模型的每一次输出打一个"有多不如意"的分,反向传播据此修正网络。本节从最基础的 Softmax 讲起,再引出三元组损失、中心损失,以及角度/余弦间隔损失(SphereFace、CosFace、ArcFace),说清每种损失在"逼同类近、逼异类远"上各下什么棋,各自的易训性、泛化特点与坑。
断案要靠裁判,可谁给裁判打分
模型不会自己知道"这个向量该长什么样"。它每一次前向输出,都是拿自己当前的臆断出来献丑,而真正告诉它"错在哪、差多少"的,是一段叫损失函数的分。训练的过程,本质是让模型顺着这条分式的梯度一路下坡,把"不懂人"变成"会分人"。同一个网络骨架,有人能挤出可观差距,差别常常就藏在损失函数怎么选。这一节把四位"裁判"挨个请上讲台,看谁更懂"可分"。
会读损失,还要会读"曲线反常"。训练里损失掉不下去、或掉了又弹,常常不是模型问题,而是损失与学习率、归一化之间没配好——这些"裁判打架"的症状,本节末尾一并交给你。
Softmax:最朴素的裁判
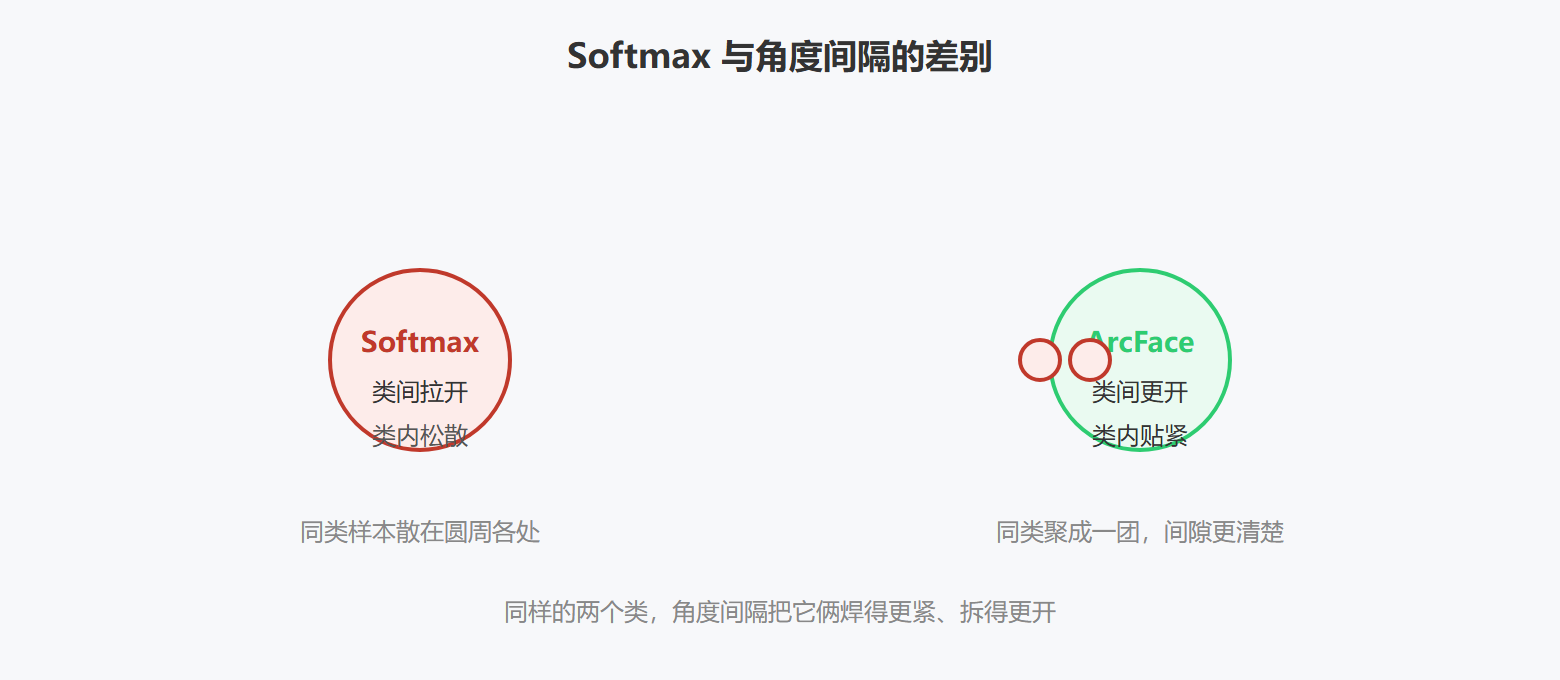
Softmax 配交叉熵是人脸识别的地基。它把人脸当成多分类:每一类对应一个人,网络输出"这张脸属于第几类"的概率。它的天然局限也叫人看得很准:只在意"别分错类",也就是优化类间,对"同一人若干照片的向量彼此贴不贴紧"全然不管——类内空间可以很松散。这正是它被后来者逐年超越的拆台点。
import numpy as np def softmax(logits): e = np.exp(logits - logits.max()) return e / e.sum() def cross_entropy(logits, target): # 目标类索引 p = softmax(logits) return -np.log(p[target] + 1e-9) logits = np.array([2.0, 1.0, 0.1]) # 三类 print(round(cross_entropy(logits, 0), 3)) # 目标命中,损失小 print(round(cross_entropy(logits, 2), 3)) # 判错,损失大
上面演示的是 Softmax 裁判的动作:命中就给低分(好),判歪就给高分(坏)。它在"类多、库闭集"时够用,但对"要贴紧类内"无动于衷。
决赛圈的三位改进选手
三元组损失:逼"锚-正"贴、"锚-负"离
第 3.3 节的 FaceNet 用的是它:以锚点为中心,目标是让"锚与正"的距离小于"锚与负"并留出间隔。好处在于直接摆布相对远近、不受固定类别束缚、开集友好;阴在于采样难、易训慢、间隔超参敏感。它的短板在上一节已展开,这里提醒你它和 Softmax 一族在"度量口径"上可能打架——混用时务必对齐归一化。
中心损失:给每个类立个"重心"
中心损失的想法很朴素:给每个身份维护一个"中心向量",训练时额外罚"该身份的照片离自己的中心别太远"。它是贴在 Softmax 上的一根伴侣罚条,专门收紧类内,与分类项各司其职。代价是要为每类引进一个中心变量、占内存,大库开销要留意——当身份数上到几十万时,这一排中心向量会变成实打实的内存负担。
角度/余弦间隔:把沟刻进角度
ArcFace、CosFace、SphereFace 一族,把"让正确类别更凸出"这条要求直接写进 Softmax 的几何关系里。以 ArcFace 为例,它把人脸特征和各类权重都归一化后用余弦求角度,再对正确类那个角度加间隔 m,逼正确类在角度上被挤出更大距离。效果比 Softmax 是"类内贴紧、类间拉开"同时兑现,在大库上非常能打、训练也稳。它的实战参数主要是间隔 m 和特征缩放系数,一般取官方推荐默认值起步、按验证集微调即可。
一张表:四位裁判各下什么棋
| 损失 | 主攻 | 类内是否收紧 | 开放集表现 | 主要坑 |
|---|---|---|---|---|
| Softmax | 只判类对错 | 否 | 弱 | 类内松散 |
| 三元组 | 锚正近、锚负远 | 是 | 强 | 采样难、间隔敏感 |
| 中心损失 | 贴类别重心 | 是(辅助) | 中 | 每类占一中心,内存大 |
| 角度间隔 | 角度上加沟 | 是 | 强 | 需调间隔与缩放 |
工程实践要点
- 选损失先看库形态:海量身份、库稳定 → 角度间隔派(ArcFace 是主流基线);要频繁接新身份、数据少 → 加度量学习思路或迁移。
- 三元组上手别裸奔,配难例采样(坡线负例)再谈收敛;间隔取值小一点起步、按验证集调。
- 中心损失是不错的"粘合"辅助项,但会长内存,别在超大库硬上。
- 多年实践的一个默认值:先拿 ArcFace 基线,把其它花头省下来留给定阈值、清数据、调精度这类更高杠杆的事。
- 多个间隔损失叠加、缩放因子互撞会让损失面不稳、训练发散——要叠也要按单变量验证逐个检验,别图省事一把梭。
损失不是越多越好:一个"多合一"的反例
很多新手相信"多叠加几路损失,效果自然更好",于是把三元组、中心损失、角度间隔一股脑全开。这个直觉在工程上多半会翻车:多个牵拉项各自带缩放系数,合起来让损失面变得极陡、极不稳定,训练一乱,你根本分不清是哪一路在拖后腿。正确姿势不是越多越好,而是"本着一个主线,按需加一条辅助,且每条都单独用验证集验一遍有无提升"。ArcFace 一族单打独斗往往就是很好的基线,加中心损失这类辅助项前,先量一量它有没有真的把 FRR/FAR 一起降下来。
一步一证:训练时怎么看着损失说话
学会看训练曲线,比背公式更能避免故事。几个有用的观测信号:损失总降不下来,多半对焦在"学习率太大或太小、批尺寸不对";训练损失持续下、验证却不涨,是典型过拟合信号;损失曲线锯齿很抖,考虑降学习率或调优化器;若用三元组,损失常年停在 0,说明采样选得太简单、模型根本没在学,该换难例/坡线采样。把"损失曲线+验证集 FRR/FAR 曲线"放在同一张图里持续盯,你能比单纯盲搜参数早三天发现方向性问题。
间隔值怎么定:m、缩放与验证集的关系
角度间隔损失里有两个核心超参:角度间隔 m 和特征缩放 s。m 决定"刻得有多深",太大让训练难收敛、间隔反而拉不满;s 调的是损失"锐度",影响收敛曲线是否平滑,一般用官方推荐的默认值(如 m≈0.5、s≈64)起步。别再一问便推到极端——先在默认值附近小步试,在验证集的 FRR/FAR 上看差异,通常几百组样本就能看出谁好。任何超参调整都要在同一组验证集、同一采集口径下测,否则等于拿噪声当信号来下结论。
一句话直觉:Softmax 是个"懂事"的裁判,只盯别判错类、不收拢类内;既接住类内、又撕开类间的,才是能大幅上分的裁判。
裁判们各显其能了。可面对真实市场,你还得知道这些原理对应哪些能直接开箱的模型——下一节我们做一次主流开源模型的选型横向。