3.3 特征表示与度量空间
3.3 特征表示与度量空间
本节摘要:深度网络输出的一段浮点向量,必须被安排进一个"同类贴紧、异类拉开"的空间,才能支撑识别。本节先把"嵌入空间(度量空间)"这个概念讲清,再按两条主线——度量学习(FaceNet 三元组)与 Softmax 改进(SphereFace、CosFace、ArcFace 的角度/余弦间隔)——讲清大家各自怎么在空间里给特征排座次,以及各自面对的可训练性与泛化问题。
问题所在:几百个浮点数凭什么分人
模型给你的"特征"其实只是几百个浮点数,它们本身无意义,意义来自它们放在空间里的位置。设想一张放脸的正方形纸:这张脸放右上角、那张脸放左下角,同一个人各种箱子下的照片最好都落在同一个点里——空间布局越"同类近、异类远",比对就越容易。这就是"嵌入空间"的全部直觉:把人脸搬进一个向量空间,让"身份远近"对应"空间远近"。剩下的问题只剩一个:谁、用什么逻辑,替你把这张布局调到位。
另一个容易忽略的口径问题:同一个向量,用欧氏距离量、还是用余弦相似度量,结论可能不同。绝大多数深度嵌入按"视角看方向"来训——也就是余弦相似度,因为人脸特征对幅度漂移(比如光线整体变亮后向量的模变大)不敏感。所以"训练用什么度量,后端比对就用什么",是一条不能破的纪律。
度量学习派:FaceNet 与三元组
Google 的 FaceNet 是度量学习的代表作。它不把人脸当"第几类",而是造出三元组:锚点、正例(同一人)、负例(不同人),然后训练网络令"锚-正"距离尽量小于"锚-负"距离、再预留一个间隔。这样即便训练时从没见过某个新人,它也能把新人放对——因为空间布局由"相对远近"定型,而不是被某个固定身份绑死。
import numpy as np def triplet_loss(a, p, n, margin=0.2): d_ap = np.linalg.norm(a - p) # 锚-正 距离 d_an = np.linalg.norm(a - n) # 锚-负 距离 return max(d_ap - d_an + margin, 0.0) # 想让 d_ap 明显小于 d_an a, p, n = np.array([1., 0]), np.array([1.1, .1]), np.array([0., 3.]) print(triplet_loss(a, p, n)) # 接近 0:布局已合要求
上面的函数揭示了一个关键:当"同类近、异类远"已经满足时损失为 0,不再反向传播。三元组训练最大的痛点是"怎么挑值得训的三元组"——随机挑,多数取值已达标的"太简单",学不到东西;全挑"最难"的又容易崩塌。工程里常用坡线(semi-hard)负例采样来找平衡,这也是三元组实战里最考验调参手腕的一环。
Softmax 改进派:角度与余弦间隔
另一派对 Softmax 做改动。它们的共同点是把"分类权重"当成空间里的一个"锚方向",训练时让同一人的特征往它该有的方向挤,同时拉开与别人方向的距离。SphereFace 加角度间隔、CosFace 加余弦间隔,而 ArcFace 把角度间隔做得更"直接"——它在目标角度上加上固定间隔 m,让正确方向比其他方向更"凸出",类间距离被稳定抬升。
对比三元组:Softmax 改进派一般在"训练身份类别多、库规模稳定"的场景更顺手、收敛更稳;三元组更接近"开环度量",在需要灵活泛化新身份时风格迥异。真实市场大量落地都选了 ArcFace 这类角度间隔路线,因为它把"同类紧、异类散"做得足够出彩、也相对好训练。
两张图看懂布局规则
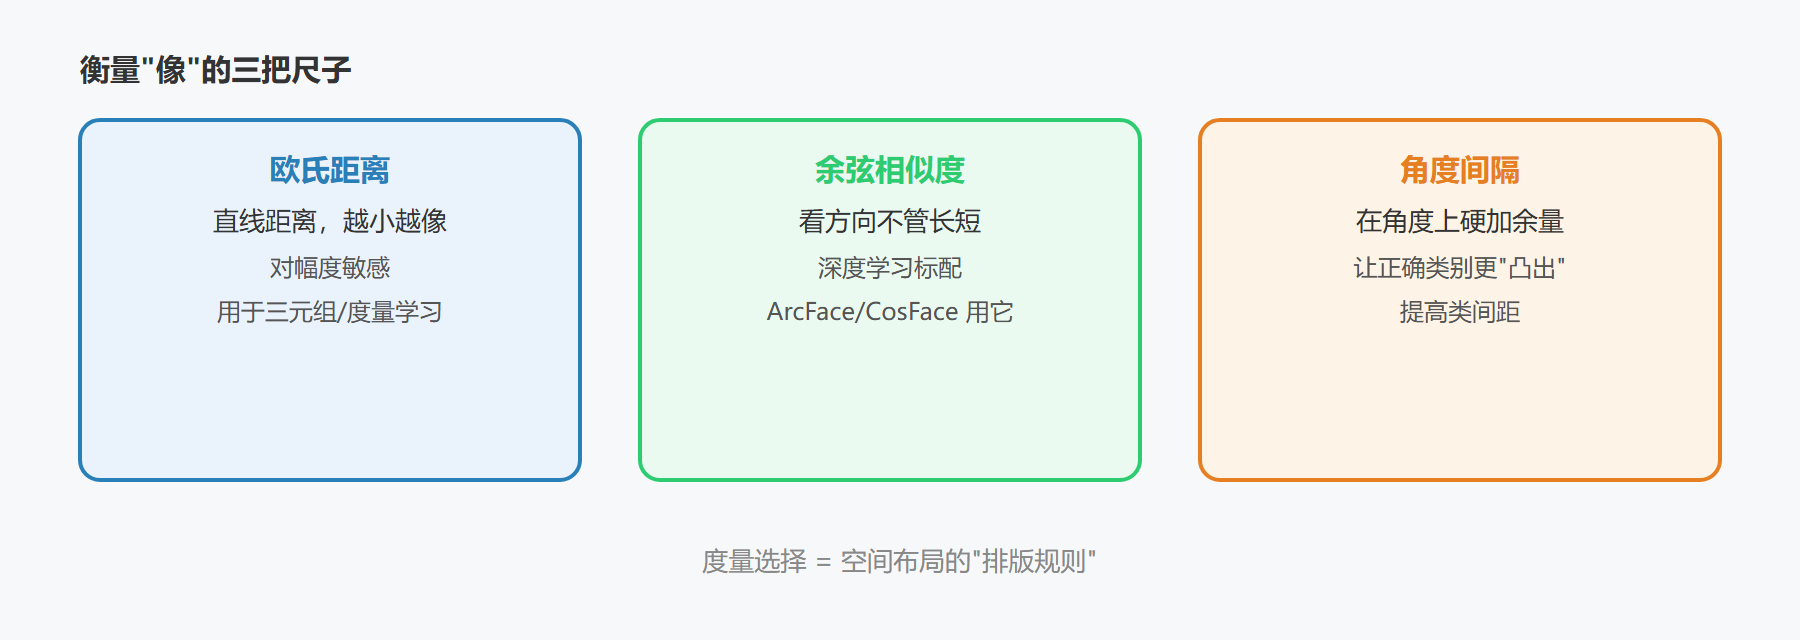
这张图把三类"布局规则"摆在一起:欧氏关心绝对远近、余弦只看方向、角度间隔干脆在角度上刻一道沟。实际系统普遍用"余弦"配"角度间隔损失",同时享受"抗幅度漂移"和"高类间可分"两种好处。
三类组织方式的取舍
| 方式 | 靠不靠标签 | 开集友好 | 典型代表 |
|---|---|---|---|
| 度量学习(三元组) | 用相对远近 | 是 | FaceNet |
| Softmax 改进(角度间隔) | 用分类头 | 强(约束下) | ArcFace/CosFace |
| 纯分类(Softmax) | 用类别标签 | 弱 | 基础分类 |
工程实践要点
- 选损失前先想清楚"你的库偏闭集(固定一批身份)还是开集(要接新朋友)"——闭集 Softmax 改进顺手,开放集对度量学习更宽容。
- 三元组训练务必上采样策略(坡线/难例),否则损失常年为 0、模型不动。
- 部署视角:一条 ArcFace 就足够为百万级库的主干稳定出一个不错的基线,别一上来就堆一堆花哨组件,先把水桶最短的那块补上。
- 后端比对统一用训练时的度量口径(通常余弦);别在推理环节换成欧氏,否则等于把模型白训一遍。
度量口径的一个决定性问题:闭集还是开集
布局空间之前,先问一个几乎能决定一切的问题:你要应对的是"闭集"还是"开集"识别。闭集意味着库里就那么一批固定身份,识别只是"在这批人里他是谁";开集则意味着今天库里的人、明天可能冒出新面孔。这个区分直接决定损失与度量的选择——闭集用分类式(Softmax 改进)顺手,开集因为不能给"没见过的类"安排标签,更依赖"相对远近"这种不依赖固定类别的度量(三元组就是典型)。很多项目翻车,就是因为没分清自己是闭集还是开集,照搬了一个不适配的布局方案。
为什么余弦配角度间隔几乎成了默认
落地时你常会看到"余弦相似度+ArcFace 一族的向量"这个组合,这背后有很具体的技术原因:人脸特征对"幅度"(模长)并不敏感——光线整体变亮或变暗时,向量的模会整体放大或缩小,用"只看方向"的余弦正好把这段幅度漂移抵消掉;而角度间隔损失在训练时就把"正确类别的方向要比别人更突出"这条规矩刻进了几何。两者是天然搭档:一个抗幅度漂移,一个抬类间可分。明白这层,你就不难理解为什么"训练按余弦、后端却改欧氏"会白训一顿——度量口径前后不一,长期积累的性能会被一个不起眼的改动吞掉。
特征多了未必好:维度与检索的取舍
很多人以为嵌入向量维度越高越好,其实不然。维度越高表达力越强,但检索成本也越大(在大库里每一维都带来查询开销),而且长尾的细小区分往往在低维就足够表达。真实工程常在某几个档位(128、256、512)之间选,读数据集精排时用高维、检索上索引时兼顾速度。实践建议:先用 256 起步,八成场景够用;只有当你明确穷尽了当前维度仍分不开某些难例、且硬件检索跟得上时,再往 512 加。维度不是越卷越好,够用才是工程语言的答案。
一句话直觉:空间布局的"排版",由你选的度量加损失共同决定;度量选"怎么量",损失选"怎么逼"。
空间布局的方案定了,可还得有人"一点点练出来"。下一节,我们把牵引空间布局的"裁判"——损失函数——单独拎出来讲个透。