3.2 数字调制与脉冲成形
3.2 数字调制与脉冲成形
编码后的比特要变成在频域里站得住、在接收端能读的模拟波形,靠两件事:调制把比特映射到载波的幅度、相位格点上,脉冲成形把符号串对应的频谱收进一窄条。本节用星座图讲清 QPSK 与 QAM 的权衡,再演一遍升余弦脉冲为何能削掉码间干扰。
学习目标
阅读完本节,你应当能够:
- 解释数字调制在"把比特换成波形"中的角色,画出 QPSK 与 16QAM 星座。
- 由调制阶数推频谱效率与误码裕度,说明为何高阶 QAM 高风险高回报。
- 说出矩形脉冲的频谱旁瓣哪来的,升余弦滚降又怎么把旁瓣压掉。
- 用一手动代码生成一条升余弦脉冲成形后的 I/Q 基带波形并查看其带宽收窄。
一、空口比特不止是"0 和 1"的电压
内行常说一句话:"空中飞的从来不是二进制,是波形。"调制干的正是比特到波形的翻译:既然载波是正弦,就把它当可调的模具——改变幅度与相位,就得到不同的"符号"。一个符号可同时承载多比特,靠的是把它映射到星座图上的若干格位。
每个符号带的比特数越多,单位带宽内塞的速率越高(频谱效率涨),但相邻格位更密、更容易被噪声挤错(误码率涨)。这就是调制阶数的"高风险高回报":QPSK 每符号 2 比特,16QAM 每符号 4 比特,256QAM 每符号 8 比特。速率按比特数涨,捕获后能分的空间却按 2 的阶数平方变形。观察一张星座图,能瞬间看懂这套心思在打什么主意。
QPSK 与 16QAM 星座对照
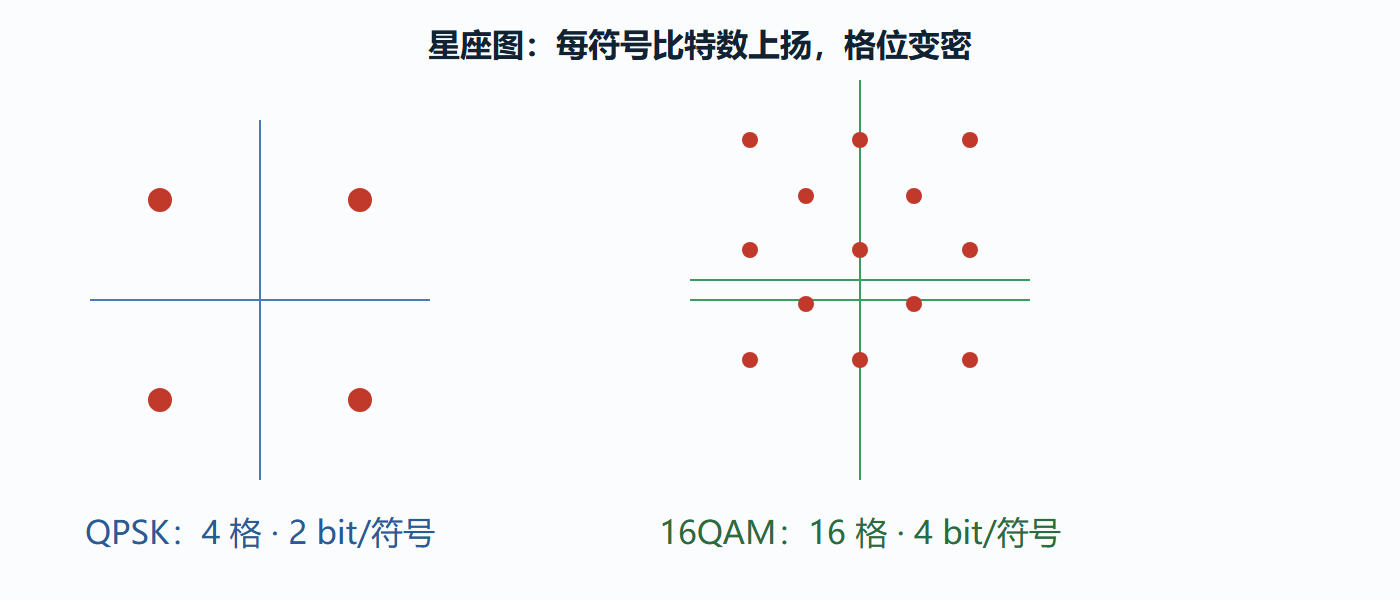
左图 QPSK 的 4 个格位分得开,抗噪余量大;右图 16QAM 一格塞了 16 个点,格距变小,判决阈值收紧。同一个发射功率下一格多装了些比特,代价就是更容易误码——所以 5G 会在好的信道条件上用高阶 QAM、条件差就退到低阶,这套动作就是自适应调制(AMC)的要义。
格雷编码值得单独提一句:它让相邻格位只差 1 比特。于是误码大多"跳一格",只错 1 比特而不是一小片,这对信道译码极友好——是几乎每一副星座图背后安静的约定。
用频谱效率这一把尺子把这些调制排个队更直观:单位 Hz 内每秒能传的比特数,理想情形下大致等于每符号比特数。BPSK 约 1 bit/s/Hz,QPSK 约 2,16QAM 约 4,64QAM 约 6——每升一档,频谱效率就上一条台阶,代价是所需的信噪比门槛同步抬高。这正是 1.3 节那句"信噪比容量对数长"在星座格位层面的具体实现:你要多挤一格比特,就得付出更多信噪比。看清楚这根"阶数-带宽-信噪比"的绳,你就看懂了发射端功耗与吞吐的那场拉锯。
二、脉冲成形:把频谱收进窄条
调完制,得到一串矩形脉冲叠加而成的基带信号——可这段信号的频谱旁瓣很大,直接发会占用大量频谱还扰邻道。于是让每个符号骑在一个设计好的脉冲上发射,这就是脉冲成形。理想下,脉冲应保证"一个符号在它的采样时刻不干扰邻居"——这正是削码间干扰 ISI 的核心。
最经典的是升余弦脉冲,频域滚降由参数 β(0~1)控制:
- β=0:频谱矩形骤变,带宽最窄,但时域脉冲无穷振荡、同步抖动就引发 ISI。
- β=1:充分滚降,时域衰减快、耐同步抖,但带宽 x2。
- 典型 β=0.2~0.35:带宽仅多出一点,换来对定时和抖动的巨大宽容。
听到有人抱怨"带宽明明够却多了那点滚降",多半没意识到滚降买的是"在真实不大完美的接收机上还能稳住"的鲁棒性。这条权衡贯穿整个无线:用带宽换对失真的免疫。
三、升余弦脉冲的完整演示
把"调制+成形"落成可复现代码,直观看到频谱到底收窄了。对一串 QPSK 符号做升余弦插值成形。
import numpy as np def rrc(t, beta, Ts): # 升余弦(根升余弦近似)脉冲 out = np.ones_like(t) out[t == 0] = 1.0 return out def raised_cos(t, beta, Ts): out = np.ones_like(t) nz = t != 0 out[nz] = 0.5*(1 + np.cos(np.pi*beta*t[nz]/Ts)) * np.sinc(t[nz]/Ts) out[t == 0] = 1.0 return out Ts = 1.0 sym = np.array([1, -1, 1, 1, -1, -1, 1]) t_grid = np.arange(-1.5, 3.5, 0.01) for idx, s in enumerate(sym): base = t_grid - idx*Ts seg = raised_cos(base, 0.3, Ts) * s if idx == 0: sig = seg else: sig = sig + seg if hasattr(sig, 'shape') else seg print("成形后的基带采样点数:", len(sig)) # 若把同一串符号用 β=0 矩形发,时域同样长,频谱带宽却明显更宽 print("波形范围示意:", round(float(np.min(sig)),2), "到", round(float(np.max(sig)),2))
跑完你会发现:矩形脉冲的旁瓣被升余弦收成一个瘦主瓣+温和尾巴,带宽利用率显著提升——这就是空口频谱"收敛"的那只手。
若把 β 从 0.3 改到 0,同一串符号的频谱会立刻鼓起高高的旁瓣、带宽变宽,看起来"更占地方";改到 0.6 又更宽更圆滑。亲手把 β 在 0 到 0.6 之间来回拨一遍,"滚降是拿带宽买鲁棒性"这句话就再也忘不掉了。
四、给实践者的取舍提醒
- 调制阶数不是越高越好:决策函数要考虑信道 SINR、天线数、覆盖目标。室内近距高 SINR 敢憋 256QAM,边缘弱场退回 QPSK。
- 滚降系数动的是鲁棒性:现场对同步抖动和移动毫秒敏感,宁选 β 稍大换稳定,也别卡着理论带宽极限。
- 成形与滤波一体:发射端成形、接收端匹配滤波常结合,滚降共享(根升余弦成对),跨成对使用才不纯损 SINR。
本节要点回顾
- 调制把比特映射到载波幅度相位格点,星座格位灵敏度决定误码裕度。
- 高阶 QAM 提频谱效率、增误码风险,靠 AMC 动态调阶平衡。
- 格雷编码让相邻格位仅差 1 比特,对译码极友好。
- 升余弦脉冲用滚降 β 换对定时抖动的免疫,带宽多出一点是划算的交易。
- 成形/匹配滤波常做根升余弦成对设计,别单边随意换窗。
至此,波形在基带打扮好了,下一步把它抬上射频、穿过发射链路的天线安全出门。