1.2 分布式换来什么与付出什么
1.2 分布式换来什么,又要付出什么
拆开数据是一场交易,不能只谈收益不谈代价。本节把这笔账分成两栏:换来的三样(可扩展、高可用、数据本地性)和付出去的三样(网络开销、一致性妥协、运维复杂度),最后用一个成本模型帮你判断"这笔买卖值不值"。不会做这笔账的人,装机拆完才发现运维成本高到养不动。
先回答一个劝退问题:拆了真有赚吗
很多人一听到分布式就热血上头,却忘了它先是一笔生意。单机时一套备份就够,拆成多台后运维、网络、一致性这三样成本接踵而至。真正老练的工程师在拆库前,一定先算清楚"多付的这三笔,能不能在容量、并发、可用性上换回更多"。这一节就是把这笔账摊开,替你在动工前先打好算盘。
学习目标
阅读完本节,你应当能够:
- 逐条列出分布式带来的三项收益,并说明它们各来自哪一方面的架构改变。
- 逐条列出分布式引入的三项成本,区分"可优化"与"结构性不可避免"。
- 用一个简单的扩容/运维/延迟成本模型,判断一个系统到底该不该拆。
从消费免单到算清楚价钱
上一节我们确认了单机会输,但只说"该拆"还不够。很多团队的翻车现场是另一种:他们也知道该拆,拆完却因为代价没预判,三个月后运维天天救火。所以这一节我们把生意做全,先把收益和代价各自摆上台面,再教你做判断。
二、换来的三样
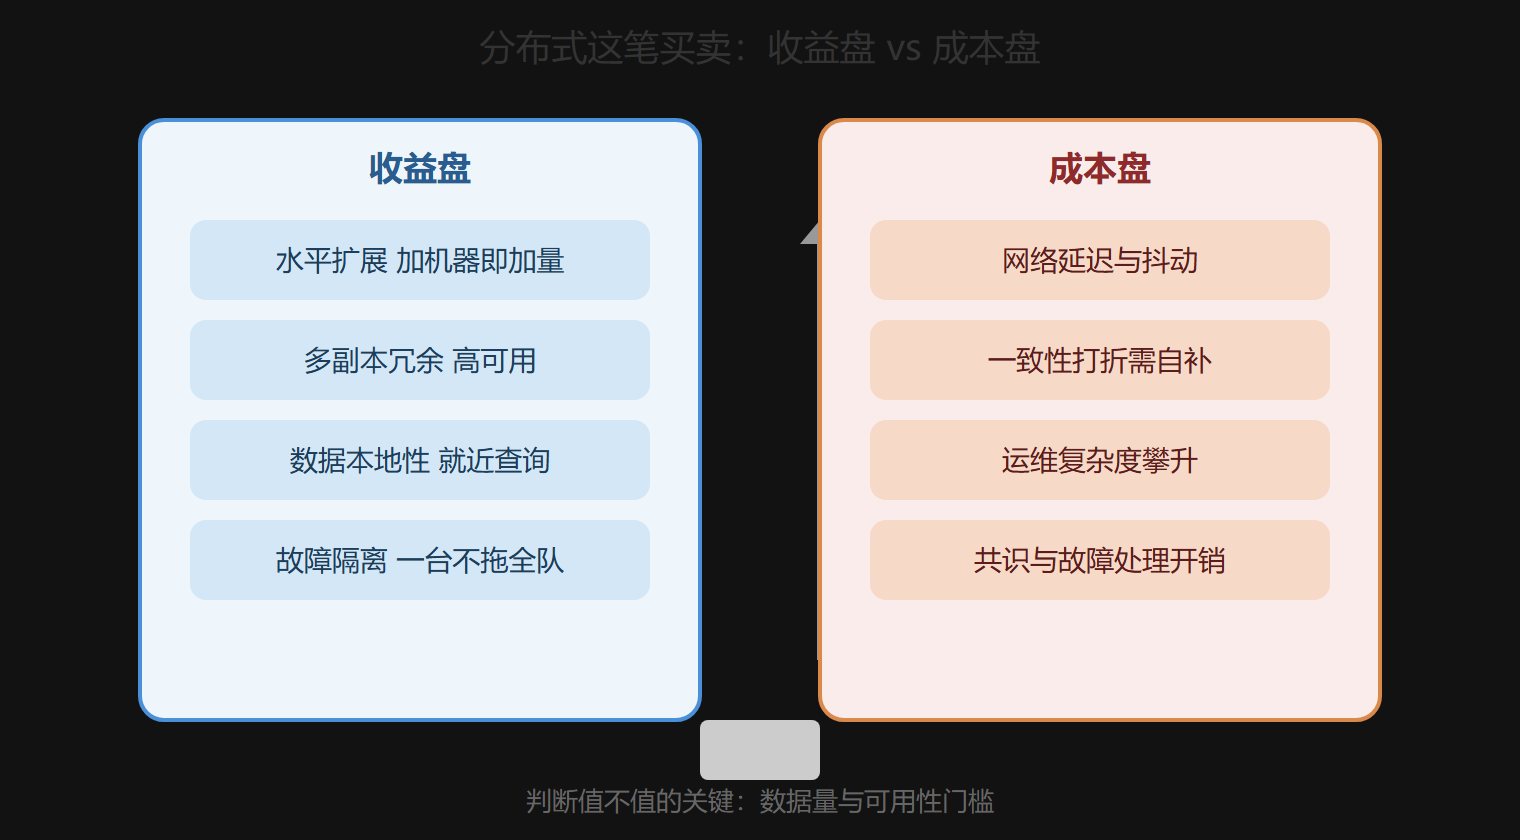
第一是真正的水平可扩展。 这是分布式最大的红利。单机扩容叫"垂直扩容"——换更大的机器,有上限、有成本拐点。分布式让你走"水平扩容"——多加几台便宜的普通机器,总容量和吞吐就线性往上走。TiDB、Cassandra 这类系统的广告语之所以敢喊"想扩就扩",靠的就是这个。扩容之所以能变成"加机器"这么简单,是因为数据被分片(第 4 章的主题),新增一台机器,只是给某些分片换了新家,不影响已经在跑的其他部分。
第二是高可用的冗余。 单机要可用性只能拼单台可靠度;分布式能通过"多副本+故障转移"把可用性做成除法——一台挂了,另一台副本顶上。这是从"三点九九个九"迈向"四个九、五个九"唯一的现实路径。学习时要注意,这个收益不是白送的,它需要第 6 章的共识机制来保证"顶上的那台拿到的数据是准的"。
第三是数据本地性带来的性能。 有时候你的数据本身就有很强的地域性——比如华东用户的数据放华东机器、华南放华南。分布式允许你把数据分布到离用户最近的节点,查询就近执行,网络距离短了,延迟自然降下来。这个收益在"规律分布"的数据上尤其明显。
三、付出去的三样
第一笔:网络不再是零成本。 单机里访问内存是几十纳秒,访问本机磁盘是几毫秒;一旦拆开,跨节点访问就是几十毫秒甚至上百毫秒,而且网络还会丢、会断、会抖。这句"网络不可靠"是所有分布式痛苦的共同来源。它没法被优化掉,只能被设计规避——这正是数据本地性、分片、路由这些手段存在的意义。
第二笔:一致性打了折扣。 单机数据库用 ACID 把一致性包圆了;分布式里,为了让系统在故障时还能响应(也就是第 2 章的 A 可用性),常常不得不让 C 一致性退一步,用"最终一致"来换时间。这一退,业务代码就要自己处理"刚写的可能读不到"这类脏读乱序。这笔代价业务的复杂度接下了。
第三笔:运维难度上升一个大台阶。 一台机器坏了修一台;十台、一百台机器,分布、扩容、监控、升级、故障排查全都变成系统性工作。你要部署调度工具、跟踪数据在哪、协调版本升级,稍有大意就出雪崩事故。这笔是"维持复杂度",随着节点数量的增长而增长,不会因为你熟练就消失。
四、一张收益与代价的天平
下面这张 SVG 把这场交易画成一台天平:左边是拆的收益,右边是拆的成本,想要判断值不值,就看天平往哪边沉。
收益与代价的天平
五、值不值的判定法
我把常用判断浓缩成一个三问排查:一是可用性真不真需要四个九。如果业务是后台报表、可以接受晚上停机,别为它上分布式;二是数据量是否越过了单机天花板,没越过就别用分布式给自己找运维麻烦;三是请求是否吃死并发或者需要跨地域。三个问题只要有其一明确命中,这单就值得做;三个都没命中,老老实实用单机是更划算的答案。
延伸一句经验:很多人以为"分布式=更先进",于是把只有几十条记录的配置表也塞进分布式。真到了现场你会发现,运维和网络的成本远大于那点想象中的收益。架构取舍不是选贵的,而是选匹配当前问题规模的。
六、用一本账把"值不值"算出声来
光有定性判断,很多团队还是会在"拆不拆"上反复横跳。真正做决定时,把三样数字摆到桌面:数据容量(单机盘是否已经吃到八成)、峰值并发(双十一那一下会不会破表)、可容忍的宕机时长(业务允许几分钟黑屏)。用一个具体例子算一遍:假设有 3 亿行订单、峰值 2 万 QPS、且业务要求核心订单一秒都不能断。单机方案需要一台超大规格机器,硬件贵、扩容要整机停机、峰值一破就直接全站不可用;分布式方案用 6 台普通机器按用户 id 分片,每台只扛自己那片,单台故障由副本顶着顶上,代价是多了几倍的节点运维、以及开发跨片查询的投入。两边都写"月硬件成本 + 峰值风险损失",高的那边就是答案。很多团队最后发现,真正让他们跨过这条线的往往不是容量,而是"峰值那一下不能挂"——这笔账没算清楚,取舍就永远是感觉不是决策。
七、拆完之后常见的三个翻车点
就算决定要拆,很多人照样会在开局就踩坑,提前给你排雷。翻车一:拆了反而更慢。分片键选得跟实际查询不匹配,"每条查询都全网广播",传输开销把单机时的保留优势全吃掉——选键要对着高频查询想,别为了均匀而均匀。翻车二:副本拷进来就再也不管一致性。异步副本偶尔读到旧值,业务代码却没做兜底,脏读直接漏到用户面前。翻车三:只做了分片、没做容灾,以为摊开就高可用,其实单台故障照样没人顶。这三个坑跟"代价"不是一回事——它们是你为"没想清楚"多付的学费,本可以在开工前就用几页设计文档省掉。
八、一张能贴墙的对照表
把上面的定性总结压成一张能给团队评审的对照表,用它决定"这单值不值得拆":
| 维度 | 换来的三样 | 付出的三笔 | 是否结构性 |
|---|---|---|---|
| 容量 | 水平扩展到够 | 分片与迁移成本 | 可优化为主 |
| 性能 | 并发被多台摊平 | 跨节点网络往返 | 结构性不可避免 |
| 可用性 | 多副本随时顶替 | 一致性必须妥协 | 结构性不可避免 |
| 容错 | 一台挂了有人顶 | 运维复杂度上台阶 | 可优化为主 |
这张表的价值在于逼你把"换来的"和"付出的"对齐起来看:凡是标注"结构性不可避免"的,无论你再熟练也躲不开,只能靠设计去规避;只有标"可优化为主"的,才有通过工具和流程把它压下去的余地。评审方案时,先确认哪几格是你最愿意付的、哪几格是业务根本付不起的,再定行程表上的优先级——这比临到上线才补一份运维计划靠谱得多。
本节要点回顾
- 收益三项:水平扩展、多副本高可用、数据本地性。
- 成本三项:网络不可靠、一致性打折、运维复杂度。
- 网络与一致性成本是结构性的,只能规避设计、无法优化消除。
- 三问判定法:可用性门槛、数据量、并发/地域,命中其一才跨线。
收益和代价认清后,下一节 1.3 带你给市面上五花八门的分布式数据库分家——数据模型、一致性、扩展方式,用哪把尺子去量它们。