1.3 按什么给分布式数据库分家
1.3 按什么给分布式数据库分家
市面上的分布式数据库有几十种,名字各不相同,但分类线索就那么几条:数据模型把人分成关系型、文档型、键值型、列式、图;一致性取向把人分成强一致与最终一致;扩展方式把人分成分片与复制两种。本节给出这两把主尺子和一张判定表,也顺带说清"传统 SQL 与 NoSQL、NewSQL"在谱系里的位置。
别被一长串产品名吓到,先看它背后有把真尺子
翻出一份动辄几十个分布的数据库清单,最容易做的就是死记"这个叫文档、那个叫列式"。可产品半年就换代,名字背得再熟也经不起时间。真正能长期用的,是背后那几把用来归类的尺子。把尺子立起来,你以后再见到陌生产品,不用背文案,量一遍就知道它大概合适什么业务。
学习目标
阅读完本节,你应当能够:
- 用数据模型、一致性、扩展方式三个维度给一个具体产品归类。
- 说清 NoSQL、NewSQL、传统关系库在一致性上的定位差异。
- 套用"数据模型匹配 + 一致性要求 + 扩展量级"三步,判断一个系统该选哪一类。
别急着记产品名,先记三把尺子
老人们总爱让你背一串产品名——Mongo 是文档、HBase 是列式、Redis 是键值……背是可以背,可产品天天出新,背是背不完的。真正抗得住时间的是背后的分类维度。我们先立三把尺子,再用它们去量具体产品。
一、第一把尺:数据模型
关系型把世界描述成二维表格,行是记录、列是属性,靠主外键把表联系起来。它适合关系稳定、需要复杂联表查询、且对数据完整性要求极高的业务(订单、账务)。它的弱点也一样明显:强 schema 约束让"字段随时变"的灵活业务难受。
文档型以 JSON 文档为单位存储,字段可随时增减,天然贴合"一条货品带一堆可变属性"的场景(商品、配置、用户画像)。它牺牲了跨文档的联表能力,换来的是接入便宜的灵活性。
键值型最简单,只支持按 key 存取整段 value,把并发和缓存做到极致(会话、热点计数)。它不关心 value 内部结构,因此也别指望它给你做复杂查询。
列式按列而不是按行存数据,压缩率高、扫描命中目标列快,是分析型(OLAP)工作负载的最爱;代价是单行完整读不划算,不适合点状更新。
图把实体看成节点、关系看成边,专门处理"谁认识谁、谁和谁有多跳路径"这类拓扑问题(社交、风控),代价是水平切分极难,很多图数据库干脆不做强分片。
二、第二把尺:一致性取向
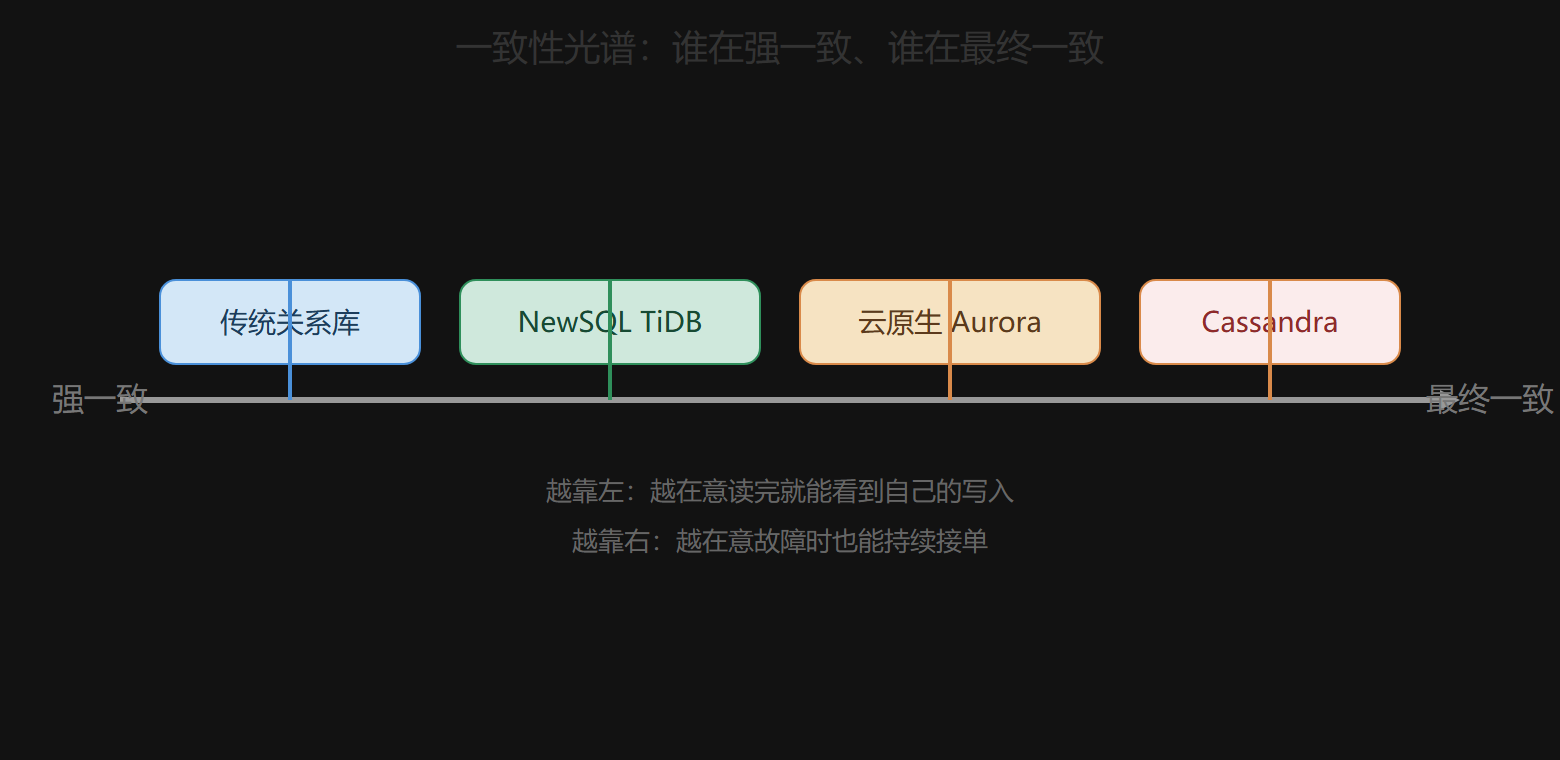
关系型数据库用 ACID 把一致性这件事做到底,写入即对其他事务可见、一旦失败全部回滚,这是"强一致"。分布式系统为了在故障时还能响应,很多时候不得不退到"最终一致":允许短暂读到旧值,但保证过一会儿会收敛到一致。在这两把我们常把 NoSQL 归到最终一致阵营、把 NewSQL 归到"既想要分布式水平扩展、又想保住关系型 ACID"的折中路线。后面第 2 章会用 CAP 定理解释为什么这两头往往难两全。
三、第三把尺:扩展方式
分片把数据按 key 切块分配到不同节点,每个节点存其中一块,有利于水平扩容,但跨片查询贵、事务难做。复制则把同一份数据在网络里放多份,利于容灾和读扩展,但引入一致性问题。成熟产品往往两者都上:先分片把数据摊开,再给每片做复制保证可用。
一张把主流产品摆上尺子的图
下面的 SVG 把三类典型系统并排放在"一致性"这根横轴上,从强一致到最终一致逐步过渡:
从强一致到最终一致的产品谱系
四、传统 SQL、NoSQL 与 NewSQL,一次理清
很多人被这三个名词绕晕。一句话总结:NoSQL 是"放弃关系模型与强事务、换取可扩展与性能"的产物;传统 SQL 是"宁要强一致也不扩到海量"的选择;NewSQL 是"想两者都占、通过新架构把关系型能力重新搬回分布式"的尝试。学了这把尺子你就不必背名字了:任何产品,先问它数据模型,再问它一致性取向,最后问它怎么扩展,三个答案一出口,这个系统在你脑中就有了坐标。
五、三步选型套路
把尺子用起来就三步。先看业务的数据模型,是表格、文档、键值还是列式,匹配的优先;再看一致性要求,读后必须立即读到自己的写,就往强一致那边选,能接受最终一致,你的选择面立刻宽很多;最后看量级,量级小到单机能扛就别上分布式,量级大到必须水平扩展,才进入分片型产品的地盘。三步走完,方向基本就锁死了。
快速判定表
| 业务诉求 | 更合适的方向 | 例举 |
|---|---|---|
| 复杂联表 + 强事务 + 海量 | NewSQL | TiDB、OceanBase |
| 灵活 schema + 弱关系查询 | 文档型 NoSQL | MongoDB |
| 极简单键并发 + 缓存 | 键值型 | Redis 集群 |
| 大规模分析扫描 + 高压缩 | 列式 | ClickHouse、Druid |
| 关系图谱 + 多跳遍历 | 图 | Neo4j |
六、拿三个真产品当立规矩的练习
尺子只背不练等于没学,教你把三把尺子套到三个耳熟的产品上:
- Cassandra:数据模型走"半结构化的宽列"(偏列式,但查询灵活);一致性取向默认最终一致、可调写读强七级;扩展方式纯粹靠分片 + 多副本。三坐标一出口——列族、最终(可调)、强分片。
- Redis 集群:键值模型的代表;一致性取决于集群配置,多数时间最终一致(主从异步);扩展靠"哈希槽"分片,才与数据模型的极简匹配。
- OceanBase:关系模型、招牌是拒不妥协的强 ACID、水平扩展靠分片与多副本共存。三坐标——关系、强一致、分片+复制叠加,正好是 NewSQL 的骨架。
做完这个练习你会发现,产品名会过时,坐标不会。下次同事抛给你一个不认识的库,你用三把尺子量一遍,几秒钟就能判断它大概适不适配手上的业务,而不用去背它的宣传文案。
本节要点回顾
- 三把尺:数据模型、一致性取向、扩展方式,任何产品都能用三坐标定位。
- NoSQL/NewSQL/传统是三种一致性立场的名字,不是割裂的产品类型。
- 分片与复制常常叠加:先分片摊数据,再复制保可用。
- 先匹配模型、再看一致性、最后看量级,选型方向基本就定了。
分家分明白了,就该进入第一块真正的理论地基。第 2 章的 CAP 定理,会解释为什么"强一致"和"高可用"时常只能保一头——这关系到你后面每一章做取舍时的底层逻辑。