2.2 BASE 与 ACID 的此消彼长
2.2 BASE 与 ACID 的此消彼长
单机数据库把一致性做到极致的武器叫 ACID;分布式里为了可用与性能,很多人倒向另一种哲学生活:BASE。BASE 不是"ACID 的反面",它是一套明确约定——基本可用、柔性状态、最终一致。本节把 ACID 为什么在分布式里那么难守住、以及 BASE 用哪三招来与之周旋,一次讲透。
学习目标
阅读完本节,你应当能够:
- 逐条说出 ACID 四个特性,并指出每个特性在分布式下的实现难题。
- 解释 BASE 三个词的含义,尤其是"最终一致"与"强一致"的根本差别。
- 依据业务对错误与延迟的容忍度,判断该用 ACID 式还是 BASE 式的设计。
先回看 ACID 到现在为止许诺了什么
ACID 不是一句话能解释完的概念,它其实是数据库对业务打的四个包票:原子性(要么全成、要么全不成)、一致性(事务前后数据库都处于合法状态)、隔离性(并发事务互相察觉不到对方中间态)、持久性(一旦提交,数据即便断电也不丢)。这四个包票在单机上能兑现,是因为数据库掌控着同一份内存、同一块日志、同一组锁。
一、ACID 在分布式里为什么守不住
把数据拆到多台机器,四个包票每一个都开始漏水。
原子性最难:一个事务要改华东和华南两颗节点上的数据,要么两边一起成功、要么一起回滚,可"一起"两个字在隔着网络的场景下本身就是个工程难题——你要一个协调者满世界发命令,而这恰恰是第 5 章两阶段提交要解决的,代价是性能与阻塞。
一致性最难守住的是对外可见的语义:单机里一个事务提交后,紧接着的读一定能看到它;分布式里因为副本异步、路由不同,很可能出现"刚写的订单,换台节点读就没了"的窗口。
隔离性最容易精致地失效:单机靠锁保证并发隔离,分布式里锁范围跨节点,一旦锁不住,就出现一个事务读到另一个事务写到一半的脏旧状态。
持久性反而相对好办:因为副本本身就是天然的持久层,数据能吃掉多次断电,代价只是要保证冗余的同步。
所以 ACID 不是"坏掉了",而是"在分布式下要不要保留它、以及能不能支付它的代价"变成了一个需要掂量的问题。
二、BASE 的三条腿:基本可用、柔性状态、最终一致
BASE 是一个不那么学术、却很贴合工程直觉的缩写:
基本可用(Basically Available):允许系统在极端情况下损失一部分可用性——比如查询返回稍慢、局部功能暂时降级,但不至于全盘崩溃。它的重点是"能兜底",而不是"永远满血"。
柔性状态(Soft state):允许系统在任意时刻,各副本之间的状态不完全一致——不一致在副本间可以"软"地存在,不需要立刻对齐到同一时刻。
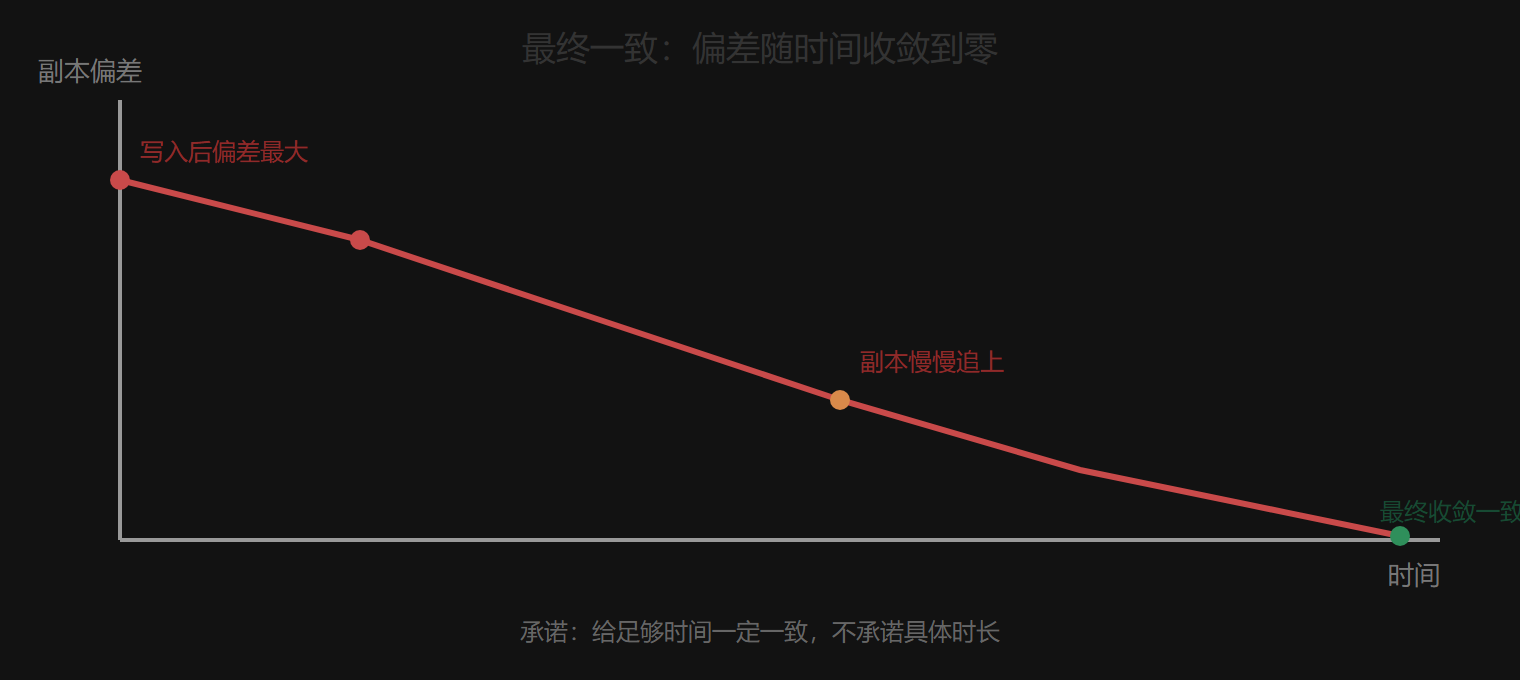
最终一致(Eventually consistent):在没有任何新写入的安静期之后,所有副本最终会收敛到同一个值。注意"最终"这个词——它没有承诺在多长时间内,只承诺"给足够的时间就会一致"。
一条从不一致到收敛的曲线
下面用一条随时间变化的偏差曲线,示意"最终一致"下副本差异怎么被抹平:
最终一致:偏差如何随时间收敛
三、ACID 与 BASE 怎么取舍,落到一句判断上
决定权不在一句口号,而在业务三个问题:一是这笔错误的容忍度——账错了能不能接受短暂对不上?二是读后立即能看到自己刚写的必须性——用户刷新立刻要看到自己刚下的单吗?三是延迟的底线——分区时必须马上响应,还是可以等?
给出一个务实倾向:涉及资金、库存扣减等"错得多不可逆"的场景,优先 ACID 路线,哪怕它慢一点;涉及粉丝数、点赞数、浏览足迹这类"多一个少一个无伤大雅"的计数,BASE 路线性价比极高。工程里更常见的是两者混合:核心交易数字走强一致,边缘聚合统计走最终一致,由路由把不同请求送进不同的"档位"。
ACID 与 BASE 一句话对照
| 维度 | ACID | BASE |
|---|---|---|
| 一致性立场 | 事务提交即对所有读者可见 | 允许短暂读到旧值 |
| 对错误的姿态 | 回滚到原状 | 补偿修正、收敛对齐 |
| 可用性取向 | 条件允许才承诺 | 分区时先响应再说 |
| 典型场景 | 资金、订单、库存 | 计数、足迹、推荐聚合 |
| 实现者 | 传统关系库、NewSQL | 多数 NoSQL |
四、一个你天天刷到、却在跑 BASE 的例子
说一个你可能每天都用、却意识不到它"正在 BASE"的例子:短视频/动态的点赞数与浏览量。假设某个爆款视频一秒涨几千赞,今天的主程序绝不会用"每点一个赞就写一个强一致的 ACID 事务、并让所有副本立刻同步"来处理——那样做,一分钱成本要用十倍的吞吐来扛,点赞动作还常常排队。真实做法是:点赞先落到本地队列/缓存,按批次异步同步到各个统计副本,页面上的数字可能滞后几秒甚至更多,但最终会收敛到真实总数。这个场景里,"点赞数偶尔比实际少几个、过几秒才补齐"就是最终一致在为你省钱,而它对产品完全无伤大雅。对照一下:同一条视频的账号余额充值就绝不能这么干——你充 100 元的记录要是也"最终一致"、晚几秒才可见,用户一刷新发现钱没到,立刻投诉。同一个产品里,点赞走 BASE、余额走 ACID,就是"混合是常态"最鲜活的日常例证。
五、同一个用例,把两手都摆出来
拿"电商下单"同一件事看 ACID 与 BASE 怎么分工最直观:下订单本身是核心动作——扣库存、记订单、扣余额,这一步必须 ACID,改到一半绝不能让人白付了钱却没拿到货;订单周围的体验——比如首页的成交榜、订单标签上的统计数、"本周已付款"这类聚合数字,走的却是 BASE,晚几秒甚至几十秒补齐都无所谓。于是同一个下单流程里,骨架是 ACID 的,外层的聚合数是 BASE 的。很多团队一开始纠结"到底全 ACID 还是全 BASE",真正落地后才发现答案永远是"核心走强、外围走最终"的混合体——这不是偷懒,而是对每一类数据按其风险各给一个恰当档位,本该如此。
本节要点回顾
- ACID 四包票:原子、一致、隔离、持久,分布式下前三个各自有难解之处。
- BASE 三词:基本可用、柔性状态、最终一致,是一套协商出来的妥协协议。
- 最终一致承诺"给时间必收敛",而非"多久收敛"。
- 混合是常态:核心走强一致、边缘走最终一致,用路由分档。
BASE 用"放弃强一致"换来了可用与扩展。但数据毕竟要落到某台机器上才能被读被写——下一节 2.3 讲数据分布策略:数据按什么规则切块,既决定扩容的效率,也决定跨片操作你付多少代价。