2.3 数据分布策略
2.3 数据分布策略:哈希、范围、列表
数据分布策略决定"每条记录应该住到哪台节点"——哈希靠取模均匀摊开、范围按区间切段、列表按枚举值归类。本节逐一讲清三种策略的原理、均匀性、热点风险、扩容代价,并给出一句选型直觉:哈希求均匀但牺牲范围查询,范围保区间但怕热点,列表直白却难撑大并发。
先做一道小学数学题:一条记录该住哪台
有一天你的订单表大爆炸,你决定把它摊给四台机器。你面前站着一群订单,每一条都得回答同一个问题:你住哪一台?答案不是拍脑袋,而是靠一种"分法规则"算出来。哈希、范围、列表,就是三种最常见的算"该住哪"的规则。先把这个小问题想透,后面所有策略都只是在换不同的算法规矩。
学习目标
阅读完本节,你应当能够:
- 徒手实现并解释哈希分片、范围分片、列表分片三者的分配规则。
- 对每种策略指出它最容易产生热点的那个环节。
- 依据"写入是否均匀、查询是否按范围、要不要平滑扩容"三问选分片键。
先想一个问题:数据为什么必须"摊"到多台
第 1 章说了容量和并发的极限,第 3 章会讲 Shared-Nothing 如何靠网络协作。而一切的起点是问:我不把数据摊开行不行?答案是不行——因为单机容量与并行都有天花板,而某台机器上的数据又是一份"一旦热点就堵死整条链路"的资源。那要怎么摊?摊的方式就是数据分布策略,它是一件具体到"取到什么 key、落到哪台机器"的活。理解它,比背一堆产品名有用得多。
一、哈希分片:均匀但丢了范围
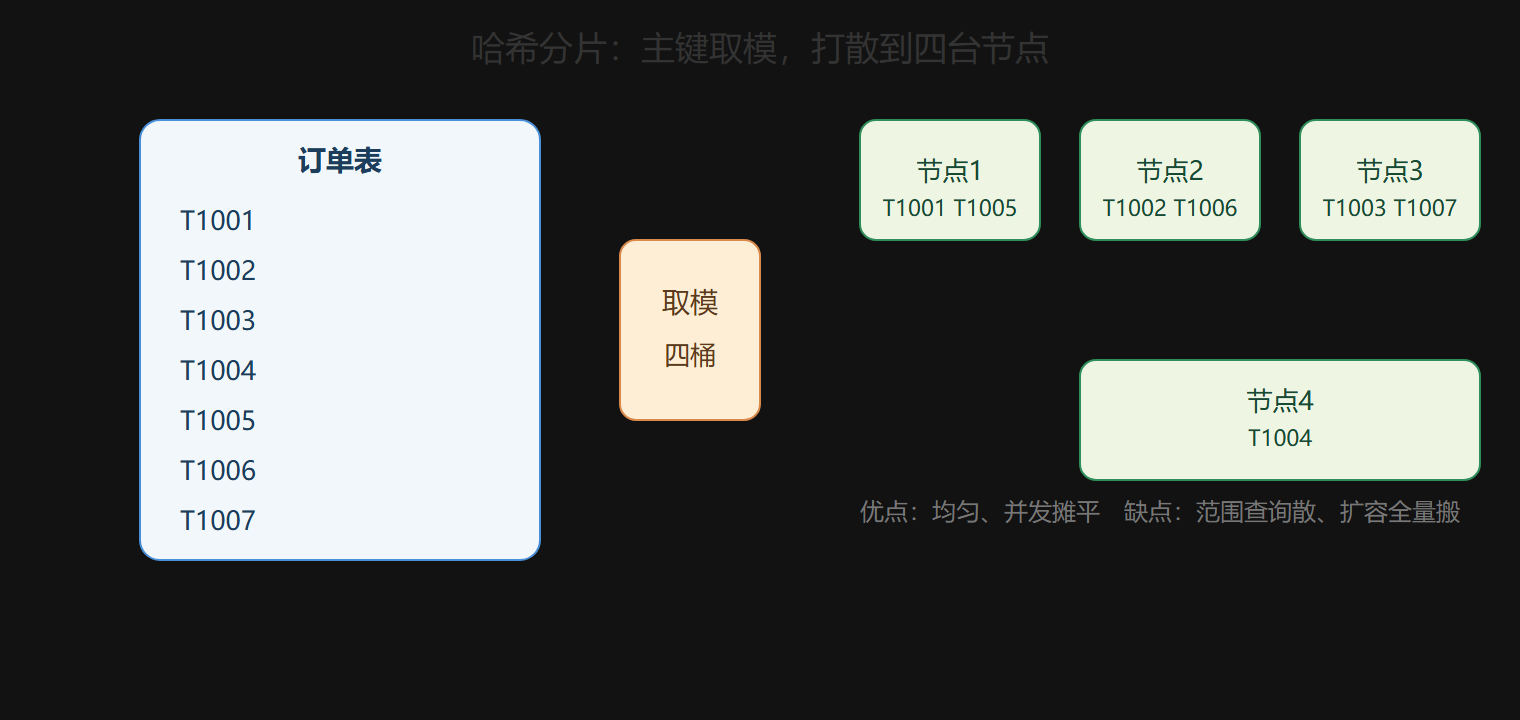
思路很直接:取记录的主键,做一个哈希,再对节点数取模,得到它该去哪个桶。伪代码只有一行:
节点号 = hash(主键) % 节点数量
它最大的优点是均匀——只要哈希函数够好,数据大致均匀地撒在每台机器上,热点很难集中在单点。写入并发也能被摊平。代价是范围查询变成了魔鬼:你想查"7 月和 8 月的订单",可订单主键是雪花 id,哈希后它们散落各处,你得把所有节点都问一遍,然后归并。另一个痛点是扩容时全量重hash:从 4 台扩到 5 台,取模的分母变了,几乎所有已有记录的新家都变了,迁移成本巨大——实际工程里常用一致性哈希来缓解,后面章节会讲。
哈希怎么把数据撒匀
下面这张 SVG 展示同一批订单按哈希取模后,如何被打散到四台节点:
哈希分片:一张表平摊到四台节点
二、范围分片:区间友好但怕热点
范围分片按主键的数值区间切段,比如订单按时间分:7 月 1 日到 7 月 15 日一块、7 月 16 日到 7 月 31 日一块。这在"天然有序"的数据上非常讨喜:你要查某个时间段的订单,路由到对应桶即可,几乎不用跨节点。而且管理直观、扩容时只要在区间边缘切一刀,迁移量很小。
它的暗坑正好和哈希反过来——热点。电商的活动日、月末的报表日,大量写入都涌向同一个时间区间,那个桶瞬间变成单点热点,等于把"分布式"退化成"一台更忙的机器"。所以范围分片适合"读写都集中在有序区间"的场景,但也最需要监控那个区间桶的负载,热点一到就要果断按更细粒度再切。
三、列表分片:直白但难放大
列表分片按枚举值归类,比如按城市分:华东放一台、华南放一台。实现最简单、语义最直白,用户也能理解"我这张表按地区分开了"。但它的问题几乎是结构性的——粒度太粗:北京、上海、杭州这几个热城会把对应城市桶堆满,冷门城市桶却一直闲着,负载极不均衡。一旦某眸桶爆掉,你又不能随便拆,因为拆分意味着跨桶查询和路由规则改写,代价很高。它适合"枚举值天然均衡"且"几乎不做跨类查询"的场景,多数情形只在小范围内用。
四、三种策略怎么选,一句话直觉
选策略前,先用三个问题逼问自己的数据:写入是不是要均匀?查询是不是经常按范围?扩容是不是必须平滑?如果前两个都要,你多半会陷入哈希与范围二择一的纠结——事实也大多如此,所以工程界的主流做法是:热点不明显的业务用哈希求均匀,天然按时间序且能容忍波峰的业务用范围分片,能接受桶不平衡的小场景用列表。没有银弹,只有与你业务负载的匹配度。
三种策略速查
| 策略 | 均匀性 | 范围查询 | 扩容成本 | 主要风险 |
|---|---|---|---|---|
| 哈希分片 | 好 | 差 | 高 | 扩容重hash、范围散 |
| 范围分片 | 视分布 | 好 | 中 | 区间热点 |
| 列表分片 | 依赖枚举 | 中 | 高 | 桶间不均衡 |
五、拿一张真实订单表把三种策略各试一遍
理论容易飘,落到一张具体的线上订单表上,差别马上显形。假设这张订单表有 3 亿行、每天新增 120 万行,分布在 4 台节点上:
哈希分片:主键取模。好处是写入天然均匀,双十一的峰值也被四台摊平,不会有一台独扛。代价是你想查"7 月 1 日到 7 月 8 日所有订单"就惨了——因为主键是雪花 id,这几个月的单子被打散在全部四台,你得广播所有节点再合并,花的时间够你喝杯茶。
范围分片:按下单时间切段,比如一天一段。查询"某天订单"是漂亮的一点路由,点开日历就调对应那几天。可代价也很典型:每天新增的 120 万行全写进"今天"这个桶,月末月初大促时,日桶的写入压力比别的桶大得离谱,热点就是这么来的。
列表分片:按城市分桶,比如北上广深独占一台。语义最直白,但北京、上海两个桶的接单量可能比西北几个省的合起来还多,桶间极不均衡;更麻烦的是用户想在店内跨城市查订单时,得跨好几台拼数据。
| 策略 | 摊均匀性 | 每日热点 | 范围查询 | 场景画像 |
|---|---|---|---|---|
| 哈希 | 优 | 无 | 差 | 点状读写为主、无明显冷热 |
| 范围 | 视分布 | 日日热点 | 优 | 按时间序、能容忍波峰 |
| 列表 | 差 | 热城爆桶 | 中 | 枚举均衡、几乎无跨类查询 |
看了这张对比你就能明白,为什么没有"最好"的策略,只有"最贴着你的写入与查询形态"的策略。
本节要点回顾
- 哈希:取模均匀、并发好,但范围查询散、扩容全量搬。
- 范围:区间有序、查询友好,但活动日等热点集中在单区间。
- 列表:实现直白,但粒度粗、穷桶贫桶不均衡、难放大。
- 选型三问:均匀?范围?平滑扩容?按答案对号入座。
数据摊到多台之后,每一份还得再留几张"备份",好让一台倒了顶得上——复制与一致性模型就接上了。下一节 2.4 把副本之间的关系与一致性档位对起来讲。