3.3 共享资源的两极
3.3 Shared-Disk 与 Shared-Memory:共享资源的两极
如果说 Shared-Nothing 是"协议联合起来各自为政",那 Shared-Disk 与 Shared-Memory 就是另外两极性相反的选项:前者共享磁盘让数据天然一处、后者共享内存把协调做到最快。本节把这两级的"极简"讲清楚,也把它们的"死穴"点破——一个瓶颈卡在盘的带宽,一个扩展被内存条锁在机内。
学习目标
阅读完本节,你应当能够:
- 画出 Shared-Disk 共享磁盘、Shared-Memory 共享内存的结构,并各自指出瓶颈点。
- 解释为何这两种"更省事"的架构反而更难规模化。
- 判断一个"共享存储"的数据库该用在哪类读写模型上才划算。
先给两种"反潮流"的选择正个名
上一节我们把 Shared-Nothing 讲得挺吃香,但真到了工程现场,Shared-Disk 和 Shared-Memory 也有它们的立足之地——只是立足地很特殊。它们不是"错",而是"另有用武之地"。学它们最大的价值,是反过来帮你理解 Shared-Nothing 为什么赢。把对手的软肋看清楚,才懂主流的强在哪。
一、Shared-Disk:数据天然一处,瓶颈也天然一处
Shared-Disk 让所有节点共享同一套存储。最有价值的收益是数据天然只存一份:你不用像 Shared-Nothing 那样操心"副本在哪儿、同步了没",因为大家读的都是同一块盘,一致性从根上就好做。很多传统的关系数据库集群,就是靠这个设计把"高可用"做起来的——节点挂掉一个,其他节点照旧用同一块盘,数据不丢。
可死穴也藏在共享盘上。这块盘是全集群唯一真身:所有节点都往它写,磁盘带宽就是硬瓶颈;而且它是个单点,盘一坏,整个集群一起瘫。更麻烦的是,为了让多个节点并发访问同一块盘不打架,往往还需要引入额外的元数据锁与协调,协调的开销很快追上没共享时省下的功夫。
二、Shared-Memory:协调最快,可扩展性最贵
Shared-Memory 让节点共享同一块内存。其吸引力在于内存是速度之王——读是纳秒级、写即时可见、并发协调几乎无延迟,这比任何网络的消息交换都快。但它有一个听起来就让人泄气的限制:内存没法像磁盘那样按需扩容,而跨机器共享内存的代价又高到离谱。结果就是 Shared-Memory 只能存在于单机内部(或者极少量机器)——一旦要往多核以外的机器扩展,成本与复杂度立刻爆表。它适合"单机内多核把一件事做到最快",却成不了"海量数据水平扩展"的答案。
两极的共享弧线
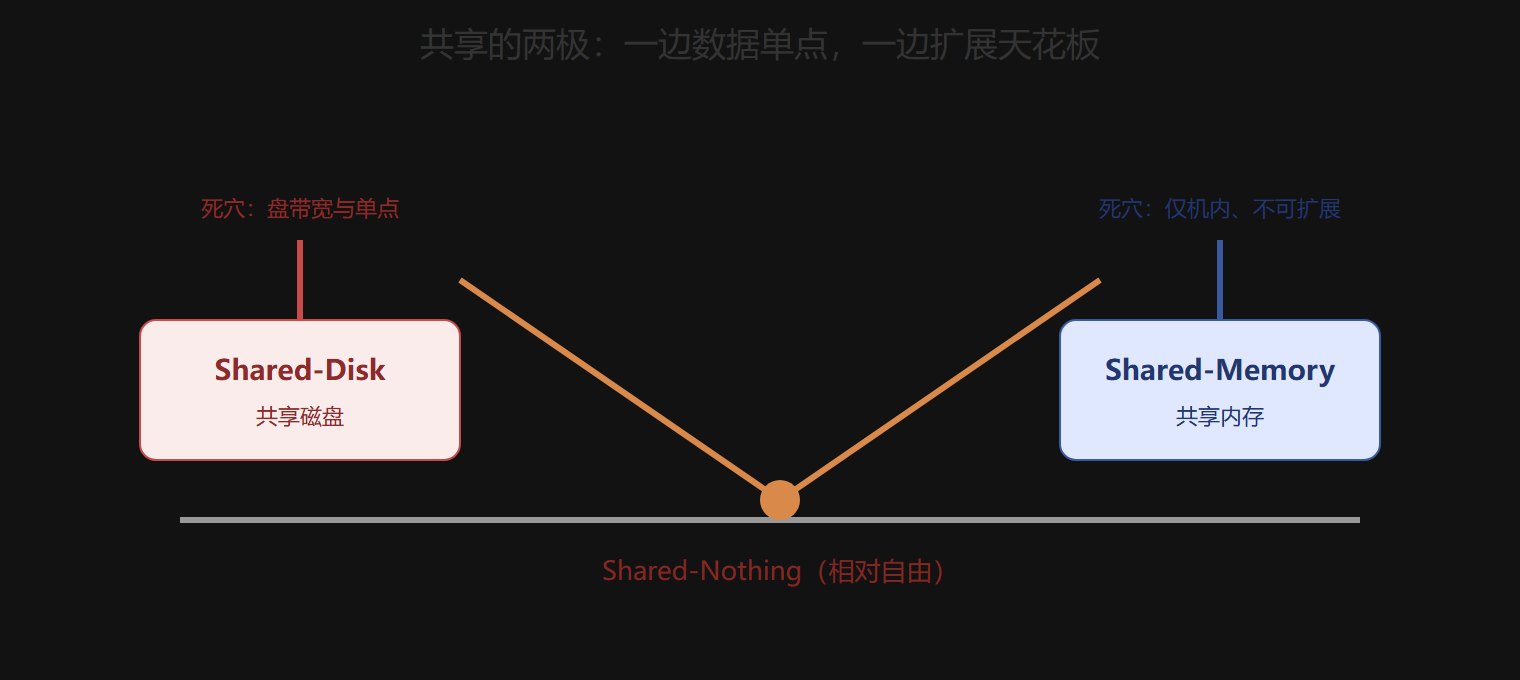
下面这张 SVG 把"共享的应力"画成一条压在两端的天平:一头是数据单点(Shared-Disk),一头是扩展天花板(Shared-Memory),中间是 Shared-Nothing 的相对自由:
共享资源的张力:两端各压着死穴
三、哪种场景才值得共享
判断要不要买单,看你的读写模型。Shared-Disk 胜在"数据单份、容灾稳",适合写少、读多、且把"数据不丢"看得比扩展更重的传统金融/报表类集群;Shared-Memory 胜在"协调快",适合单机内、多核把某块数据算到最快的场景(比如大规模内存数据库的某一部分)。而如果你要的是"数据量还会涨、并发还会冲、还想加机器续命",对不起,这两极都赢不了——这才是 Shared-Nothing 当道的原因。
四、同一个报表业务,三种架构怎么写
用同一件"每晚上跑的报表汇总"业务,把三种架构的日常写出来,你能很直观地感受"极简"和"死穴"各自落在哪:
Shared-Disk 这台:报表数据只有一份,晚上调度 20 个报表任务并发跑,全都读同一块共享盘。好处是数据天然一致、不用对账;可高峰期盘 I/O 被打满,个别报表能拖到凌晨四五点才出——你为"数据一致"付出的"盘带宽",在这里变成真实的运维痛点。
Shared-Memory 这台:白天把热点数据全塞进内存,计算飞快。一到深夜的报表,你想把全量数据也塞进内存,却发现内存早不够、机器也撑不起这么大内存,只能忍痛把一部分落盘——"内存是桎梏"的代价当场兑现。
Shared-Nothing 这台:20 个报表任务被分片摊到 8 台机器并行,每台只算自己那片,再归并。看似要多管副本和网络,但瓶颈是网络,网络最坏也就是慢一点,不会像共享盘那样单个物理资源直接把所有任务卡死。
| 关注点 | Shared-Disk | Shared-Memory | Shared-Nothing |
|---|---|---|---|
| 数据一致性 | 最好做 | 单机内极好 | 要共识保 |
| 最大痛点 | 盘带宽 | 内存上限 | 网络协调 |
| 高峰并发 | 被共享盘限制 | 内存扛得住 | 多机并行摊 |
| 容量长大 | 换更大共享盘 | 基本封顶 | 加机器就行 |
这个例子的结论还是那句:Shared-Disk 与 Shared-Memory 是"在小范围内把某件事做到极致"的选择,Shared-Nothing 是"为长大而生"的选择。你手上的业务若铁定长不大,选前者可能更省心;只要有一丝"将来要扩"的念想,就得认真考虑后者——因为架构的切换代价,远比一开始选对要高得多。
这里补一个容易忽略的现实:真正上线跑的分布式库,几乎从不在"纯 Shared-Disk"或"纯 Shared-Memory"里走极端。更常见的是把它们当成组件拆着用——比如某分析集群计算节点各自 Shared-Nothing,却把一份"只读热数据"挂到一块共享盘上给多台快读;又比如某库把"共享内存"用在单机内的多线程协调上,对外还是按节点摊开。理解两极的真正价值,不是死记"谁对谁错",而是看懂每块资源被公有时会带来什么代价、从而能在真实系统里识别出某一个局部的共享点,判断它是引入瓶颈还是图省事。这也是为什么架构课最值得练的,不是背三类定义的集锦,而是拿到一个系统能一眼说出"这里共享了 X,所以它要付 Y 的代价"。
本节要点回顾
- Shared-Disk:数据天然一处、容灾好做,但盘带宽是瓶颈、盘坏全集群瘫。
- Shared-Memory:协调最快,却只能机内运行,扩展被内存条锁死。
- 两极各有死穴,正反衬出 Shared-Nothing 在扩展上的相对自由。
- 对号入座:容灾优先选共享盘,单机极速选共享内存,要扩展就放弃共享。
三种共享类型都过了一遍,接下来该看集群内部的分工了——无论选哪类架构,节点里面都得有人当协调者、有人存数据、有人做副本。下一节 3.4 把"节点"细化成角色。