3.4 集群里的角色分工
3.4 集群里的角色分工
分布式集群不是一堆一模一样的节点,而是各司其职的角色拼图:协调者/协调中心负责全局指挥,存储节点真正落地数据,副本保可用,路由与查询代理负责把请求送对门,元数据服务掌握"数据在哪儿"。本节把这座调度室里的每个岗位都安排明白,也为第 4、6、7 章的分工细节铺好地基。
把集群当成一座调度室,先按岗位发工牌
别再纠结那几十台机器长得一样有什么好看。真正决定一个集群能不能扛事的,不是哪个机箱大,而是里面的工作岗位有没有分清楚、全局信息放在哪儿、单点有没有兜底。这一节我们不盯着机器的外壳,而是把它当成一座调度室,给每一个节点贴上它真实的工牌:谁是指挥、谁存数据、谁在答询。
学习目标
阅读完本节,你应当能够:
- 列出分布式集群的五个核心角色,并说明各自职责。
- 指出协调者、元数据这类"全局信息"角色为何最容易成为单点、如何防范。
- 用角色视角解释"为什么有的节点挂了系统还能继续跑"。
换个角度看集群:别盯着机器,盯着岗位
很多人第一次进分布式集群,看到几十台机器就晕了:每台长得都一样,到底谁说了算?其实判断系统成败的,不是机器长相,而是角色有没有分好、全局信息放在哪儿、单点有没有被兜住。这一节我们不看机器,只看岗位。把这座集群理解成一座调度室,每个节点身上贴着它的工牌。
一、五个关键角色
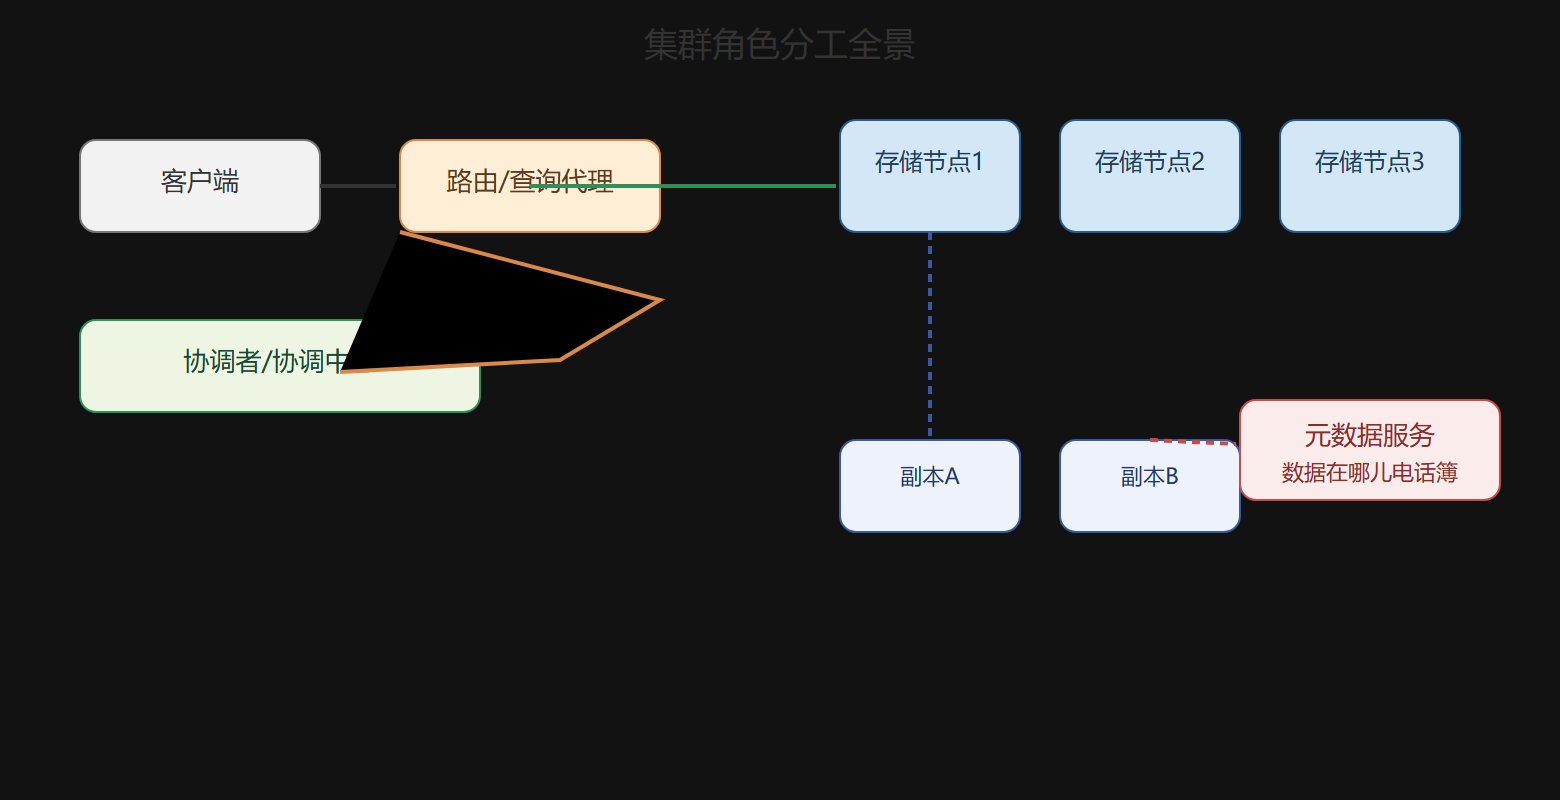
协调者/协调中心:全集群的"大脑",负责拍板全局决策——谁当主、日志推进到哪、一批事务要不要提交。它最容易当上却也最容易当刺头的身份,因为凡是"全局唯一的决策点"本身就是单点风险。成熟的系统会让这个角色也带副本、做共识(第 6 章),而不是让它孤零零坐办公室。
存储节点(数据节点):真正把数据按分片落盘的岗位,平时闷头干活:读本地盘、写本地日志、给副本发同步。它的工作越"本地优先",集群越健康——这正好呼应 3.2 的数据本地性。
副本:给某份存储数据放的第二份、第三份。它的价值是"主挂了能顶上、读能分点担子"。但副本多一分,同步与一致性的功课就重一分。副本是谁调度的、怎么保证改一份别的都知道,是第 6 章共识的事。
路由与查询代理:来一个 SQL,它负责先看"数据在哪个节点",再把请求分发给对应存储节点。它是用户请求进入集群的第一道关口,也是第 4 章"数据路由"的主角。路由要是带错路,用户就会看到"查个东西跑到十万八千里外"或者直接报错。
元数据服务:持有一张"数据在哪儿"的全局电话簿——哪片范围在哪个节点、哪个分片有几份副本。所有路由都得先问它。元数据一旦丢失或分裂,集群直接找不到自己的数据,因此它是最需要被重点保护、且往往也要靠共识维持的角色之一。
一张集群角色关系图
下面这张 SVG 把各角色放在一张集群布局里,标出请求从路由进来、如何指向存储与副本、元数据又在哪里称职:
集群角色:谁指挥、谁存数据、谁应答
二、为什么有分工就不怕单点
有人会问:有了这些"全局唯一"的角色,不就又制造了单点吗?答案是:分工确实制造了单点倾向,但成熟系统的应对是让单点角色也带冗余——协调者本身跑在多个节点上、靠第 6 章的共识选出一个为主;元数据也复制多份、多处一致。所以分工的意义不是"消灭单点",而是"把职责隔离、让每个单点都有副本兜底"。这跟你一个人既当指挥又当会计又当仓库是不同的安全模型:职责分开,各自都有备份,垮掉哪个都有顶上。
三、一张角色速查表
| 角色 | 核心职责 | 最容易出的事故 | 兜底手段 |
|---|---|---|---|
| 协调者 | 全局决策、事务提交、选主 | 决策单点停滞 | 共识选主、高可用副本 |
| 存储节点 | 落盘、写日志、本地执行 | 磁盘故障 | 副本 + 故障转移 |
| 副本 | 冗余与容灾 | 同步滞后 | 写多数、读多数 |
| 路由/代理 | 把请求送对节点 | 路由错误 | 元数据校准 + 重试 |
| 元数据 | 记录"数据在哪儿" | 丢/分裂 | 复制 + 共识保护 |
四、一次故障转移,让每个角色各就各位
把这些角色拉到一场"存储节点挂了"的故障里,分工的价值立刻显形。假设某存储节点 A 突然宕机,而它正好持有一片客户表的主副本:
第一步,心跳先报丧。 别的节点发现 A 的心跳超时,元数据服务把它标记为"失联",协调者(或共识选主逻辑)开始接管决策。
第二步,副本顶上。 A 那片数据的副本被提升为主,读写流量从"去 A"改到"去新的主"——这背后是路由与查询代理拿着元数据改指方向。
第三步,补副本保容错。 系统扫描发现"这块数据现在只剩一份主副本,多数容错率不足",于是调度一个新的健康节点,把这份主的日志与数据同步过去,重建好第二个副本。
第四步,元数据刷新。 新副本落位后,元数据里"这片在哪些节点"的条目更新为最新版本,路由从此指向新的组合。
| 事故中的角色 | 干的那一步 | 不出这台会怎样 |
|---|---|---|
| 心跳/探测 | 发现 A 失联 | 一直以为 A 还在,读写送死门 |
| 元数据 | 标记失联、刷新映射 | 新主落位了路由还指旧门 |
| 协调者/共识 | 拍板谁顶上 | 两处都抢着当主,脑裂 |
| 副本 | 顶替主继续服务 | 数据直接蒸发 |
| 路由/代理 | 改道去新主 | 用户查个东西永远碰壁 |
从头到尾没有哪个角色"特别忙",但每一步都缺不了。这印证了分工的真实用意——不是把活推给某个英雄节点,而是把"发现、决策、顶替、改道、重建"各安排给不同岗位,任何一个岗位有兜底,系统就能继续转。这比让一两台机器包揽所有事要安全得多:职责越散,单个节点的重要性越低,整座调度室越难被一棵点的故障拖垮。
本节要点回顾
- 五角色:协调者、存储、副本、路由/代理、元数据,各司其职。
- 单点不靠消灭,靠兜底:每个全局角色都带副本与共识。
- 元数据与协调者最金贵:丢了连自己都不知道数据在哪儿。
- 路由是第一道关口:送错一台,用户立刻感知。
角色分明了,接下来就得让数据真的住进这些岗位、并且能被精准找到——第 4 章讲数据分布与路由:分片怎么摊、复制怎么留、路由怎么把请求送对门、元数据这本电话簿又怎么维护。