8.2 NoSQL 为规模而生
8.2 NoSQL:为规模而生的各族
NoSQL 不是"一个数据库",而是一个大致"放弃关系型纪律、换取海量扩展与性能"的大家族。文档型(MongoDB)、键值型(Redis 集群)、列族型(HBase/Cassandra)各有一套取舍。本节逐一拆这三大族各自"兑了什么、放掉什么",并教你凭数据形态选对那一族。
学习目标
阅读完本节,你应当能够:
- 区分文档型、键值型、列族型 NoSQL 的数据组织差异。
- 对每族指出它最强的场景与最明显的短板。
- 用"数据结构 + 查询形态 + 一致性容忍"给一个产品对号入座取名。
把它当"一个库"看,往往会看走眼
很多人把 NoSQL 当成"一个能存大数据的库",这本身就是误解。NoSQL 是一群"用不同方式组织数据、共同追求往海量扩"的异族。它们唯一的公约数,是"不像关系库那样被一张张强约束的二维表、以及跨表事务也就是 ACID 拴着"。它们各自长得很不一样:有的像文档柜、有的像记事本、有的像档案架的列。学 NoSQL 的正确姿势不是背名字,而是先分清"三大族各自组织数据的方法与代价"。
一、文档型:像装满可变图纸的档案柜
MongoDB 是文档型代表。它每份数据是一张"JSON 文档",schema 可随时增删字段,非常贴合"一条内容带一堆可变属性"的现代业务(商品、用户画像、帖子元数据)。查询是"面向文档的",也支持一定程度的数组与嵌套。它的缺口是跨文档事务弱、复杂联表难过——你很难指望"一口气把一张订单和它的几十条明细在一个事务里原子搞定"。适合"数据灵活、以单文档读写为主"的场景。
二、键值型:把事情做到最薄的存取
Redis 集群和各类键值库把模型压到最简——按 key 存取一段不透明的 value。它不关心 value 内部结构,因此能做到极高的并发与缓存吞吐,是"热点会话、计数、缓存"的统治者。代价是查询形态只有按 key 一种,你在 value 里面做的索引、范围、聚合统统得靠应用自己来。适合"读写都集中在 key 上的简单命中"。
三、列族型:把档案按列立起来
Cassandra、HBase 走列族路线。数据按"行键 + 列族"组织,逻辑上更像"按行和列族的宽表",但物理上按列存储、压缩高、擅长海量数据的随机读写与范围扫描。Cassandra 以"近乎无限的水平扩展 + 最终一致"闻名,HBase 则挂在 Hadoop 生态上做海量列的随机读写。它们共同的短板是一致性偏最终、复杂跨行事务难做。适合"海量数据 + 按行/范围为主的读写"。
三大族的定位棋盘
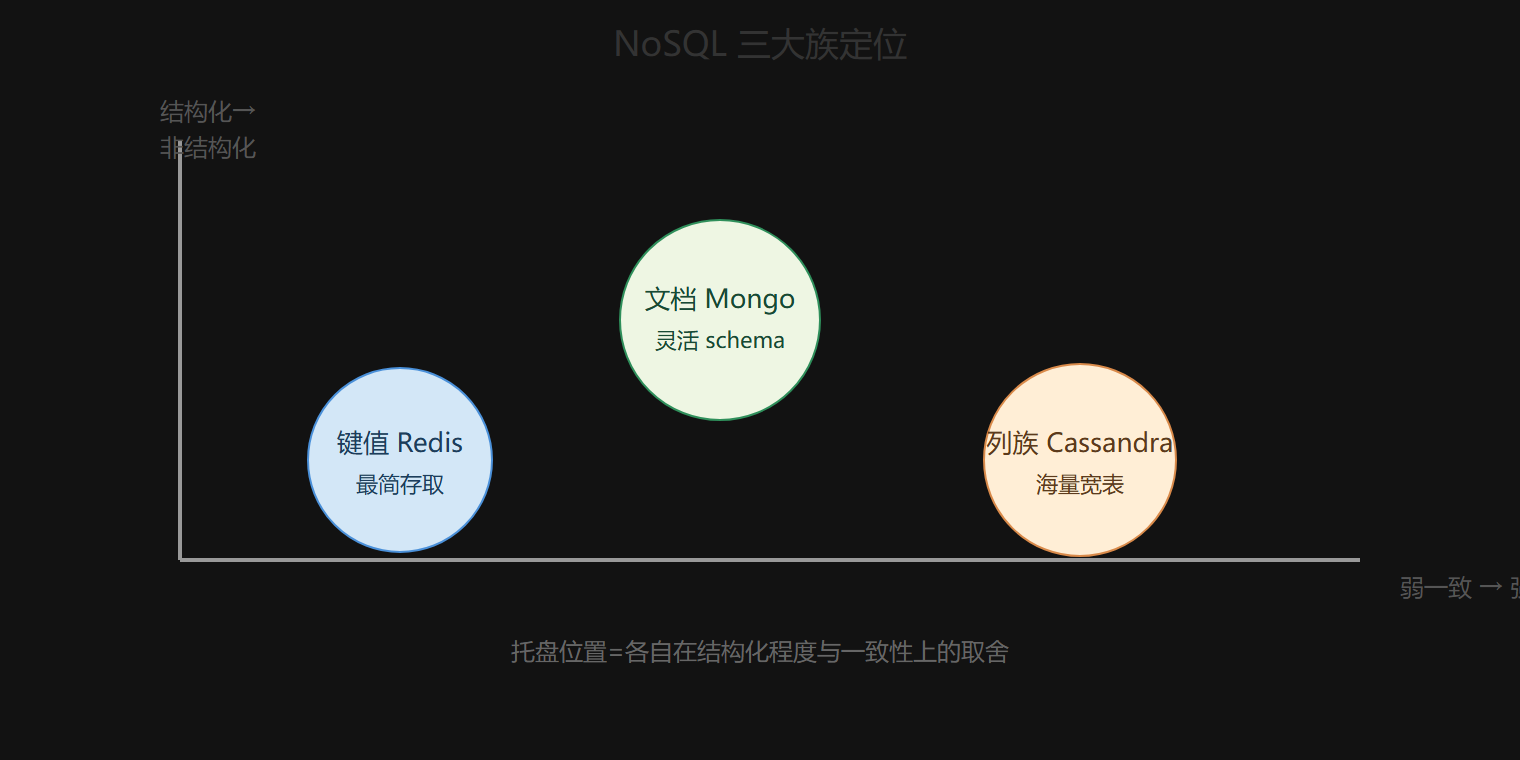
下面这张 SVG 用"数据结构"与"一致性取向"两轴,把三大族摆到棋盘上:
NoSQL 三大族:两个维度定位
四、怎么挑对那一族
选 NoSQL 那句三问再套一遍:一是看你的数据结构,灵活多变选文档、简单键值优先选键值、海量列任意选列族;二是看你的查询形态,按 key 命中带缓存用键值、按单文档读写字用文档、按行/范围扫海量用列族;三是看你容忍的一致性与事务要求,需要强事务的,NoSQL 大多不是你的主场。三问一出,族基本就锁定了;再用具体产品(Mongo vs Cassandra)去比较生态与写路径,就足够落地了。
四、同一个系统,怎么被三大族各自扛起来
拿一套"用户会话 + 画像 + 动态"的互联网系统,看三大族怎么各占一头:
- 会话:登入即用、超高频按 key 读写——键值型专治这种点读,万级并发下依旧丝滑。
- 画像:每个用户一堆可变属性,头像、偏好、标签随时增减——文档型天然贴合,字段怎么长都行。
- 行为流:海量日志按"用户 id + 时间"范围扫描做分析——列族型擅长海量随机读写与范围扫,按列压缩还省盘。
| 部分 | 用哪族 | 关键卖点 | 放掉的 |
|---|---|---|---|
| 会话 | 键值 | 超频点读 | 不能复杂查询 |
| 画像 | 文档 | 字段可变 | 跨文档事务弱 |
| 行为流 | 列族 | 海量扫描 | 强事务难做 |
这个分工用一个生态就把三种形态塞进去,只因为它们各取各的数据形状。再看一致性,这套系统几乎从头到尾都"最终一致"就够:会话丢了能重登、画像晚几秒同步无关痛痒、行为日志本来就是异步上报——所以 NoSQL 在这里毫无压力;但凡换成资金、库存这种"错不得"的核心,号里就立刻拧紧:要么强一致、要么根本不进 NoSQL。
把这两层(数据形态 + 一致性容忍)一起想清楚,你选 NoSQL 时就不是"听说谁好就上谁",而是"我的数据是这三块里的哪一块、它能容忍哪档一致"——这才是用 NoSQL 的正确姿势,也最不容易在满屏的"某某库很快"声里走偏。
五、一条别让 NoSQL 兜底的界限
把三大族的优点说得再热闹,也得划一条底线:凡是"错不得、错不起"的数据,别轻易交给默认最终一致的 NoSQL 去托底。 账务、余额、库存、授信额度——这些一旦串一分、超卖一件就是事故的数据,要么绕开 NoSQL、要么在业务层单独为它拧上一圈强一致箍,绝不能让"最终一致"替它们兜底。NoSQL 的强项是"量大、扩展、性能",软肋恰恰是"强事务与强一致",拿它的长板去补账务,等于用错工具。
| 数据类型 | 交给 NoSQL? | 为什么 |
|---|---|---|
| 登录会话 | 放心 | 丢了能重登,最终一致就够 |
| 用户画像 | 放心 | 字段可伸展,强一致非刚需 |
| 行为/日志流 | 放心 | 异步上报,晚到无感 |
| 订单金额、余额 | 不放心 | 错一分都算事故 |
| 库存数量 | 不放心 | 超卖直接出大事 |
一句话收束:NoSQL 负责让你"存得下、读得快",事务责任要靠那套强一致通道来扛。 这条界限一旦划清,你的架构才算真正立住了——也才不会被满屏的"某某库很快、很能扩"带着,把不该交出去的数据随手扔给一个只管扩展的朋友。
本节要点回顾
- NoSQL 是家族不是单库:三大族数据组织与取舍各不同。
- 文档型:灵活变、单文档好,跨文档事务弱。
- 键值型:最薄模型、并发极快,查询只剩按 key。
- 列族型:海量宽表、按列压缩,一致偏最终。
- 挑典型三问:数据结构、查询形态、一致性容忍。
三大族之外,还有两条"另有所为"的专线——云上被托管、连运维都想省掉的云原生,以及把"分析扫描大表"做到极致的 OLAP。下一节 8.3 把这两种专门的系统再讲个明白,然后我们收尾到选型。