8.3 云原生与 OLAP 各取所需
8.3 云原生与 OLAP:两条"另有所为"的专线
前两节是"通用扩展"的两派,本节再补两路把某一件事做到极致的特化阵营:云原生库(Aurora、Spanner)把数据库变成云上托管服务、想替你把运维与弹性一起管了;OLAP 库(ClickHouse、Druid)为"扫描巨大分析表"量身定制,用列式存储把"只扫几列就飞快"做成招牌。本节拆这四者的定位与选型。
学习目标
阅读完本节,你应当能够:
- 说清云原生托管库"替你省掉什么、你又付出什么"。
- 解释列式存储为何能把分析扫描做到行式望尘莫及。
- 在一张对比表里为"OLTP-高并发-强一致"与"OLAP-大扫描-分析"两类负载各挑到合适的系统。
还有两种系统,是在打另一场的仗
讲 NewSQL、NoSQL 时,我们默认"你要自己拥有一套库"。可在真实世界,还有两个阵营压根不按这个思路出牌。一个是云原生,它想的是"你连库都不用"——资源我托管、弹性我调度、备份我负责;另一个是 OLAP,它想的是"普通库面对海量分析太慢"——我把存储结构拧成专为扫描而生的形状。这两路都不是"通用扩展"的替代,而是"专治某一类需要"。读懂它们,选型的地图才算铺全。
一、云原生:把数据库变成托管服务
云原生数据库的卖点非常直白:你调用 API 拿库,弹性和运维交给云平台。 比如 Aurora 把存储层抽成云上的分布式存储,计算节点无状态地连到它,写多一份到存储就算成功;谷歌 Spanner 则干脆把"全球分布 + 强一致"做进云里,靠共识加全球时钟给出一致的时间保证。它们的共同好处是免运维、弹性可伸缩(扩缩容几乎动动配置就行);共同代价是弹性带来些许不可预测、以及厂商锁定——你想迁回自建或换云,成本就上来了。
二、OLAP:把"大扫描"做到极致
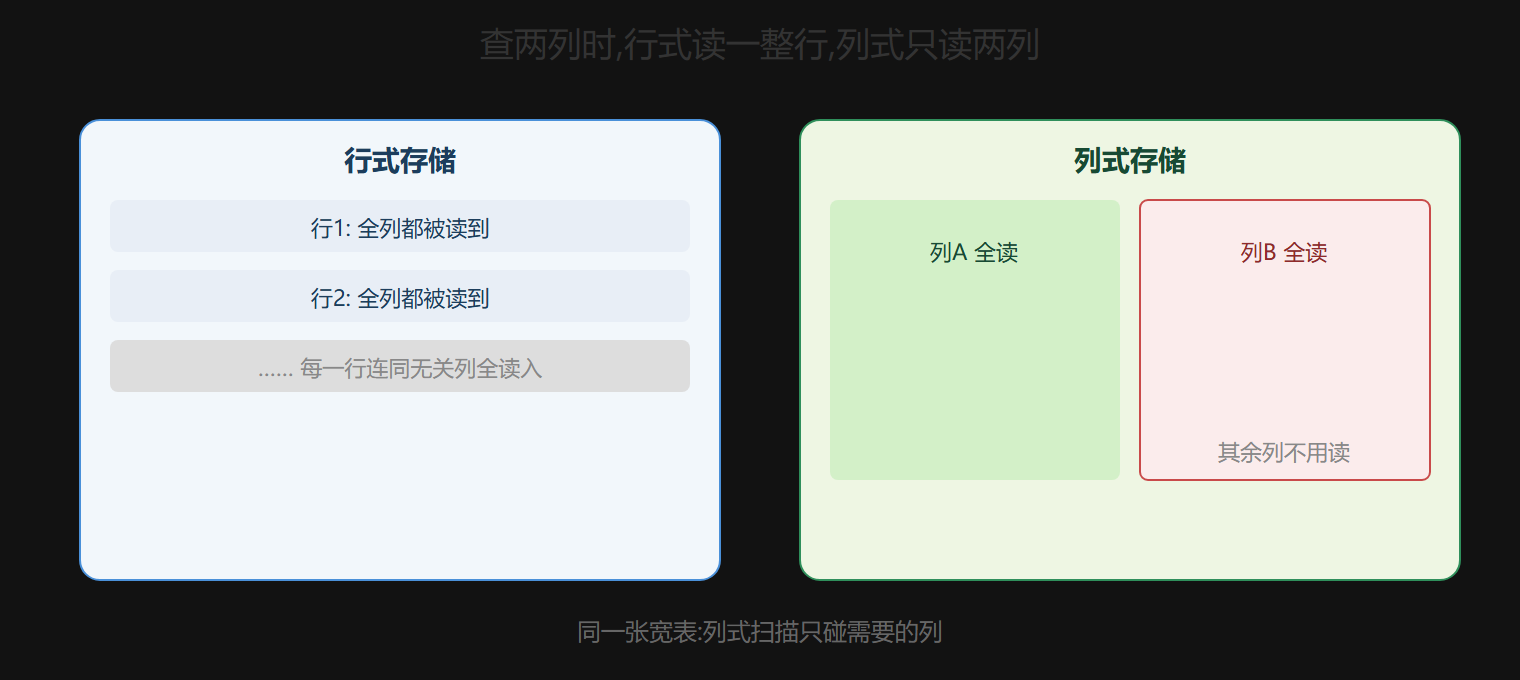
把查询分成两类就懂 OLAP 了:**事务型查询(OLTP)**看重的是"点状读写快";(分析型查询、OLAP)看重的是"对一个超大表做扫描与聚合快"。普通行式存储,你要查"某产品过去一年的月销售额",得把整表行一行行读CPU把需要的列抽出来,慢得离谱。列式存储让数据按"列"而不是按"行"连续存放,压缩率高、且扫描时只需读你点名的那几列、其他列看都不看——于是聚合类分析快得飞起。ClickHouse、Druid 正是这样一门心思为分析扫描而生的系统。
行式 vs 列式:同一张表两种摆法
下面这张 SVG 比较同一张宽表的数据在"行式"与"列式"下的物理摆放,以及"只查两列"时它们各读了多少:
行式与列式存储的读取差异
三、把四类概括进一张选型地图
到这里,本教程盘过的主要系统可以收进一张总表,供实战快速对号:
| 类型 | 核心卖点 | 主代价 | 最配负载 |
|---|---|---|---|
| NewSQL | SQL+ACID+扩展 | 复杂度/运维 | 核心交易 OLTP |
| NoSQL-文档 | 灵活 schema | 弱跨文档事务 | 内容类单文档读写 |
| NoSQL-键值 | 极简高并发 | 查询只剩按 key | 缓存/热点计数 |
| NoSQL-列族 | 海量宽表 | 最终一致 | 海量按行/范围读 |
| 云原生 | 免运维弹性 | 厂商锁定/弹性抽风 | 想少扛运维 |
| OLAP 列式 | 大表扫描快 | 点查/写路径弱 | 数据分析聚合 |
挑的时候,先用"负载类型"卡一刀:事务型需求进左侧四类、分析型需求进 OLAP、想要少扛运维就把云原生放进候选;再用"数据模型 + 一致性"补刀,基本就锁死了。
四、同一套系统,云原生与 OLAP 各占一席
把两类负载放进同一家业务里,你立刻看清它们各管一段。假设一个电商,底层数据落在云原生托管库上(Aurora 这类托管库托着下单、改库存、登录这些 OLTP 写读);上层却要跑"过去一年各品类销售额、回头客占比"这类跨海量行的分析——这种超大扫描如果也去压事务库,正常的读写早就被拖垮。于是另起一个 ClickHouse 这类 OLAP 列式库,用 ETL 把事务库里的明细按小时间步批量灌进来,分析查询全走它。
| 负载 | 交给谁 | 数据往哪流 | 为什么这样分 |
|---|---|---|---|
| 下单/改库存/登录 | 云原生事务库 | 实时写入 | 点状读写、要强一致 |
| 销售报表/品类聚合 | OLAP 列式库 | ETL 周期性灌批 | 大扫描、列式飞快 |
| 商品详情缓存 | 键值/文档 | 前端就近 | 高频点读 |
这个"存量在事务库、分析走 OLAP"的双线架构,是今天绝大多数大数据业务的标配。忘掉"谁打败谁"的零和想象吧——它们不是竞争关系,而是一个在前台守住每笔事务、一个在后台吞吐全量分析,各按各的数据形状干活。真正的功夫,全在那条"多久导一次、用什么口径对齐"的 ETL 管道上,而不是纠结选哪个库更高级。
五、一句把选型锁死的口诀
把云原生与 OLAP 的取舍各压成一句:云原生,你问的不是"贵不贵"而是"要不要少扛运维"——愿意交出厂商锁定,就换来一招托管省心;OLAP,你问的不是"快不快"而是"这堆数据是不是只用来被扫被聚"——是,列式值得;不是,点查重的别硬塞。 把它和三大 NoSQL 族放到同一张候选池里,你的选型地图才算彻底铺开:前台事务交给 NewSQL/云原生,海量扩展交给 NoSQL 各族,分析层层交给 OLAP——每个容器都适合它装的数据,这正是"上对每座山头"的分工。
六、最后再补一句"别把列式当银弹"
列式存储好,但它不是万能键。列式库在"只读受查几列"的分析上飞快,可一旦遇到写路径密集、或者单行点查的场景,列式反而吃亏——因为写入要铺开写好几列、点查要先在对应列里定位。所以当有人问"那把顺序表也换成列式是不是更快"时,答案往往是"看你读它还是写它"。分清"分析型大扫描"与"事务型点状读写"这两个词,你就永远不会对一个列式库提它根本不在行的要求,也不会迷信"列式=永远最快"这句话。
本节要点回顾
- 云原生:托管、弹性、免运维,代价是厂商锁定。
- OLAP 列式:扫描大表只读所需列,聚合分析飞快。
- 行式 vs 列式:一个全行读入、一个只读受查列。
- 总表对号:先分负载类型,再补数据模型与一致性。
四大阵营、外加云原生与 OLAP 两条专线都过了一遍,选型地图算是铺全了。到这里,一套"分布式原理与实践"的知识就贯穿到了能上手挑库的程度。回顾每一章,从第 1 章的临界线到第 8 章的落地方案,希望他们能在你自己的业务里,帮你做出那个"刚好匹配"而不是"看起来最先进"的选择。