1.2 语义实例全景怎么选
1.2 语义、实例、全景怎么选
本节摘要:语义分割给每个像素一个类别名,不区分同一类的不同个体;实例分割要给每个物体单独掩码;全景分割要求「东西」有实例、「事」有类别且铺满全图。三种不是由易到难的升级包,是产品约束,选错会让标注和模型整条链返工。
本节目标
阅读完本节,你应当能够:
- 用一句话区分语义、实例、全景,并指出各自对背景的处理
- 根据「要不要数个数、要不要铺满、有没有东西与事两类」选出任务
- 说明为何不能把语义结果用连通域硬拆成实例
- 为选定任务列出标注字段:类别 id、实例 id、忽略区、空隙怎么处理
一、先问要不要数个数
地图填色:把所有湖泊涂成蓝色,不管是哪一个湖——这是语义。农田分垄:每一垄要单独编号,方便估产——这是实例。既要所有地表都有地类,又要每栋建筑有门牌——这是全景。
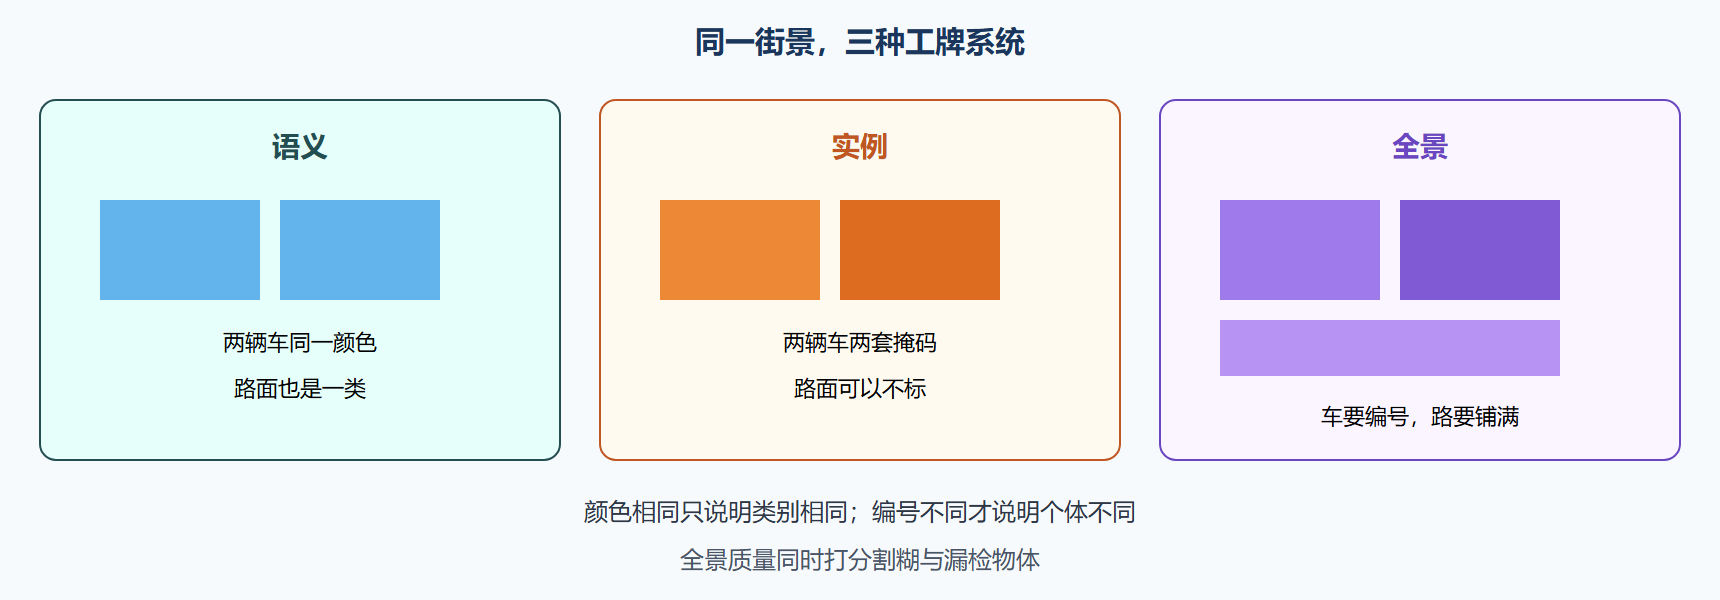
街上停了三辆白色轿车。语义模型把三辆车的像素都标成「车」,叠在一起是一块斑。你无法回答「左边那辆挡没挡住车道」。实例模型给出三块掩码,甚至三套框。全景还要求路面、天空、绿化这些「没法数个数的东西」也有类别,且没有像素被漏掉或标成未知空洞。
动手之前把这句话写在任务书第一行:我们要不要把同类个体拆开,要不要让每个像素都有标签。 两个布尔值几乎决定了你走 U-Net 还是 Mask R-CNN,决定标注工具是画刷还是多边形加点 id。
二、语义分割:像素分类
语义分割把每个像素分到预定义类别。输出常见两种张量:单通道整数图,值域是 0 到 C-1;或 C 通道概率再取最大。背景通常是 0。类别表必须封闭:没写进去的东西会被挤进最像的一类,或需要显式「忽略」。
适合:可行驶区域、器官、土地覆盖、天空与地面。不适合:排队的人要分别跟踪、一盘零件要计数。语义对粘连特别宽容——两辆车挤在一起,模型乐于输出一块「车」,因为损失并不惩罚「没切开」。
# 语义掩码:每个像素一个类别整数 # 0 背景 1 道路 2 车 3 人 sem = mask_hw # 形状高宽,dtype 整数 num_classes = 4 # 训练时常常变成独热,供交叉熵或 Dice onehot = (sem.reshape(-1, 1) == range(num_classes)).reshape(*sem.shape, num_classes)
评估常用平均交并比:每一类算预测与真值的交并比再平均。像素准确率在「路面占大半」时会虚高,所以语义任务不要只报它。
三、实例分割:先有物体再有像素
实例分割要的是一组物体,每个物体有类别、通常有框、必须有掩码。两辆车即使颜色一样,掩码也不能共用一个 id。输出不是一张类别图,而是长度等于物体数的列表。
适合:细胞计数、货架商品、行人跟踪的像素级输入、抠图里「只抠这个人」。标注成本明显高于语义:每多一个物体多一套轮廓,遮挡处要决定谁在前。
⚠️ 常见坑:用语义模型的连通域当实例。粘连的两颗细胞会变成一个连通块;断裂的一条裂纹会变成两个实例。连通域是后处理启发式,不是实例监督。
💡 关键直觉:实例的本质是「身份」,不是「颜色团」。身份靠检测式结构或判别嵌入来维持。
Mask R-CNN 这类方法走「先提议区域再在区域内画掩码」。也有先做语义再嵌入聚类的路线。本教程动手主线在第 5 章接 Mask R-CNN,因为工程上预训练和后处理都成熟。若你的目标几乎不重叠、形状简单,有时语义加分水岭更省。
四、全景分割:铺满且可数的要可数
全景把像素分成两类名词:可数的东西(thing)和不可数的事(stuff)。车、人是东西,要实例 id;天空、道路是事,只要类别。最终一张图上每个像素恰好属于一个标签,东西还带实例编号。指标上常用全景质量,它把分割质量和识别质量乘在一起——漏检一个物体或一块区域糊掉,分数都会掉。我们不背具体公开榜数字,只记住:全景同时惩罚「没铺满」和「没拆开」。
| 任务 | 每个像素有类别 | 同类个体可分 | 必须铺满 | 典型输出 |
|---|---|---|---|---|
| 语义 | 是 | 否 | 通常是 | 一张类别图 |
| 实例 | 物体上有 | 是 | 否,背景可空 | 物体列表 |
| 全景 | 是 | 东西要分 | 是 | 类别图加实例图 |
选型口诀:只要区域、不要个数 → 语义。要个数、背景无所谓 → 实例。既要铺满地图又要给建筑门牌 → 全景。多数工业质检其实是语义或实例,不必追全景这个词。
图 三种任务在同一街景上的差别
五、标注字段与返工成本
语义标注:多边形或画刷,属性只有类别。实例还要实例 id、遮挡顺序、是否截断。全景要维护东西与事两套词汇表,空隙(两实例之间的细缝)常标成忽略,训练时不进损失。这些字段一旦在中途增加,旧数据要么回炉要么当半监督。
公开集的任务类型是锁死的:街景语义、细胞实例、全景基准,各用各的评估脚本。自建项目不要因为论文热就上全景。仓储里「只要托盘区域」用语义;「每个托盘一个码」用实例。把热词写进需求文档,是最贵的一种选错。
训练时三种任务的数据布局也不同。语义是图对图。实例是图对一组掩码,批次里物体数不齐,要对齐或用列表结构。全景常常两张图:语义图加实例 id 图,id 在每张图内自增。加载器写错一种,损失会默默优化到错误的监督上。
六、把选型写进接口
语义加载器返回两张同尺寸图。实例加载器返回图像加一组掩码、一组框、一组类。全景返回语义图加实例 id 图。三种接口不能混用同一个训练循环里的 masks.long() 一句话。第 4 章会分开写;本节只要你在任务书上圈定一种,并拒绝「先按语义标着,以后再拆实例」这种口头协议——以后几乎不会来,来了就是回炉。
公开基准各锁一种任务。街景语义不管两辆同款车是不是同一辆;细胞实例不管培养皿背景要不要精细分类。自建项目抄基准名字却不抄评估脚本,是另一种选错。把评估脚本的函数名写进任务书附录,比写「参考某大赛」具体。
问题:能不能语义训完再聚类出实例?
嵌入加聚类是一条研究路线,工程上要额外的距离阈值,粘连与断裂同样存在。若产品现在就要计数,优先实例标注加检测式模型。若暂时只有语义预算,计数请用第 3.2 节分水岭当临时方案,并在报告里声明它不是身份监督。
问题:全景质量公式要背吗?
不必背到能默写。记住它同时惩罚糊和漏检物体即可。你的合同若不是全景产品,不要把该公式写进去充专业。铺满加可数,用「语义 mIoU + 实例匹配」两行往往更可解释。
选定类型之后,冻结类别表至少到第一版上线。中途把「车」拆成「轿车/卡车」,所有旧掩码都要迁移或作废。这是 1.2 节真正昂贵的地方,不是三种定义谁更时髦。
七、接口草图先画在纸上
在纸上画三种返回值:语义是一张整数图;实例是变长列表;全景是成对图。把第 4 章训练循环将要调用的字段名写在旁边,避免口头「都是掩码」导致工程师按语义接口去吞实例列表。画完接口再雇标注员。标注工具若只支持画刷不支持实例 id,你选了实例任务就会在工具层失败,这比模型层失败更早、也更该在本章暴露。
粘连策略单独成段:语义允许粘连;实例必须在规范里写「紧贴是否仍拆开」。细胞两核共膜时,拆开靠分水岭还是靠检测框,要预定。预定检测框,标注就要有框;预定分水岭,评估就要用实例匹配而不是像素 Dice 单独报喜。全景的空隙(两车之间那条缝)标忽略还是标路面,决定损失是否惩罚那条缝。写进词汇表,不要留给标注员临场发挥。
把两个布尔值做成任务书页眉:拆个体?铺满?页眉改一次等于立项变更。变更走迁移脚本,不走「从下周开始新标法、旧数据凑合用」。凑合用的旧数据会在验证集里变成噪声,曲线会抖,有人会去拧学习率。
接口草图请训练和标注各确认一次签名。工具不支持实例 id 时,要么换工具要么降级任务,不要口头承诺「先语义以后再拆」。粘连策略与空隙策略写进词汇表版本。页眉两个布尔值变更走立项,旧数据走迁移或作废,禁止两套标法并存于同一验证盘。
签名后的接口草图进仓库,字段名与第 4 章循环保持一致。工具链做不到实例 id,任务降级要在页眉布尔值上改,走立项,不得在群里说「先标着」。空隙与粘连两条策略变更记词汇表版本。验证盘禁止混放两套标法。混放会让 mIoU 变成两种法律的平均值,谁也解释不清。
页眉布尔值与工具能力矩阵每年至少核对一次。工具升级支持实例 id 后,不得自动把旧语义项目升级,仍走立项。接口字段改名必须同时改第 4 章循环与本页草图,三处 diff 同一合并请求。混放两套标法的验证盘一旦发现,整盘作废重划,指标作废。法律落到仓库纪律上,数字才配签字。
三处 diff 同一请求。整盘作废重划写进事故手册。工具升级不自动升任务。页眉与能力矩阵年核。
任务类型选定后,加载器接口就锁死:语义走单通道类别图,实例走变长物体列表,全景两者都要。中途从语义改实例,等于作废已标掩码。评审会上若有人说「先语义跑起来以后再加实例」,当场否决,并在验收卡上写死「不升级任务类型除非重标」。
一节小结
- 两个布尔值:要不要拆个体、要不要铺满,决定任务类型
- 语义:像素分类,粘连不惩罚,适合区域类产品
- 实例:物体列表,连通域不能替代身份
- 全景:东西可数、事铺满,指标乘上识别与分割两边
- 输出形状:语义是图,实例是列表,全景是成对图
- 中途改类型等于回炉标注:任务书写死再开工
下一节把类型放到医学、驾驶、遥感、质检、监控里,看验收尺子如何被场景钉死。