2.1 像素通道与掩码怎么存
2.1 像素、通道与掩码怎么存
本节摘要:数字图像是二维或三维数组,像素是最小单元。分割的契约是:图像与掩码同高同宽、坐标系一致、掩码用整数类别或独热编码。存错通道顺序或把掩码当普通照片压缩,训练会默默学到垃圾标签。
先说结论
阅读完本节,你应当能够:
- 读出数组的高、宽、通道,并说明原点在左上、x 向右、y 向下
- 在灰度、二值、彩色、多光谱之间转换时,知道信息哪一步丢掉
- 把单通道类别掩码与独热掩码互转,并断言每像素类别唯一
- 拒绝用有损压缩保存标签图
一、先把数组说清楚
图像在内存里就是数。灰度图形状是高×宽,每个位置 0 到 255 的整数,或 0 到 1 的浮点。彩色常见高×宽×3。多光谱遥感可以是更多通道。分割不关心相机品牌,关心三件事:形状能不能和掩码广播对齐、数值范围进网络前怎么归一、通道顺序是红绿蓝还是蓝绿红。
坐标系:原点在左上角,列索引向右,行索引向下。这和数学课的笛卡尔不同。仿射变换、画框、把多边形栅格化,全部遵守这套。标反了,掩码会上下颠倒地叠在图上,损失还是一个正经的标量,你会以为模型在学,其实在学镜像。
像素有位置、有值、在彩色里还有通道值。邻域是滤波和形态学的舞台,也是分割「区内相似」的物理基础。访问一个像素就是用行列下标;切片是区域;整图运算是向量化。这些在加载器里每天发生。
import numpy as np # 假定 img 已是数组:高宽通道 h, w, c = img.shape assert mask.shape[:2] == (h, w), "掩码必须与图同高同宽" assert mask.ndim in (2, 3) if mask.ndim == 2: labels = np.unique(mask) assert labels.min() >= 0 print("原点像素", img[0, 0], "掩码", mask[0, 0])
⚠️ 常见坑:把掩码存成有损照片格式。类别 1 和 2 会被压成 1.3,再四舍五入乱套。标签用无损图或数组文件。
💡 关键直觉:图像可以糊一点,标签糊不得。糊标签是系统性标注噪声。
二、图像类型与分割的关系
二值图已经是最简分割:0 与 1。阈值方法的输出往往就是它。灰度图是阈值、Otsu、许多医学切片的输入。彩色图给聚类和深度学习更多特征。索引图(调色板)看起来像彩色,值却是类别号——有些标注工具导出的就是索引图,读的时候不要当三通道去平均。
类型转换会丢信息。彩色转灰度是加权,边缘可能变弱。浮点归一化到 0 到 1 要和训练时一致,验证时另搞一套均值,等于换了数据分布。二值化更是不可逆:阈值一侧的纹理永远消失。预处理管道要可复现,就是把这些转换写成固定函数,而不是在笔记本单元格里随手改。
存储方面,原图可以用有损以省空间,但要固定质量因子并在训练与生产同一套解码。掩码与原图的文件名规则要能一对一映射,例如同一词干不同后缀。不要靠「文件夹里第 i 张对第 i 张」——排序规则在不同操作系统会悄悄变。
三、掩码的两种合法编码
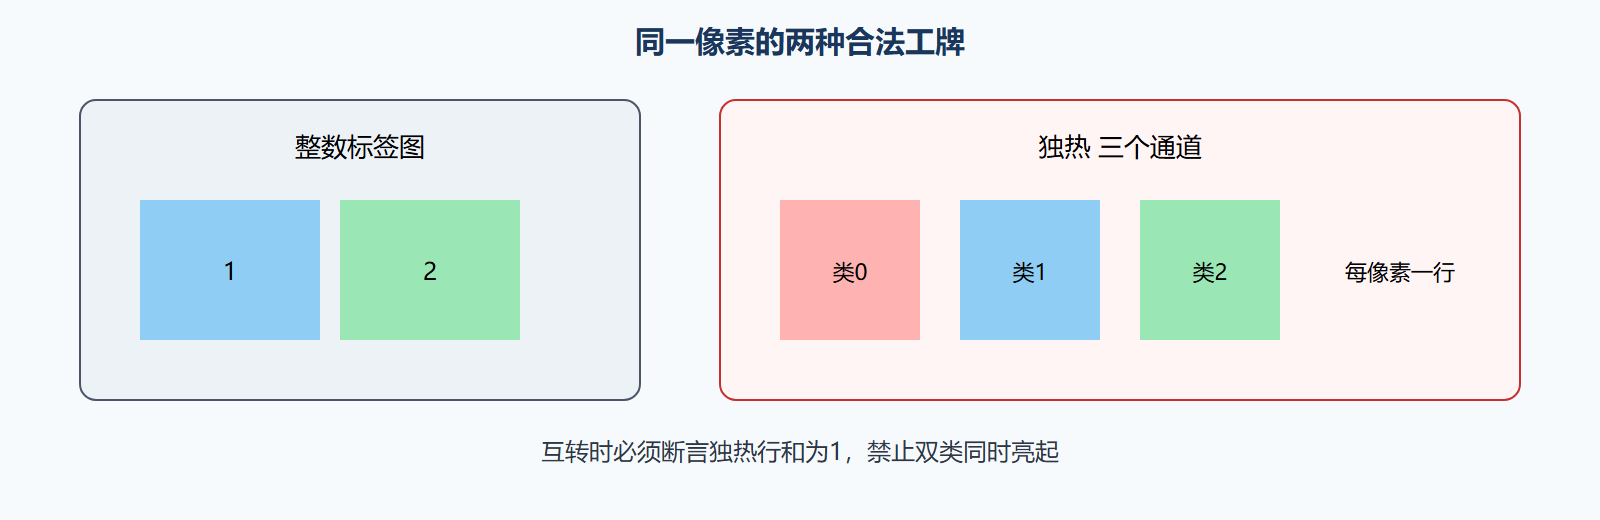
单通道整数:每个像素一个类别 id。省内存,适合评估脚本和人眼查看(给每个 id 上色)。独热:形状高×宽×类别数,每像素只有一个通道为 1。Dice 损失常直接吃独热或软概率。训练时在加载器里互转,不要在磁盘存两份还对不齐。
实例掩码更麻烦:可能是一张实例 id 图(0 背景,1、2、3 是不同物体),另附一张类别查找;也可能是 N 张二值图。批次里 N 不同,不能简单堆成规整张量,要用列表或填充。这是实例加载器比语义啰嗦的根源。
| 编码 | 形状 | 优点 | 代价 |
|---|---|---|---|
| 整数标签 | 高宽 | 小、易可视化 | 损失层要自己做独热或用专用接口 |
| 独热 | 高宽类 | 和 Dice 对齐 | 类多时内存暴涨 |
| 实例 id 图 | 高宽 | 一张图装下所有物体 | 需要额外表把 id 映射到类别 |
| 多张二值 | 物体数乘高宽 | 与检测式输出同构 | 物体数不齐,批处理麻烦 |
图 整数掩码与独热
四、动手时的断言清单
加载器里我习惯放三道断言:形状一致;标签在合法集合内(含忽略 id 若有);独热行和为 1。再抽几张把掩码半透明叠在图上,人眼看边界。自动化断言抓类型错误,叠图抓「整图偏移了 16 像素」这种错——那种错损失仍下降,因为网络学会了预测偏移后的东西,验证集一看就穿帮。
忽略 id 常见取值 255。计算损失时要 mask 掉。若你把 255 当成第 255 类送进交叉熵,显存和梯度都会热闹一场。类别很少时用 uint8 存整数掩码足够;实例数可能超过 255,要用更大整数类型。这些是数据契约,写在规范里,比写在聊天记录里可靠。
公开数据集各有各的调色板。读之前打印 unique。有人用 0、1,有人用 0、128、255 当可视化颜色。后者不是类别 id,拿去训练等于把亮度当标签。第 2.4 节会把这套契约写进标注规范;本节只要求你在代码入口处守门。
五、文件契约与调色板陷阱
磁盘上常见三种「看起来像标签」的东西。第一种是真正的整数 id 图,打开后 unique 是 0、1、2。第二种是可视化调色板图,unique 是 0、128、255 或一堆分散的颜色值,那是给人看的,不是给损失看的。第三种是索引色图,调色板藏在文件头里,读成三通道再平均会毁掉 id。读取函数必须按数据集文档选择,读完立刻打印 unique。这一步省掉的调试时间以天计。
命名:同一词干、不同后缀,或清单两列对齐。不要依赖操作系统的文件名排序。Windows 与另一套系统对「img_10」和「img_2」的排序可能不同,按帧号配对会在不易察觉的位置错位,损失仍下降,叠图却像重影。
实例 id 超过 255 时,8 位整数会溢出绕回,两个物体变成同一个 id。细胞密集视野尤其容易踩。写入前检查最大值,不够就升级整数类型。忽略值 255 与「最多 255 类」不要挤在同一个 8 位空间里——类很多时换 65535 当忽略,并在损失里写明。
问题:独热占内存怎么办?
类特别多时不要在磁盘存独热,训练时对整数标签用交叉熵接口,Dice 用当前批次出现的类现场展开。评估仍用整数图。这是编码选择,不是模型选择。
把断言写进加载器而不是笔记本单元格。单元格会在某次重构里被删掉,加载器每次都会喊。第 2.1 节过关标准:任意抽一对,形状一致、标签合法、叠图边界贴得上。做不到,禁止进入增强。
六、读入时的三张对照图
第一张:原图。第二张:标签上色。第三张:半透明叠加。三张必须能在同一窗口切换。只看第二张会把调色板当类别;只看第一张会漏掉错位。叠加发现整体平移时,先查原点与翻转,再查是否用了错误的仿射。这一习惯比任何损失曲线都早发现问题。
整数类型不够用时的症状是实例突然合并:id 256 变成 0。在写入清单里加最大值检查。忽略值不要和合法类抢同一个端点。类很少用 255 当忽略没问题;类接近 255 时换更大范围,并在交叉熵的忽略参数里写同一数字。独热展开只在需要 Dice 的当前批次做,磁盘保持整数,省空间也少一次对不齐。
公开集调色板各不相同。有的用连续 id,有的用 0、128、255 当可视化。读取模块按数据集名字分支,读完 unique 打日志。日志里出现 128 要警惕。把这件事写成加载器的第一行注释,比写成长篇规范更不容易被删掉。坐标系左上原点与数学课不同,多边形栅格化必须用同一套,否则标注工具导出的点会上下颠倒地躺在图上。
三张对照成为每次拉数据的固定动作,写进加载器演示函数。最大值检查挡住实例溢出。调色板分支按数据集名字走,unique 含 128 打警告。多边形栅格化与数组共用左上原点。把这些写成测试:造一对已知错位的数据,断言必须红。测试不红,说明断言没在值班。磁盘只存整数标签,Dice 需要时现场展开,少一份对不齐的独热文件。
上线前再做一次「错位演习」:故意把掩码整体平移三像素,断言应红、叠图应一眼看出。演习不过,说明值班断言没接上。再演习一次「255 当类」:造一张含 255 的整数图,损失若把它当第 255 类,应在构造器就被忽略参数拦住。两次演习写进加载器测试文件,随数据版本一起跑。整数溢出演习:实例 id 设为 256 写入 8 位,读回若变成 0,测试必须失败。这三场演习比再讲一遍通道顺序更能保住契约。公开集换一个,调色板分支要加测试用例,unique 期望集合写死。左上原点与标注工具导出对照一张含已知角点的图,角点行列必须对上,对不上先修栅格化再谈增强。磁盘策略维持整数,现场展开独热,少一份幽灵文件。把演习清单抄进第 6 章回归,换相机时重跑,而不是假设契约永真。
反例档案一:有损标签。把整数掩码存成高压缩照片再读回,unique 出现大量中间值,训练却还能降损失。档案结论:标签只走无损。反例档案二:按文件名排序配对,在另一台机器上 img_10 排到 img_2 前面,叠图重影。结论:清单两列对齐。两份档案进新人第一周必读,比再讲通道更防呆。演习三场仍要按数据版本重跑,换相机后原点与角点对照不能省。
口令卡:无损、清单对齐、溢出检查、255 忽略、左上原点、unique 日志。六句都能在测试里红灯。新人第一周只跑三场演习和两份反例档案,不改网络。换相机重跑角点。磁盘整数、现场独热。契约进第 6 章回归。错位三像素演习永远留在 CI。
编码表一经发布禁止静默改数字:类别 3 今天是肝脏、明天是背景,等于毒化全部历史权重。改编码必须升数据版本并重导旧掩码。
重点提炼
- 数组契约:同高同宽、左上原点、通道顺序固定
- 图可有损、标签不可有损:压缩是标注噪声的生产线
- 整数与独热:磁盘常用整数,损失常用独热或专用接口
- 实例编码更弯:id 图加查找表,或变长二值列表
- 断言加叠图:形状检查抓类型,叠图抓偏移
- 忽略值不是一类:255 必须在损失里排除
下一节把滤波和形态学接进来:它们既清洗原图,也修理掩码上的毛刺与孔洞。