2.5 多轮对话与上下文管理
2.5 多轮对话与上下文管理
本节摘要:真实对话是多轮的——用户会说"那改成明天的"。本节讲清上下文是什么、怎么管理(状态 + 历史)、指代消解("那个"指什么)、以及"上下文管理决定对话像不像人"。
本节导读
阅读完本节,你应当能够:
- 理解上下文的作用
- 管理对话状态与历史
- 处理指代与省略
- 平衡记忆与成本
- 让对话连贯
一、问题与直觉
"那改成明天的"——这句话单独看没有意义,多轮对话里却自然。因为它依赖上下文:上文说了"订周五的票","那"指代"票"、"明天"是新信息。上下文管理,就是让系统"记得刚才说了什么",并用来理解现在。
二、核心原理
多轮对话靠上下文接力:
2.1 上下文的构成
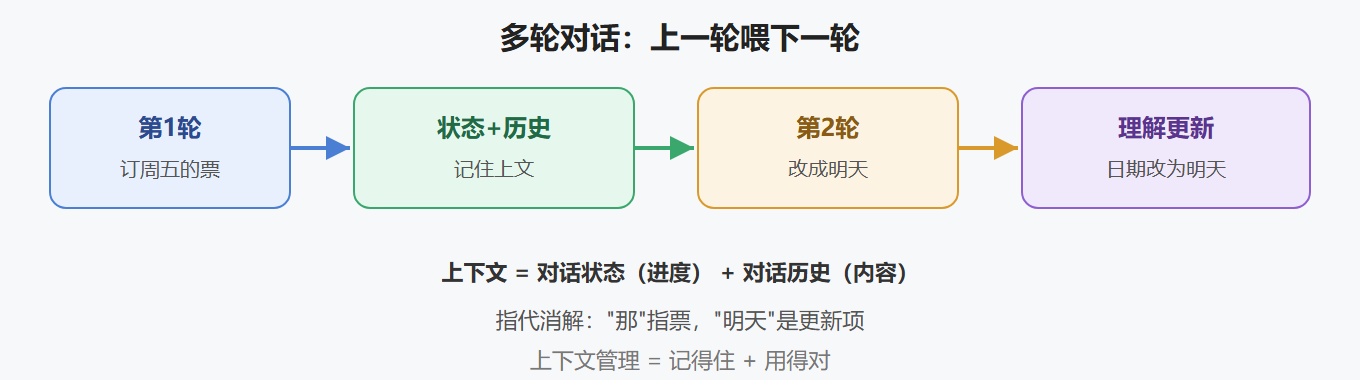
2.2 上下文管理的关键
- 状态:任务进度(已收集哪些信息)
- 历史:对话内容(说过什么)
- 指代消解:代词指向什么
三、工程实践要点
3.1 上下文管理策略
| 策略 | 做法 |
|---|---|
| 状态跟踪 | 记录任务进度 |
| 历史窗口 | 保留最近 N 轮 |
| 指代消解 | 解析"那个/它" |
| 省略补全 | 补全被省略的信息 |
💡 关键直觉:上下文是"选择性记住"——全记住成本高,全忘掉不连贯。状态记"进度",历史记"最近",关键信息长期存。
3.2 常见上下文问题
| 问题 | 表现 |
|---|---|
| 上下文丢失 | 改口后系统忘 |
| 指代混乱 | "那个"理解错 |
| 历史过长 | 成本高、易乱 |
⚠️ 常见坑:改口处理失败。用户说"改成明天",系统如果当成"新订单"而不是"修改",就是上下文没用起来——改口是上下文管理的高频考点。
3.3 多轮测试要点
测连贯:跨轮引用 测改口:信息更新 测遗忘:长对话稳定性
要点速记
- 要点一:上下文 = 状态 + 历史
- 要点二:指代消解让"那个"有指向
- 要点三:状态记进度,历史记内容
- 要点四:选择性记住,平衡成本
- 要点五:改口处理是高频考点
- 要点六:多轮测试三连
设计原则全部讲完,第 3 章深入第一个模块——自然语言理解 NLU。
深度扩展:上下文的存储结构与改口处理
"上下文 = 状态 + 历史"这句要落地,得回答"状态和历史分别存在哪、怎么更新"。这里给一个最小实现思路,重点看改口是怎么被正确处理的。
上下文的存储通常分两层:任务状态层(存结构化信息,长期有效)和对话历史层(存原始轮次,滑动窗口保留)。示意如下:
# 概念示意:会话上下文对象 context = { "task_state": { "intent": "BOOK_FLIGHT", "slots": {"date": "周五", "origin": "北京", "dest": "上海"}, "confirmed": False, }, "history": [ # 最近 N 轮,用于指代消解与生成参考 {"role": "user", "text": "帮我订周五去上海的机票"}, {"role": "bot", "text": "请问几点出发?"}, {"role": "user", "text": "那改成明天吧"}, ], }
改口为什么难:用户说"那改成明天","那"指代"机票/订单"(指代消解),"改成明天"表示覆盖 date 槽位(槽位更新)——而不是新开一个意图。处理分两步:先靠任务状态认出"当前在做订票任务",再解析"改成明天"并将其映射为对 date 槽位的覆盖写。若系统只有历史没有任务状态,就无法区分"改口"和"新需求"。
三种典型更新语义:
新增信息:"明天去北京"(补充 origin)→ 写槽 改口信息:"改成后天"(覆盖 date) → 覆盖写 否定信息:"算了不订了"(取消任务) → 清状态 / 结束
实现时,每个槽位更新都记录"旧值 → 新值"的变更日志,既方便回退(用户又说"还是周五吧"),也方便审计。历史层则按滑动窗口裁剪,只留最近 N 轮用于指代解析和生成上下文,避免整段历史堆进模型导致成本与噪声上升。
一致性检查:上线前用一组"改口脚本"测试——连改两次日期、中途换城市、先给日期后给城市——确认每种情况下任务状态都被正确更新、最终确认话术包含的是最新信息。多轮对话的成败,九成取决于状态更新语义是否定义得干净。
动手练习:给改口脚本设计测试用例
把"改口脚本"具体化为一张测试用例表,训练自己设计多轮测试的能力。场景:订票流程。请写出五条测试用例覆盖不同改口形态:改日期("那改成后天")、改城市("目的地换深圳")、先补充后改口("周六吧…不,周日")、取消重来("算了,帮我订去上海")、长对话后旧信息遗忘(第五轮后提到"之前那个航班")。每条用例写明:输入轮次序列、预期状态变化、预期最终确认话术。写完对照检查:每条用例的状态更新是否准确、是否覆盖了"指代消解"("那个""之前那个")、是否覆盖了历史窗口截断的边界。能设计出这套用例表,说明你理解上下文管理的真正难点——它不是"记住所有话",而是"在合适的地方记住该记的信息"。