第3章 · 自然语言理解 NLU
第 3 章 · 自然语言理解(NLU)
章节摘要:NLU 是对话系统的"耳朵"——把用户的话变成结构化理解。本章深入五大任务:意图识别(用户想干什么)、槽位填充/NER(需要哪些信息)、文本分类与情感分析(文本属什么类、什么情绪)、句法与语义分析(句子怎么构成)、NLU 模型与技术(用什么实现)。学完本章,你能构建 NLU 模块。
先说结论
阅读完本章,你应当能够:
- 理解意图识别
- 掌握槽位填充
- 应用文本分类与情感分析
- 了解句法与语义分析
- 选型 NLU 技术
核心概念速览
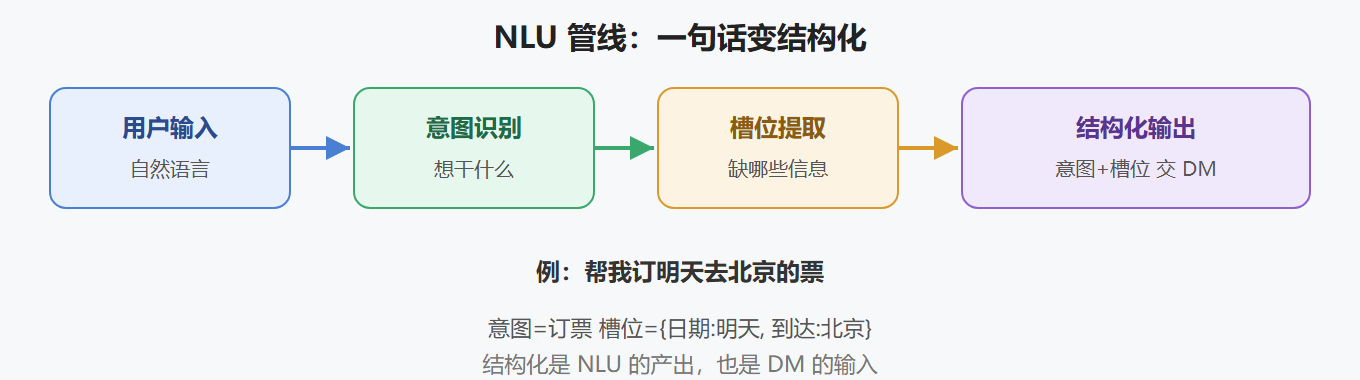
一句话记住本章:NLU 的目标 = 把一句话变成"意图 + 槽位"的结构化数据——机器不懂人话,但懂结构化。
NLU 管线
子章节导航
3.1 意图识别
用户想做什么:意图分类与识别流程。
3.2 槽位填充与 NER
缺哪些信息:槽位提取与实体识别。
3.3 文本分类与情感分析
属什么类、什么情绪。
3.4 句法与语义分析
句子的结构与含义。
3.5 NLU 模型与技术
从规则到深度学习的实现路线。
子章节之间的逻辑关系
意图(3.1) → 槽位(3.2) → 分类(3.3) → 分析(3.4) → 实现(3.5) 主任务 信息提取 辅助任务 深度分析 技术选型
五大任务从"核心"到"实现",构成 NLU 完整拼图。
前置知识与后续延伸
- 前置:第 1 章构成认知、第 2 章设计基础
- 为后续铺垫:NLU 输出是第 4 章 DM 的输入
本章学习建议
NLU 五节按"核心任务 → 辅助任务 → 技术实现"排列,建议先抓 3.1 意图识别和 3.2 槽位填充这两根主线,它们直接决定 DM 拿到的结构化输入。学习方法:找三句真实的用户话术(例如"帮我订明天飞上海的经济舱"),逐句拆出意图与槽位,再自己设计三个意图和对应的槽位清单,体会粒度粗细的取舍。3.3 情感分析、3.4 句法语义可作为辅助补充,了解各自在什么场景有价值即可。最后 3.5 汇总技术路线,重点理解"数据量少用规则、标准业务用预训练微调、冷启动用大模型少样本"的选型逻辑。学完自测:给一句新话术,你能否立刻说出它的意图、槽位和实现方式。
评论区
(0)
U