3.2 槽位填充与 NER
3.2 槽位填充(Slot Filling)/命名实体识别(NER)
本节摘要:意图定了,还差"信息"——订票要日期、城市。槽位填充就是提取这些信息。本节讲清槽位的概念、NER(识别实体)与槽位填充的关系、提取流程,以及"槽位缺失时的追问策略"。
学习目标
阅读完本节,你应当能够:
- 理解槽位的概念
- 区分 NER 与槽位填充
- 复述提取流程
- 设计槽位追问
- 评估提取效果
一、问题与直觉
"订票"知道了,但"哪天的票、去哪"还不知道——这些可变信息就是槽位。槽位填充 = 从用户的话里把槽位值提取出来:日期、城市、人数……像填表,只是自动从对话里填。
二、核心原理
2.1 槽位与 NER
- NER:识别文本中的实体(人名、地名、日期)
- 槽位填充:把实体填到任务的槽位里
2.2 槽位示意
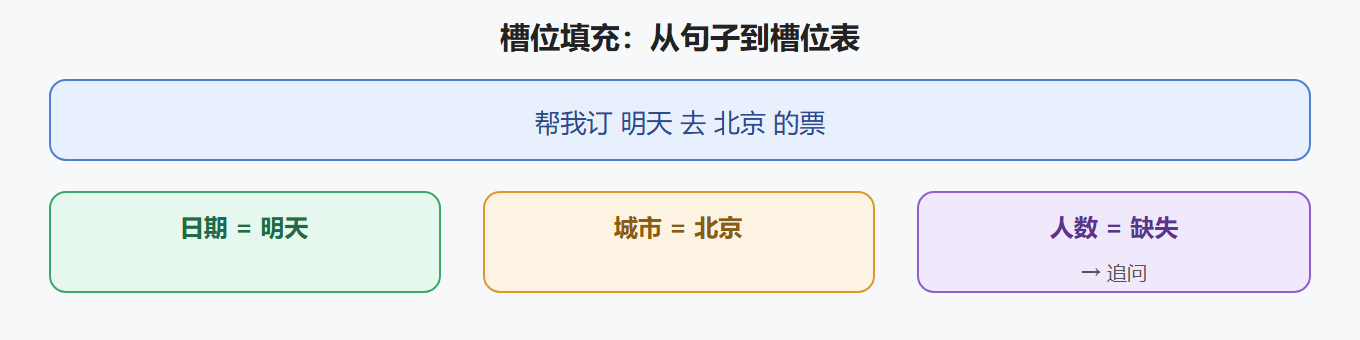
💡 关键直觉:意图决定"需要哪些槽位",槽位填充决定"拿到没有"——意图是任务,槽位是任务的参数。缺参数就追问,齐了才能执行。
三、工程实践要点
3.1 槽位追问策略
缺日期 → "请问您哪天出发?" 缺城市 → "请问去哪?" 缺人数 → "几位出行?"
⚠️ 常见坑:一次追问多个槽位。一次问一个最清晰——用户一次能答一个,连珠炮式提问体验差。
3.2 槽位提取方式
| 方式 | 说明 |
|---|---|
| 规则 | 正则匹配日期等 |
| NER 模型 | 通用实体识别 |
| 大模型 | 少样本抽取 |
3.3 评估提取
提取准确率:填对的槽位占比 缺失率:该填的没填上 错误填充:填错的槽位
本节速览
- 要点一:槽位 = 任务的可变参数
- 要点二:NER 找实体,填充填槽位
- 要点三:意图定槽位,填充看进度
- 要点四:缺槽就追问,一次问一个
- 要点五:规则、NER、大模型三种方式
- 要点六:准确率 + 缺失率 + 错误率评估
槽位会填了,下一节辅助能力——文本分类与情感分析。
深度扩展:NER 的标注体系与序列标注实现
"NER 找实体、槽位填充填槽"要真正落地,需要一套实体标注体系和对应的模型。这里把最常用的做法说清楚。
标注体系:把一句话里的每个字/词标上"是否实体、什么实体、实体边界"。最常用的是 BIO 标注——B 表示实体开始,I 表示实体内部,O 表示非实体,后缀是实体类型:
句子:帮我订 明天 从 北京 去 上海 的机票 标注: 帮(O) 我(O) 订(O) 明(B-date) 天(I-date) 从(O) 北(B-city) 京(I-city) 去(O) 上(B-city) 海(I-city) 的(O) 机(O) 票(O)
这个标注把"明天是日期、北京和上海是城市"都编码进序列。有了标注数据,就能训练序列标注模型(条件随机场 CRF、BiLSTM-CRF,或让预训练模型输出标签序列)。模型产出的标签序列再映射回槽位值:
标注结果 → date: 明天, city: [北京, 上海] → 填入 BOOK_FLIGHT 的槽位
与大模型的结合:大模型可以直接从文本里抽取槽位(Few-shot 抽取),不必走 BIO 标注。但输出仍需校验格式、对齐合法槽位集,避免模型把"北京"抽成"出发地"而业务里只有 origin 字段。工程上常把大模型抽取结果与规则/模型结果做一次"置信融合",低置信时走澄清。
槽位缺失的追问:槽位填充的目标不是"抽得越多越好",而是"该有的都有"。每轮 NLU 结束后,把已填槽位与任务必需槽位对齐,缺哪个就触发哪个追问:
必需槽位: date, origin, dest, passenger_count 本轮填充: date=明天, origin=北京 缺失列表: dest, passenger_count → 追问"去哪?"(一次只问一个)
最后用准确率(填对的槽位占比)、缺失率(该填没填上的占比)、错误填充率三项做评估,并特别关注"改口后槽位是否正确覆盖"——这往往是实际系统最容易出问题的地方。
动手练习:手标一段 BIO
动手练一次标注,感受序列标注的粒度:取一句话"帮我订两张后天去深圳的高铁票",先写出你认为是实体的词(日期、数量、城市),再给每个词标上 BIO 前缀与类型(date / count / city)。对照自己的答案思考两个问题:一是"两张"作为数量该标成一个实体还是并入"订"的上下文?二是"高铁票"里的"高铁"要不要单独标类型?你会发现边界判断需要结合业务需求——标注规范本身就是产品的一部分,定义不清,模型学不到你想要的东西。再进一步,试想如果用户说"订周五的,不,改周六",这句里的"不,改周六"应该如何影响槽位覆盖?把它记为一条特殊测试样本,线上评估时重点盯这一类改口样本的表现。