3.1 意图识别
3.1 意图识别(Intent Recognition)
本节摘要:意图识别是 NLU 的核心任务——判断"用户想做什么"。本节讲清意图的定义、识别流程、意图体系设计(分类怎么定)、以及"意图体系决定系统能力边界"的核心理解。
读前必看
阅读完本节,你应当能够:
- 解释意图识别
- 复述识别流程
- 设计意图体系
- 处理意图冲突
- 评估识别效果
一、问题与直觉
"用户说'帮我订票',系统要知道这是'订票'意图"——意图识别就是给用户的话打一个"目的标签"。这是 NLU 的第一步,也是最关键的一步:意图错了,后面全错。像给"用户想做什么"分类,分类准不准决定系统能不能接住话。
二、核心原理
意图识别的定位:
2.1 意图识别流程
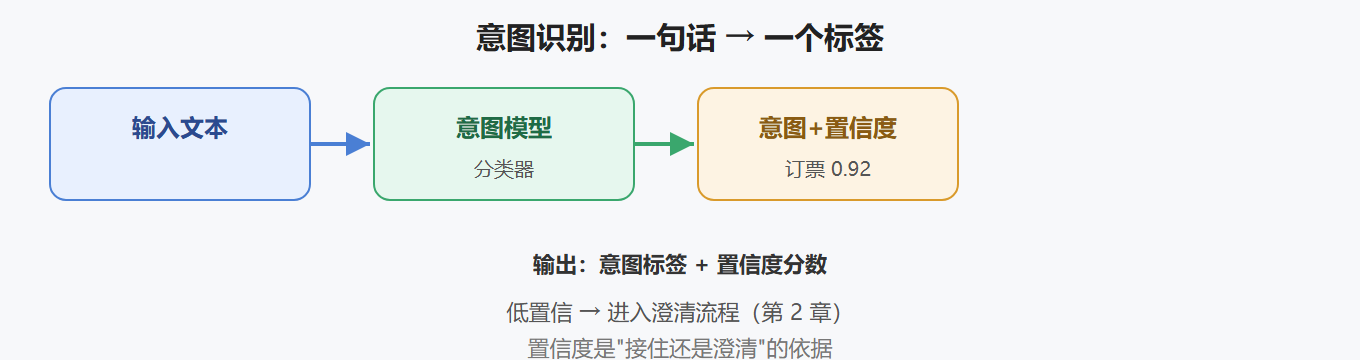
2.2 意图体系设计
意图定得细:订机票 / 订酒店(分开) 意图定得粗:预订类(合并) 原则:按业务需求分,够用即可,别过度细分
💡 关键直觉:意图体系 = 系统的能力边界——没定义"退票"意图,用户说退票系统就听不懂。设计意图体系,就是定义"系统能接住哪些需求"。
三、工程实践要点
3.1 意图分类的粒度
| 粒度 | 例子 | 场景 |
|---|---|---|
| 粗 | 预订类 | 简单系统 |
| 中 | 订机票/订酒店 | 常见 |
| 细 | 订经济舱/订商务舱 | 精细业务 |
3.2 常见意图问题
| 问题 | 表现 | 处理 |
|---|---|---|
| 意图重叠 | 两个意图都像 | 细化意图/设优先级 |
| 意图缺失 | 用户需求没覆盖 | 补意图 |
| 低置信 | 识别不确定 | 澄清流程 |
⚠️ 常见坑:意图体系设计太细。几十个意图让模型难分、标注费劲——从粗粒度起步,按数据反馈再细化。
3.3 评估意图识别
准确率:识别对不对 召回率:该接的接住了吗 低置信占比:多少进了澄清
核心回顾
- 要点一:意图识别 = 给用户的话打目的标签
- 要点二:输出意图 + 置信度
- 要点三:意图体系 = 能力边界
- 要点四:从粗粒度起步
- 要点五:低置信进澄清
- 要点六:意图错了全错
意图定了,下一节补信息——槽位填充与 NER。
深度扩展:意图识别的实现路线与数据集组织
前文讲了意图体系设计,这里把"怎么实现意图识别"补完整。按可用数据量从少到多,有三条路线:规则、文本分类模型、大模型少样本。
规则路线:用关键词、正则表达式匹配。适合意图明确、话术变化少的小场景(如内部工具命令)。优点是零训练、立刻上线;缺点是话术一变就失灵,通常只做兜底或初筛。
文本分类模型路线:把意图识别当作短文本多分类问题。需要一批"话术-意图"标注数据,训练一个分类器(早期用朴素贝叶斯、SVM,后来用预训练模型微调)。这是任务型对话最常用的路线,产出稳定、可离线评估。关键工作是整理数据集,标注集组织如下:
意图 | 训练话术示例(每条一列) BOOK_FLIGHT| 帮我订机票 / 明天去上海 / 订一张后天北京到深圳的票 BOOK_HOTEL | 帮我订房 / 附近有酒店吗 / 住一晚多少钱 CANCEL | 退票 / 不订了 / 帮我取消订单
大模型少样本路线:把意图体系写进提示词,配上几条示例让模型分类。冷启动最快、对长尾表达泛化好;缺点是每次调用有成本和延迟,且输出要校验是否落在合法意图集内。生产上常与规则/小模型组合:规则管高频精确,小模型管主干,大模型管冷启动与长尾。
意图冲突与优先级:当两个意图边界模糊("订票"和"改签"都像),要么细化意图定义,要么给意图设优先级(新功能意图优先级高于通用意图),要么在低置信时走澄清。无论哪条路线,最终都要靠"准确率、召回率、低置信占比"三个指标持续评估——意图错了后面全错,这条线值得最重的投入。
动手练习:设计三个意图的标注集
给"餐厅点餐"场景设计一个最小意图体系与标注集。请定义三到四个意图(如点餐、加菜、结账、取消),每个意图写五条真实话术,再写三条"边界话术"——容易误判的("再要一杯水"该算点餐还是加菜?"买单吧"是结账还是结束?)。写完后检查:意图是否够用不臃肿;边界话术是否触发了你对优先级/细分的思考;如果两条边界话术冲突,你倾向细化意图还是设优先级。这个练习比读十遍概念都有效——意图体系设计的功力,就是在一次次"这句算哪个意图"的权衡里练出来的。