4.2 时序差分学习
4.2 时序差分学习
本节摘要:TD(0) 用一步 bootstrap:V(s)←V(s)+α[R+γV(s')-V(s)]。TD 误差 δ=R+γV(s')-V(s)。比 MC 更早更新、更低方差;SARSA on-policy,Q-learning off-policy。
你能学到什么
- 写 TD(0) 更新与 TD 目标
- 对比 MC 与 TD 偏差-方差
- 写出 SARSA 与 Q-learning 的差异项
TD(0) 预测
TD 目标:R + γ V(s')
更新:V(s) ← V(s) + α [R + γ V(s') - V(s)]
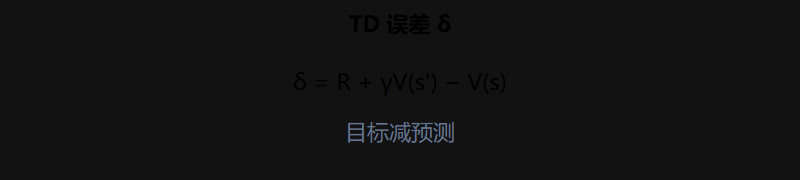
δ = R + γ V(s') - V(s) 为 TD 误差。
| 方法 | 目标 | 何时更新 |
|---|---|---|
| MC | 完整 G_t | episode 末 |
| TD(0) | R+γV(s') | 每步 |
| DP | 全 s' 期望 | 需模型 P |
TD 控制
SARSA(on-policy):
Q(s,a) ← Q(s,a) + α [R + γ Q(s',a') - Q(s,a)]
其中 a' 由当前行为策略(如 ε-greedy)采样。
与 Q-learning 区别:SARSA 用实际下一步 a';更保守,考虑探索风险(悬崖行走常选 SARSA)。
⚠️ 常见坑:α 太大 TD 发散;太小学习极慢——常从 0.1 量级试起。
💡 关键直觉:Bootstrap = 用估计更新估计;快但不保证无偏。
本章回顾
- TD(0) 单步更新
- TD 误差 δ
- 比 MC 低方差
- SARSA on-policy
- 为 Q-learning 铺垫
深度扩展:bootstrap 的代价与 SARSA vs Q-learning 的直觉
TD 用"估计更新估计"(bootstrap),这是它比 MC 快的原因,也是它"有偏"的来源。这里把偏差点讲透,并用悬崖行走这个经典例子说明 SARSA 与 Q-learning 的差异。
悬崖行走(Cliff Walking):智能体从左上走到右下,最短路经过悬崖 每走一步奖励 -1;掉下悬崖立即终止,奖励 -100;到达终点奖励 0(无-1) SARSA 学到的是"带探索地走"的策略:因为更新用的是实际下一步动作, 它会避开悬崖边缘——毕竟按 ε-greedy 走,边缘一步很可能踩空 Q-learning 学到的是"最优(贪婪)"策略:更新用 max Q(s',·), 它"相信"自己总能走对路,于是贴着悬崖抄近路 结果:Q-learning 最终回报更优(路径更短),但训练过程中掉崖次数更多
bootstrap 的偏差:MC 的估计只用真实数据(无偏);TD 的目标 R+γV(s') 里混入了"自己上一轮对 s' 的估计",如果那个估计本身有偏(比如初始化不当、数据不足),偏差会沿递归传播。代价换来的是方差大降(只依赖一步随机性而非整条轨迹)和"每步都能更新"(不需要等 episode 结束)。偏差-方差权衡是 TD 与 MC 之争的核心:实践中 TD 家族(含 Q-learning、DQN)因为样本效率高而成为绝对主流。
SARSA 为何更保守:SARSA 的更新里"下一步动作 a'"由当前行为策略真实采样得出——如果行为策略带探索,a' 可能是随机乱选的动作,TD 目标就包含了"探索带来的坏结果",于是 Q 值会把"探索风险"也记进账里。这使它学到的策略更稳健、更怕悬崖,但代价是最终性能受限于探索程度。Q-learning 的更新用 max,完全无视行为策略的探索——它直接逼近"如果未来每一步都选最优"的价值,所以最终能学到更优策略,但训练过程更"莽"。
选哪个:任务里"错误代价高昂"(如真实机器人会摔坏、资金会损失)倾向 SARSA;能安全试错(仿真、游戏)且追求最优性能倾向 Q-learning。理解这对差异,也是理解 on-policy 与 off-policy 分野的最佳入口——SARSA 只用自己正在执行的策略产出的数据(on-policy),Q-learning 可以复用任意策略采样的数据去学最优策略(off-policy),后者正是 DQN 能大规模复用经验回放池的根基。
动手练习:手算一次 TD 更新,并对比 SARSA 与 Q-learning
用具体数字把 TD(0) 和两种控制的更新式各算一次,把公式变成肌肉记忆。设定:γ=0.9,α=0.5,当前 Q 表里 Q(S1, a1)=1.0,V(S1)=0.8,V(S2)=2.0,下一步实际走到了 S2 并得到奖励 r=1。
TD(0) 更新 V(预测任务): TD 目标 = r + γ·V(S2) = 1 + 0.9×2 = 2.8 TD 误差 δ = 2.8 - V(S1) = 2.8 - 0.8 = 2.0 V(S1) ← V(S1) + α·δ = 0.8 + 0.5×2 = 1.8 SARSA 更新 Q(on-policy 控制): 假设在 S2 按当前行为策略实际选了 a2',且 Q(S2,a2')=1.5 Q(S1,a1) ← 1.0 + 0.5×[1 + 0.9×1.5 - 1.0] = 1.0 + 0.5×1.35 = 1.675 Q-learning 更新 Q(off-policy 控制): 假设 Q 表里 S2 的最大动作价值是 Q(S2,a_best)=2.5 Q(S1,a1) ← 1.0 + 0.5×[1 + 0.9×2.5 - 1.0] = 1.0 + 0.5×2.25 = 2.125
三个式子的差别一目了然:TD(0) 用的"下一步价值"是 V(S2);SARSA 用的是"实际下一步动作 a2' 的价值"Q(S2,a2');Q-learning 用的是"S2 下所有动作里最大的"max Q(S2,·)。最后一行比第二行高出不少,就是因为 max 项"相信未来会选最优动作"。这也解释了为什么 Q-learning 更适合探索中学习——它更新时总以"最优未来"为目标。请把这三个数各自重算一遍,并思考:如果行为策略的 ε 很大(下一步大概率是随机动作),SARSA 的目标会被随机动作的坏价值拖低,而 Q-learning 不会——这正体现了 off-policy 对探索的"免疫"。理解到这一层,本节的公式就真正是你的了。
常见误区辨析
时序差分学习的常见误区有三个。一是把"TD 比 MC 好"当绝对结论——TD 低方差、能每步更新,但有偏、受初始化影响;MC 无偏但方差大。判断标准是任务场景:样本多、要快收敛选 TD;对偏差敏感、任务天然分幕可选 MC。二是忽略 α 的作用——α 太大 TD 会震荡发散,太小则学习极慢,且理想上要随训练衰减;很多"TD 不收敛"的案例其实是 α 没调好,而不是算法错了。三是混淆 SARSA 与 Q-learning 的更新目标——SARSA 用"实际下一步动作 a' 的价值",Q-learning 用"下一步所有动作的最大价值",差一个 max 项就改变了 on/off-policy 属性,代码里写错这一项,行为会和预期完全相反。