4.3 Q-Learning
4.3 Q-Learning
本节摘要:Off-policy TD control:Q(s,a)←Q(s,a)+α[r+γ max_{a'} Q(s',a')-Q(s,a)]。行为策略 ε-greedy 探索,更新用 greedy 目标。离散小状态可 tabular 收敛到 Q*。
阅读收获
- 写 Q-learning 更新式并解释 max 项
- 区分 behavior policy 与 target policy
- 实现 tabular Q-learning 主循环
更新规则
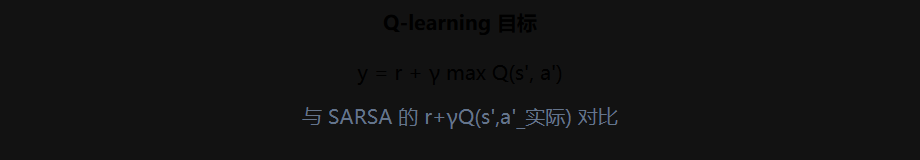
Q(s,a) ← Q(s,a) + α [ r + γ max_a' Q(s',a') - Q(s,a) ]
- 行为策略:ε-greedy 选 a 与环境交互
- 目标策略:implicit greedy(max over a')
- 故为 off-policy:学最优 while 探索
# tabular Q-learning 一步 a = epsilon_greedy(Q, s, eps, nA) s2, r, done = env.step(a) Q[s,a] += alpha * (r + gamma * Q[s2].max() - Q[s,a]) s = s2
收敛与局限
收敛条件(tabular):每 (s,a) 无限访问,α 满足 Robbins-Monro。
局限:
- 大/连续状态 → Q 表爆炸,需函数近似(DQN)
- 非线性逼近时 Q-learning 可能发散(需 target net、replay)
| 算法 | 下一步动作 | 策略类型 |
|---|---|---|
| SARSA | 实际 a' | on-policy |
| Q-learning | max Q(s',·) | off-policy |
⚠️ 常见坑:max 与 ε-greedy 探索矛盾——训练初期 max 过估计未访问 (s,a)。
💡 关键直觉:Q-learning 直接学 Q*,最优 π(s)=argmax Q(s,·)。
要点串联
- off-policy TD control
- max_a' 是 greedy 目标
- ε-greedy 行为探索
- tabular 可收敛 Q*
- 大状态→深度 RL
深度扩展:max 项的双面性——Q-learning 的过估计问题
Q-learning 更新式里的 max 项既是它 off-policy 力量的来源,也是它著名的"过估计"问题的源头。这里把两面都说清楚,为第 5 章 DQN 的 Double DQN 改进埋下伏笔。
# 概念:为什么 max 会过估计 import random def noisy_estimate(true_q, samples): # 用 N 个带噪声样本估计 Q,噪声均值为 0 est = sum(random.gauss(true_q, 1.0) for _ in range(samples)) / samples return est # 对两个真实 Q 都是 0 的动作分别估一次: # 因为噪声为正时取 max,E[max] > max(E) = 0
过估计的机制:max 运算取的是"一批估计值里的最大值"。即使每个动作的 Q 估计在数学期望上无偏(噪声均值为 0),取 max 之后结果也会偏高——因为正噪声被 max 选中、负噪声被丢弃。表格法里这个偏差通常被"大量采样平均"稀释,影响可控;但换到神经网络近似(第 5 章 DQN),每个动作的 Q 由网络输出、噪声大且相关,过估计会被放大,导致 Q 值虚高、策略贪心地选择"虚高的动作"。
为什么还是用它:因为 max 带来的 off-policy 学习能力太重要了——它可以"用探索数据学最优策略",不需要等待最优轨迹出现。表格 Q-learning 在满足收敛条件(每对 (s,a) 无限访问、学习率满足衰减)时能收敛到 Q*,这是它成为经典算法的底气。过估计是"工程要处理的问题",不是"理论不成立的证据"。
收敛条件的工程含义:理论上要求每对 (s,a) 无限次访问,实际上做到"充分访问"即可——这就靠 ε-greedy 的 ε 不能降得太快、也不能为 0。同时 α 要按衰减规律缩小,否则后期更新会持续震荡不收敛。这两条在实现上都很容易违反,是 tabular Q-learning"看起来简单、跑起来玄学"的主要来源。
与 SARSA 的呼应:Q-learning 的 max 用的是"贪婪目标",SARSA 用的是"实际下一步动作",所以 Q-learning 敢于贴着悬崖走最短路,SARSA 会避开悬崖。训练轮数充足且能安全试错时 Q-learning 更优;试错代价高时 SARSA 更稳。第 4 章这三节(MC、TD、Q-learning)串起来看,是一条"越来越能用、越来越复杂"的演进链:MC 等整局 → TD 走一步 → Q-learning 用 max 直接学最优。理解这条链,就能平滑过渡到第 5 章。
动手练习:实现 tabular Q-learning 的检查清单
"看懂"和"实现"之间隔着一条巨大的沟,这里给一份实现检查清单,帮你把 4.3 的代码写对、调稳。
初始化阶段: □ Q 表维度 = |S| × |A|,用 0 初始化(或小随机值) □ 选定 α(0.1~0.3 起步)、γ(0.9 起步)、ε(1.0 起步,随步数衰减) 主循环阶段(每个 episode): □ env.reset() 拿初始状态 □ 用 ε-greedy 从 Q 表选动作(注意:训练全程保持探索,ε 别为 0) □ env.step(a) 拿 (s2, r, done) □ 执行更新:Q[s,a] += α * (r + γ * max(Q[s2]) - Q[s,a]) □ done 时结束本 episode,统计回报并记录 调试阶段: □ 打印平均回报曲线:应整体上升(允许单点波动) □ 打印 Q 表检查:终态附近价值最大,且路径方向价值递增 □ 跑通后把 ε 设为 0 验证:策略是否走最优路径
实现时最容易犯的三个错误:一是更新用了 s2 的实际动作而非 max(把 Q-learning 写成了 SARSA);二是 α 忘了随时间衰减或取得太大(后期震荡不收敛);三是 ε 过早降到 0(Q 表未收敛,策略锁死)。写完代码后,用一个 10×10 格子环境跑一遍:如果 1 万步内平均回报明显上升、5 万步内接近最优,说明实现正确。把这四条检查清单存下来,它就是你后续实现 DQN 等算法时的最小验证框架——毕竟 DQN 只是"Q 表换成网络 + 经验回放 + 目标网络",主循环骨架和这份清单完全一致。
常见误区辨析
Q-learning 的常见误区:一是把"更新式的 max 项"当成随便的记号——它是 off-policy 的灵魂,去掉它就成了 SARSA,性质完全不同;二是以为 Q-learning 不需要探索——它学的是最优策略,但必须靠行为策略(通常 ε-greedy)采集数据,ε 为零就失去探索、Q 表无法更新,训练停摆;三是忽略收敛条件的工程含义——表格法能收敛到 Q* 的前提是每个 (s,a) 充分访问、学习率逐步衰减,跑几百轮就判定"算法无效"通常是被这两点坑了。