5.3 策略梯度入门
5.3 策略梯度入门
本节摘要:直接优化参数化策略 π_θ(a|s)。策略梯度定理:∇J(θ)=E[Σ_t ∇log π_θ(a_t|s_t) G_t]。REINFORCE 蒙特卡洛策略梯度;适合连续动作、随机策略。与 DQN 值函数路线互补。
上手前先明确
- 写策略梯度定理直觉(log 导数 trick)
- 说明 REINFORCE 用完整 G_t 更新 θ
- 对比 value-based 与 policy-based
为何策略梯度
DQN 局限:离散动作、max over a 难扩展到连续(需积分或离散化)。
策略梯度:输出 π_θ(a|s) 分布,连续动作采样即可。
参数化:π_θ(a|s),θ 为 NN 权重。
策略梯度定理
目标 J(θ)=E[G_0|s_0](或平均回报)。
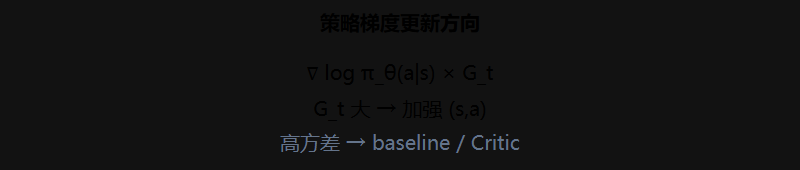
∇_θ J(θ) = E_π [ Σ_t ∇_θ log π_θ(a_t|s_t) · G_t ]
直觉:G_t 好 → 增大该轨迹动作概率;G_t 差 → 减小。
REINFORCE:
- 用 π_θ 采样完整 episode
- 算每步 G_t
- θ ← θ + α Σ_t ∇ log π_θ(a_t|s_t) G_t
| 路线 | 代表 | 动作空间 |
|---|---|---|
| Value-based | Q-learning, DQN | 离散为主 |
| Policy-based | REINFORCE, PPO | 连续/随机 |
方差与 Actor-Critic
REINFORCE 用 MC G_t 高方差 → 引入 baseline b(s) 或 Critic V(s) 估计优势 A=G-V。
Actor-Critic:Actor 更新 π_θ,Critic 更新 V_φ(SOURCE 6.3 方向)。
⚠️ 常见坑:学习率过大 REINFORCE 崩溃;需 reward 标准化或 baseline。
💡 关键直觉:DQN 学 Q 再贪心;策略梯度直接推 π,连续控制更自然。
核心回顾
- π_θ(a|s) 直接优化
- 策略梯度定理 + log trick
- REINFORCE MC 更新
- 连续动作优势
- Actor-Critic 降方差
深度扩展:log 梯度 trick 与 REINFORCE 为什么方差大
策略梯度定理里那个 ∇log π_θ(a|s) 看似突兀,其实是"从采样的轨迹里估计梯度"的数学必然。这里用最直觉的方式解释它,并说明 REINFORCE 高方差的来源与对策。
朴素想法:想让"回报高的轨迹"更可能发生 = 增大该轨迹所有动作的对数概率 log π_θ(a|s) = 对 θ 求梯度:∇θ log π_θ(a|s)(对每个时刻) = 按回报 G_t 加权这条轨迹的梯度 REINFORCE 更新: θ ← θ + α · [∇log π_θ(a|s) · G_t](对轨迹内每步求和)
为什么是"log":因为概率要归一化(所有动作概率和为 1),直接对概率 P 求梯度会互相牵扯;取 log 后梯度分解成干净的"每步独立项",且 ∇log P = ∇P/P 天然带上"该动作越不可能、一旦发生贡献越大"的权重——这就是 log 导数 trick。它让"从整条轨迹里学梯度"变成了可逐项计算的求和。
REINFORCE 的方差为什么大:梯度每步都被完整的 G_t 加权,而 G_t 是整条轨迹的随机结果(幸运/不幸运运气成分大)。同一策略多跑几条轨迹,G_t 可能从 -10 到 +50 剧烈波动,导致梯度方向忽左忽右——这正是第 4 章 MC 高方差的"策略版本"。方差大 → 要极多轨迹 → 样本效率低,这是策略梯度方法最初被诟病的点。
降方差的标准路线:给梯度减一个与动作无关的基线 b(s)(如状态价值 V(s)),∇log π·(G_t - b) 的期望不变(因为 E[∇logπ·b]=0),但方差大幅下降——(G-V) 就是"优势"的雏形。更进一步,让一个独立的 Critic 网络实时估计 V,Actor 用"优势"更新策略,这就是 Actor-Critic 框架:Actor 学策略,Critic 学价值,两者配合。它比 REINFORCE 稳定得多,是 PPO 等现代算法的直接前身。
两条路线的分工:值函数路线(DQN)适合离散动作、数据利用率高;策略梯度路线适合连续动作与随机策略、训练更稳但样本效率低。现代实践里两者常融合——PPO 用策略梯度框架、同时借目标网络与裁剪技巧控制更新幅度,兼顾稳定与样本效率。理解 DQN 与 REINFORCE 各自的短板,再去看 PPO 的每一处设计(clip、advantage、batch 更新),会发现全部都是在"补短板"。
动手练习:做一份两种路线的选型对比表
把"值函数路线 vs 策略梯度路线"的选型判断变成你的决策能力。请为以下四个场景各写一行结论:场景一,动作空间是离散的、状态维度适中(如网格游戏)——选 DQN 类值函数方法,离散动作天然匹配、样本效率高;场景二,动作是连续值(如机器人关节力矩)——选策略梯度(或 Actor-Critic),DQN 无法直接输出连续动作;场景三,策略本身就该是随机的(如扑克需要诈唬、猜拳需要随机出招)——选策略梯度,它直接输出动作概率分布;场景四,团队要求"每个决策都可解释"——值函数方法相对更容易检查 Q 表,而策略梯度的神经网络策略更像黑盒,倾向 DQN 类表格化方案。
写完后思考两个问题。第一,为什么 PPO 是当前主流?——它用策略梯度框架但引入"重要性采样 + 裁剪",既保留连续动作能力,又把更新幅度控制住,解决 REINFORCE 的高方差与训练不稳。第二,是否一定要二选一?——不必,现代方法常融合两者:Actor-Critic 里 Actor 用策略梯度更新、Critic 用值函数估计优势,就是把两条路线的长处拼在一起。这张对比表做完,你对"何时用哪种方法"就有了初步的实战地图——遇到新问题先回答"离散还是连续、要随机还是确定、能否大量试错",答案自然指向正确的路线。后续读 PPO、SAC 论文时,带着这张表你会更容易理解它们各自在哪个维度做了取舍。