5.2 深度Q网络DQN
5.2 深度 Q 网络 DQN
本节摘要:Mnih 2015:CNN 输入 Atari 四帧像素,输出各动作 Q 值。Experience Replay 打破样本相关;Target Network Q(s',·;θ⁻) 固定目标缓解 moving target。Atari 超人类表现标志 Deep RL 兴起。
本节地图
- 解释 replay buffer 如何 i.i.d. 采样
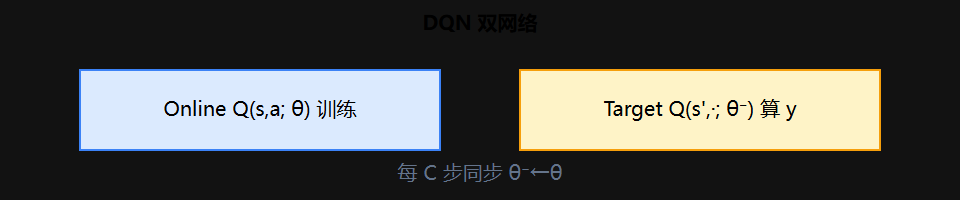
- 说明 target net 每 C 步同步 θ⁻←θ
- 写 DQN 损失 (y - Q(s,a;θ))²
问题驱动
现象:NN Q-learning loss 震荡发散 → 原因①相邻帧高度相关 ②目标 y 用正在变的 Q 算。
对策:Replay + Target Network。
算法要点
- 存 transition (s,a,r,s',done) 到 buffer D
- 从 D 均匀随机 minibatch 采样
- 目标:y = r + γ max_a' Q(s',a'; θ⁻),终止则 y=r
- 损失 L = E[(y - Q(s,a;θ))²],梯度下降 θ
- 每 C 步 θ⁻ ← θ
| 组件 | 作用 |
|---|---|
| CNN | 从像素提特征 |
| Replay | 去时间相关、复用数据 |
| Target net | 稳定 y |
| ε-greedy | 行为探索 |
后续改进(SOURCE 提及)
Double DQN 减 max 过估计;Dueling 分解 V+A;Prioritized Replay;Rainbow 组合。
⚠️ 常见坑:不设 target net 或 replay 过小——Q 值爆炸。
💡 关键直觉:DQN = Q-learning + NN + 工程稳定器;离散动作专用。
一节小结
- CNN 处理高维输入
- Replay 随机 minibatch
- Target network 固定 y
- Atari 里程碑
- Double/Dueling 等演进
深度扩展:replay 与 target 到底各治什么病
DQN 相对朴素 Q-learning 只多了两个组件,但每个都对应一个具体的训练崩溃机制。把它们"对号入座",DQN 就没什么神秘的了。
问题一:样本高度相关,网络被"眼前的轨迹"带偏 └─ 治疗:经验回放。把 (s,a,r,s',done) 存进缓冲区, 训练时均匀随机抽 minibatch,打散时间相关性 问题二:TD 目标里的 Q 自己在变,网络追着移动靶子打 └─ 治疗:目标网络。用一个冻结的旧参数 θ⁻ 算目标 每 C 步才把 θ 同步过去,目标在 C 步内是稳定的
经验回放的三重收益:除了打散相关性,它还把每一条经验反复复用(数据利用率提升),并让不同时刻的经验被公平采样(不会因为刚跑过某段就把那段的样本刷屏)。代价是缓冲区占用内存、且回放里都是旧策略的样本(off-policy 才能这样用——正好是第 4 章 Q-learning 打下的底子)。缓冲太大时旧经验会"教坏"新策略(分布过时),太小则失去打散意义,工程上是个要平衡的容量参数。
目标网络的节奏:目标参数 θ⁻ 每 C 步更新一次,C 通常取几千步(如 1000~10000)。C 太小等于没有目标网络(目标追着动),C 太大则目标长期过时、学习迟缓。同步时直接把 θ 复制给 θ⁻,简单粗暴但有效。这是"用可控的滞后换训练稳定"的经典工程手法。
DQN 的局限与演进:DQN 只适合离散动作(输出层是每个动作一个 Q 值),连续动作(机器人关节力矩)就无从下手——这引出第 5.3 节策略梯度路线。而 DQN 自身的 max 过估计问题(第 4 章讲过)在神经网络下被放大,催生了 Double DQN(用另一个网络选动作、本网络给值),再加上 Dueling(把 Q 拆成 V+A)、Prioritized Replay(按误差加权采样)等改进,最后汇成 Rainbow 一揽子方案。看 DQN 家族演进时,始终带着"它又在修哪个病"的问题,就不会迷失在技巧堆里。
动手练习:排一份 DQN 调试顺序
DQN 一旦训练失败,先查什么后查什么,顺序很重要。这里给一份按"问题出现频率"排序的调试清单,请把它和你的训练代码逐条对一遍。
第 1 步 环境问题:reward 范围正常吗?done 设置对吗? (最常被忽略——先手动玩一遍环境) 第 2 步 采样问题:replay buffer 太小(如 <10000)或从不回放? (DQN 没打散相关性,一切免谈) 第 3 步 目标问题:target net 每 C 步同步了吗?C 是否太大/太小? (目标一直变 = 追移动靶,loss 必炸) 第 4 步 网络问题:网络太深/学习率太大导致 Q 值爆炸? (试浅层网络 + 更小学习率) 第 5 步 探索问题:ε 衰减太急,策略锁死?或从不衰减? 第 6 步 过估计问题:Q 值整体虚高但策略还行? (此时才轮到 Double DQN 等进阶技巧)
这份顺序背后的逻辑是"从最可能的工程错误,到最微妙的算法问题"。如果训练曲线一开始就不动(前几千步没学习信号),先查第 1、2 步——多半是环境或回放没生效;如果曲线上升后突然崩掉,重点查第 3 步目标网络;如果曲线整体正常但最终 Q 值虚高,才考虑第 6 步的进阶改进。不要一失败就怀疑算法本身——深度 RL 的失败九成是工程性的。建议把这份清单抄在代码注释里,每次 DQN 训练出问题就从头走一遍,能省下大量试错时间。等你对这份清单的每一步都有了亲身体验,再去看 Double DQN、Dueling、Prioritized Replay 各自的论文,就会发现它们解决的正是清单里某一步的极端情况——把"修 bug"的过程走完整,读论文时会心领神会,少踩大量隐蔽的坑。