5.3 CI/CD 与可观测性:上线与监护两条流水线
5.3 CI/CD 与可观测性:上线与监护两条流水线
摘要:微服务依赖机器而非人肉来点头。"上线"要自主:代码提交→构建→测→打包→灰度→全量应由 CI/CD 扛住;"看着"要开眼:指标、日志、追踪三件套让故障在蒙眼开车前就现形。本文把这两条流水线讲透,并说清它们凭什么决定微服务能不能长期站住。
前面把服务装进了容器、交给了编排,但"装进 k8s"不等于"能像样地上线"。如果每次发布还是人肉敲命令、点按钮,二十个服务就能把发布工程师累垮,也更别谈"频繁小步上线"这个微服务最大的卖点。自动化上线这一段,就是 CI/CD 的职责;而自动化之后你还得"看得见",那就是可观测性。
CI/CD:一条从提交到上线的自动驿站链
把"发布"拆成一段段自动化的驿站:**持续集成(CI)**负责代码提交后自动构建 + 自动测试,**持续交付/部署(CD)**负责把通过验证的构建产物一路推到目标环境甚至自动上线。
关键在于**"门禁"**:每一项自动化不是"走流程",而是"不过就拦"。测试挂了镜像就不出、冒烟没过就不进灰度、灰度反馈差就自动回滚。这让"发布"从"赌一把"变成"有把握的反复演练"。
灰度与回滚,给发布上保险
微服务要频繁上线,就必须有平滑切换的安全网。灰度发布就是让新版本先吃小部分流量试水:先 1%,观察指标正常,再逐步到 10%、50%,最后全量。任何一步异常都能顺势回滚到上一个版本。
# 示意:CD 里给服务配的"稳态发布"节奏(表达意图,不是某 ERP 的专有语法) name: 订单服务部署 stages: - name: 灰度1% traffic: 1% gate: 错误率 < 0.5% 且延迟无抬头 - name: 灰度10% traffic: 10% gate: 指标平稳 - name: 全量 traffic: 100% rollback: 上一个镜像版本
灰度不只靠 CD 平台,往往还要配合接口网关做按比例的流量切分(接通我们第 3 章网关的路由能力)和按用户标签的"金丝雀"。没有灰度与回滚的发布,等于把一个不确定的东西整个扔上擂台。
可观测性:蒙眼开车前,先让眼睛亮起来
服务一多,最要命的是不知道哪出事了。可观测性(Observability)是把"盲"变成"可视"的三件套,缺一不可:
- 指标(Metrics):强量化,回答"系统现在怎么样"——请求量、错误率、各服务分位延迟(P95/P99)、CPU 内存、队列积压。靠它们做报警与趋势判断。
- 日志(Logs):强细节,回答"到底发生了什么"——一次请求的处理轨迹,出问题看它最直观。
- 追踪(Tracing):回答"这笔请求跨服务走了哪条路、每段花了多久"——跨服务性能瓶颈和故障定位的钥匙,通过请求 ID(traceId)串联。
追踪是微服务排错的方向盘
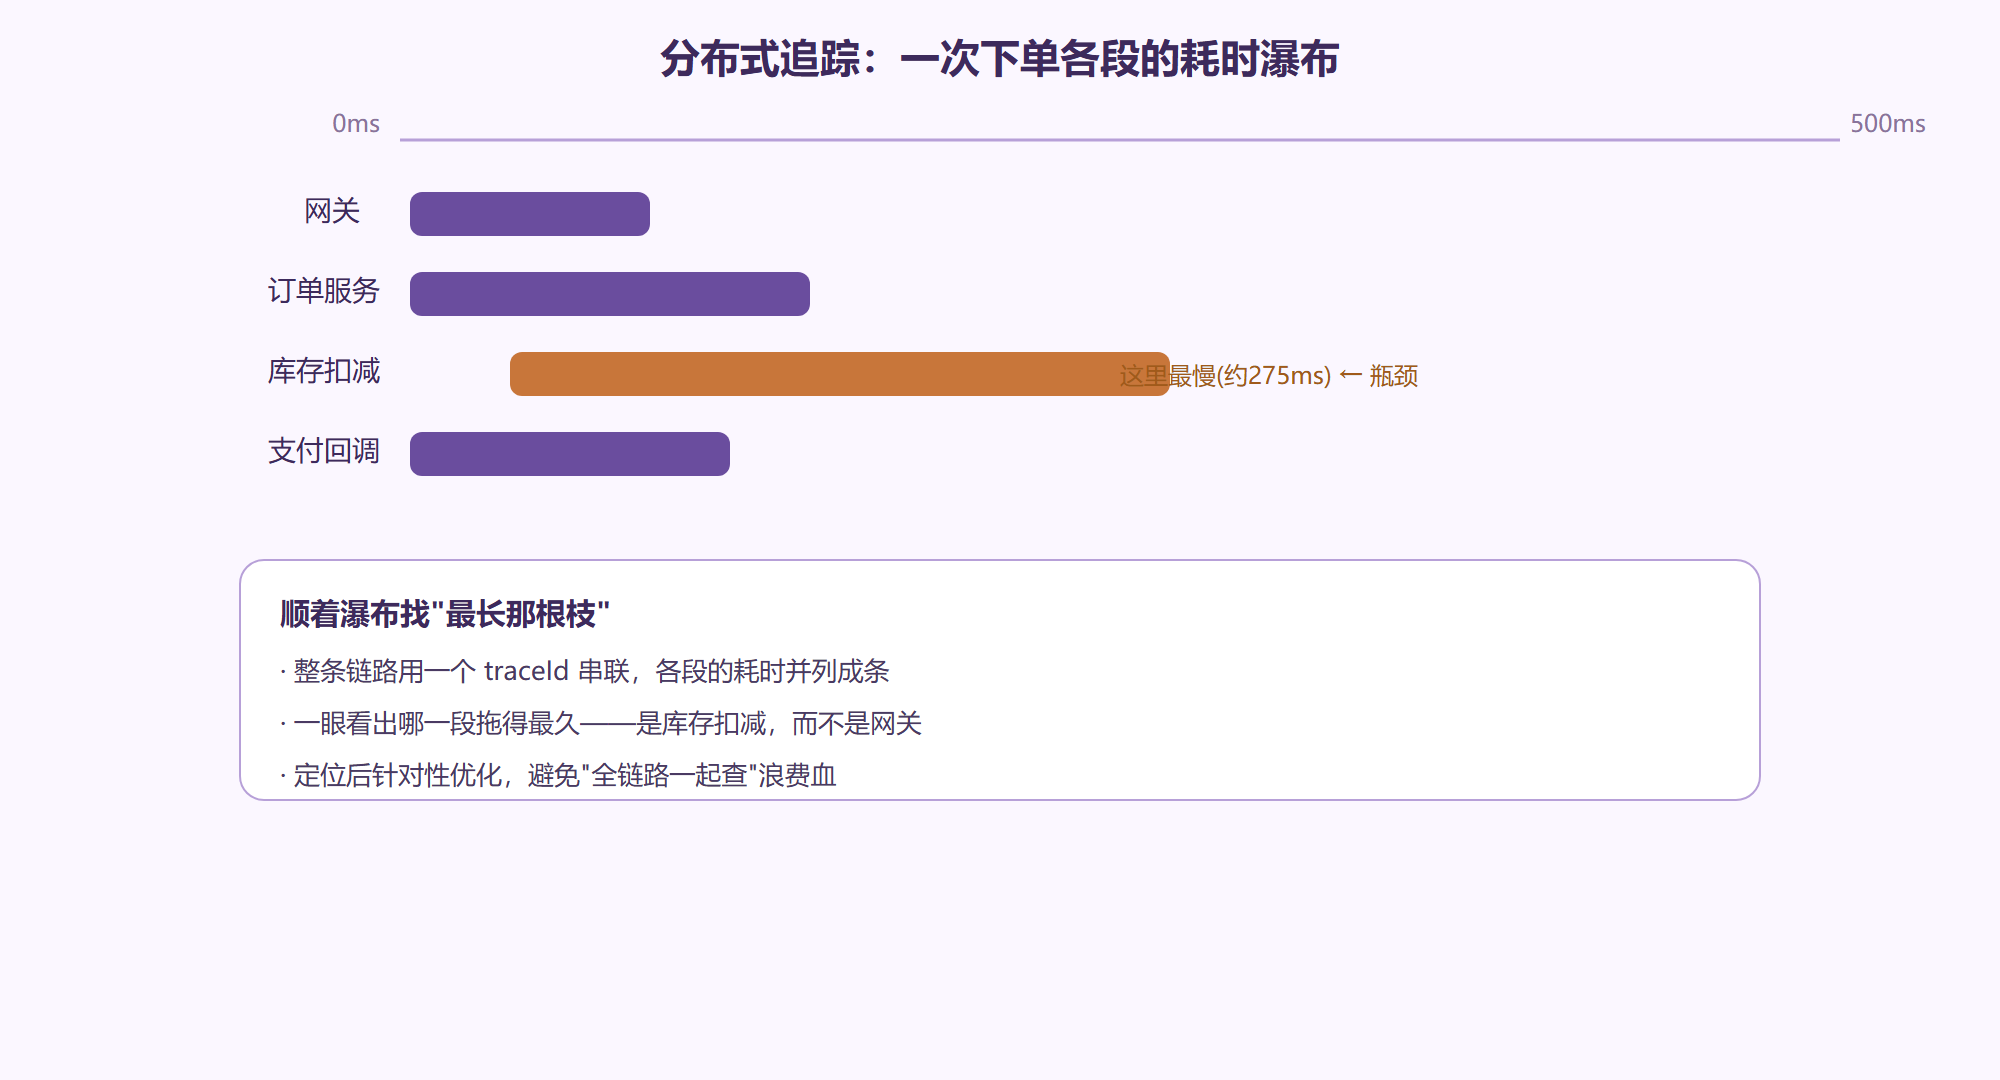
指标的毛病是"只看结果",日志的毛病是"太散"(一个请求的日志分落在五六个服务里)。跨服务故障最难回答的一句"这个下单为什么慢",只有分布式追踪能答:它能按 traceId 把一次请求在订单、支付、库存的每一段耗时串联成一棵树,一眼看出慢在谁那一段。
基本约定就三样:每个进入系统的请求生成一个全局唯一的 traceId;它沿调用链一路传递下去;每段把自己"父 span + 子 span"的关系带上,形成调用链。做好这三样,跨服务排错就从"大海捞针"变成"顺着树找最长的那根枝"。
一条下单单的追踪瀑布:慢点一眼现形
三条红线别踩
红线一:日志不要把敏感信息打全量。 可观测性要开眼,不是给别人看你用户密码。日志/指标里脱敏是底线,别让"能看见"变成"在裸奔"。
红线二:别把可观测性当成"事后接插件"。 每个服务从第一天就该埋指标、写结构化日志、带上 traceId。中途再补,成本是翻倍的,而且历史数据断档。
红线三:报警别滥发成"狼来了"。 告警阈值拍脑袋设,导致天天全红、没人看,最后关键故障反而被淹。报警要"精":宁可少而准,不要求多而全。
一小段总结:为什么说"成败在运维"
把两条流水线合起来看,你会发现:CI/CD 让"改得快"变得安全,可观测性让"改坏了"不被埋,它俩一起回答了微服务最核心的承诺——"频繁变更但系统稳定"。如果这两条都没搭,拆得再细致的微服务,也只是把"一个大型单体的复杂度"换成了"多个运维事故的合集"。所以那句话不是鸡汤,是真题。
把"灰度"养成一种日常演练
灰度既是发布手段,更应是一种习惯:每次变更都是一次可控的小型实验。温和的做法是给每次发布配一条"灰度前后指标基线对比",上线前记下关键指标的 P95 与错误率,灰度放量时再对照,指标一抬头就立刻回滚。这样你每次上线都会留下"这版比上版快了多少、错率高了还是低了"的真实记录,而不是"打上新版本就以为完事了"。把灰度、可观测、回滚这三件事绑成一套平日就反复用的动作,等于给每一次变更都上了双重保险。
本节要点
-
一条切分提醒:CI/CD 负责"上线",可观测性负责"看着",两条流水线各司其职、缺一不可
-
CI=提交后自动构建+测试门禁;CD=把产物推到环境直到灰度全量
-
灰度(小流量试水)+ 回滚(异常撤下)是频繁上线的安全网
-
可观测三件套:指标答"现状",日志答"细节",追踪答"跨服务路径"
-
分布式追踪靠 traceId 链路串联一次跨服务调用
-
日志要脱敏、埋点从第一天起、报警宁少而准,别把运维做成狼来了