6.3 重试与舱壁:超时自救与水密隔舱
6.3 重试与舱壁:超时自救与水密隔舱
摘要:重试兜"偶发而可恢复"的失败,但要小心它自己变成放大风暴;舱壁用一个独立的资源池把一个服务的故障关在小隔间里,防止它"殃及池鱼"。本文用一次真实故障推导这两个机制该怎么装、怎么不会把自己坑了。
限流降级堵住了超载,熔断拦住了"下游已坏"。可还有两件事必须补:一件是单次偶发的抖动(网络闪断、短暂超时),正常情况下重试一次就好了——但重试一旦失控会变成风暴;另一件是故障的传染半径——一个服务把连接池占满,会不会把整台机器的线程池一起拖垮。这两个分别对应重试和舱壁。
重试的地盘:只能兜"偶发且可恢复"的失败
重试的前提必须严格:这个失败是暂态的、可恢复的,而不是"下游真的坏了"或"我参数发错了"。网络闪断、一次超时,重试合适;下游 500 连续叠加、400 说"你参数错",重试就是火上浇油。
判断依据一句话:"我再试一次能成吗?" 能成是因为它暂态,不能成是因为它由根本原因驱动——后者别重试,改排查。
重试的致命陷阱:放大风暴
最经典的翻车是"重试风暴"。假设支付服务变慢,100 个下单请求全都超时,每个又重试 3 次——瞬间变成 400 个请求砸向本已超载的支付,雪上加霜。多个上游一起重试,放大效应呈乘法。
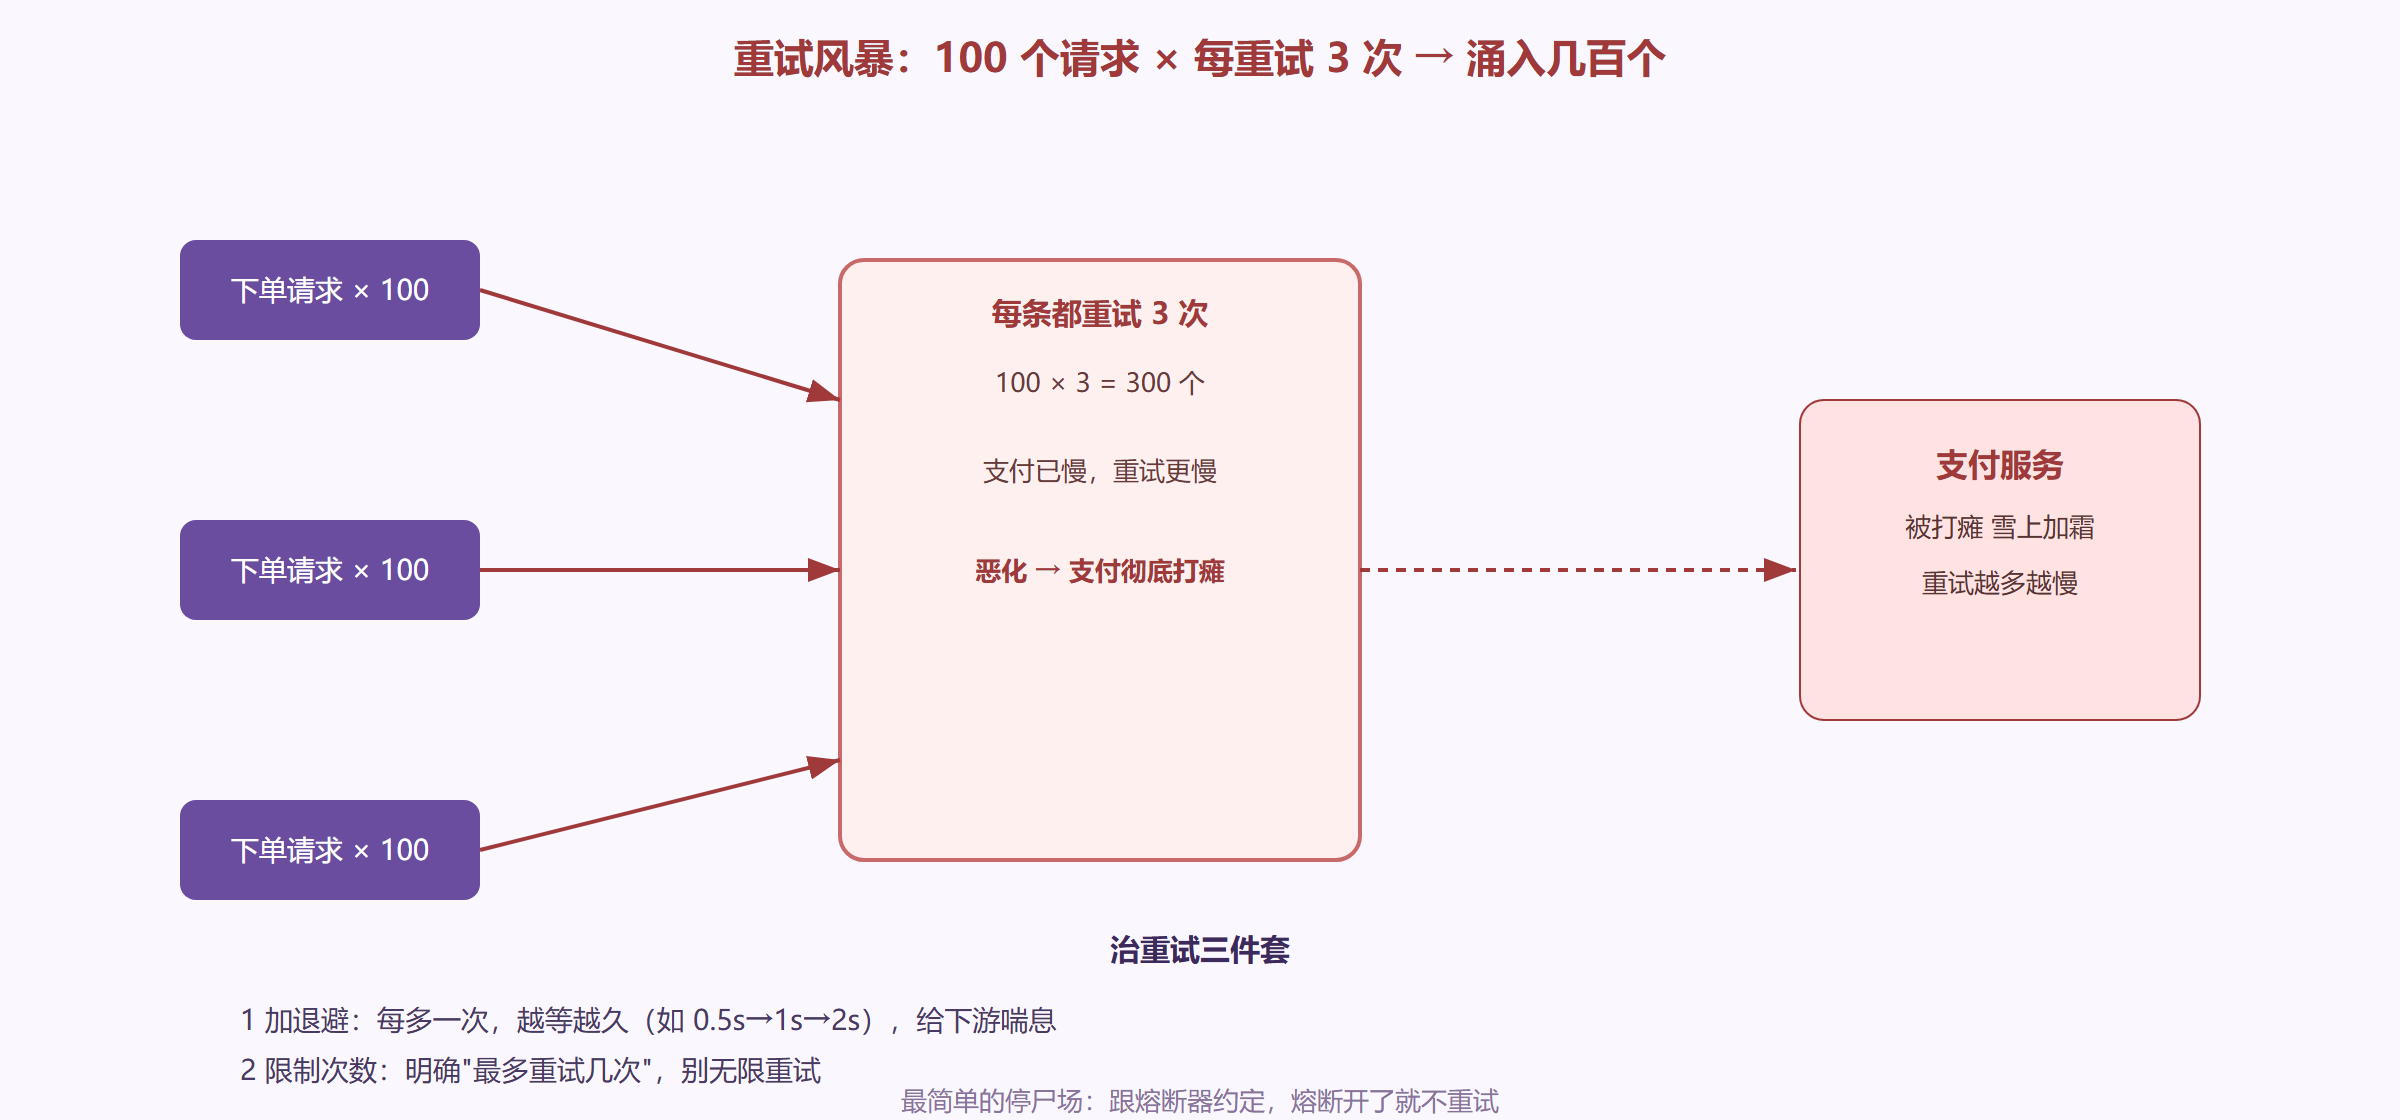
另外两个铁律,务必一起装:
给重试加退避(backoff):不要"失败就立刻再打",而是每次失败后间隔越来越长(0.5 秒→1 秒→2 秒)。它给下游留出恢复的时间,天然放慢放大节奏。
让重试幂等:同一个操作被重放一次,结果要一样。下单这种操作尤其关键——如果下单没做幂等,重试就可能"重复下单"甚至"重复扣款"。幂等的落地手段前面提过:用业务唯一键去重(比如同一个 orderId 只能成功建一次单),或用服务端状态判断"这单已经处理过"。
// 示意:带退避 + 限制次数 + 幂等键的请求 retry { client.pay(order, idempotencyKey = order.id) } .onFailure { delay(0.5 * pow(3, attempt)) } // 每次翻倍退避 .maxRetries(3) // 最多 3 次
舱壁:用"连接池细分"把一场介质切断
舱壁模式(Bulkhead)名字来自轮船的密封隔舱:船的一舱进水不会让全船沉没。在系统里,它的做法是为不同的下游/服务分配独立的资源池(连接池、线程池、信号量),让一个服务的拥挤只在它自己的池子里拥挤,不会把手伸到别人的池子里去。
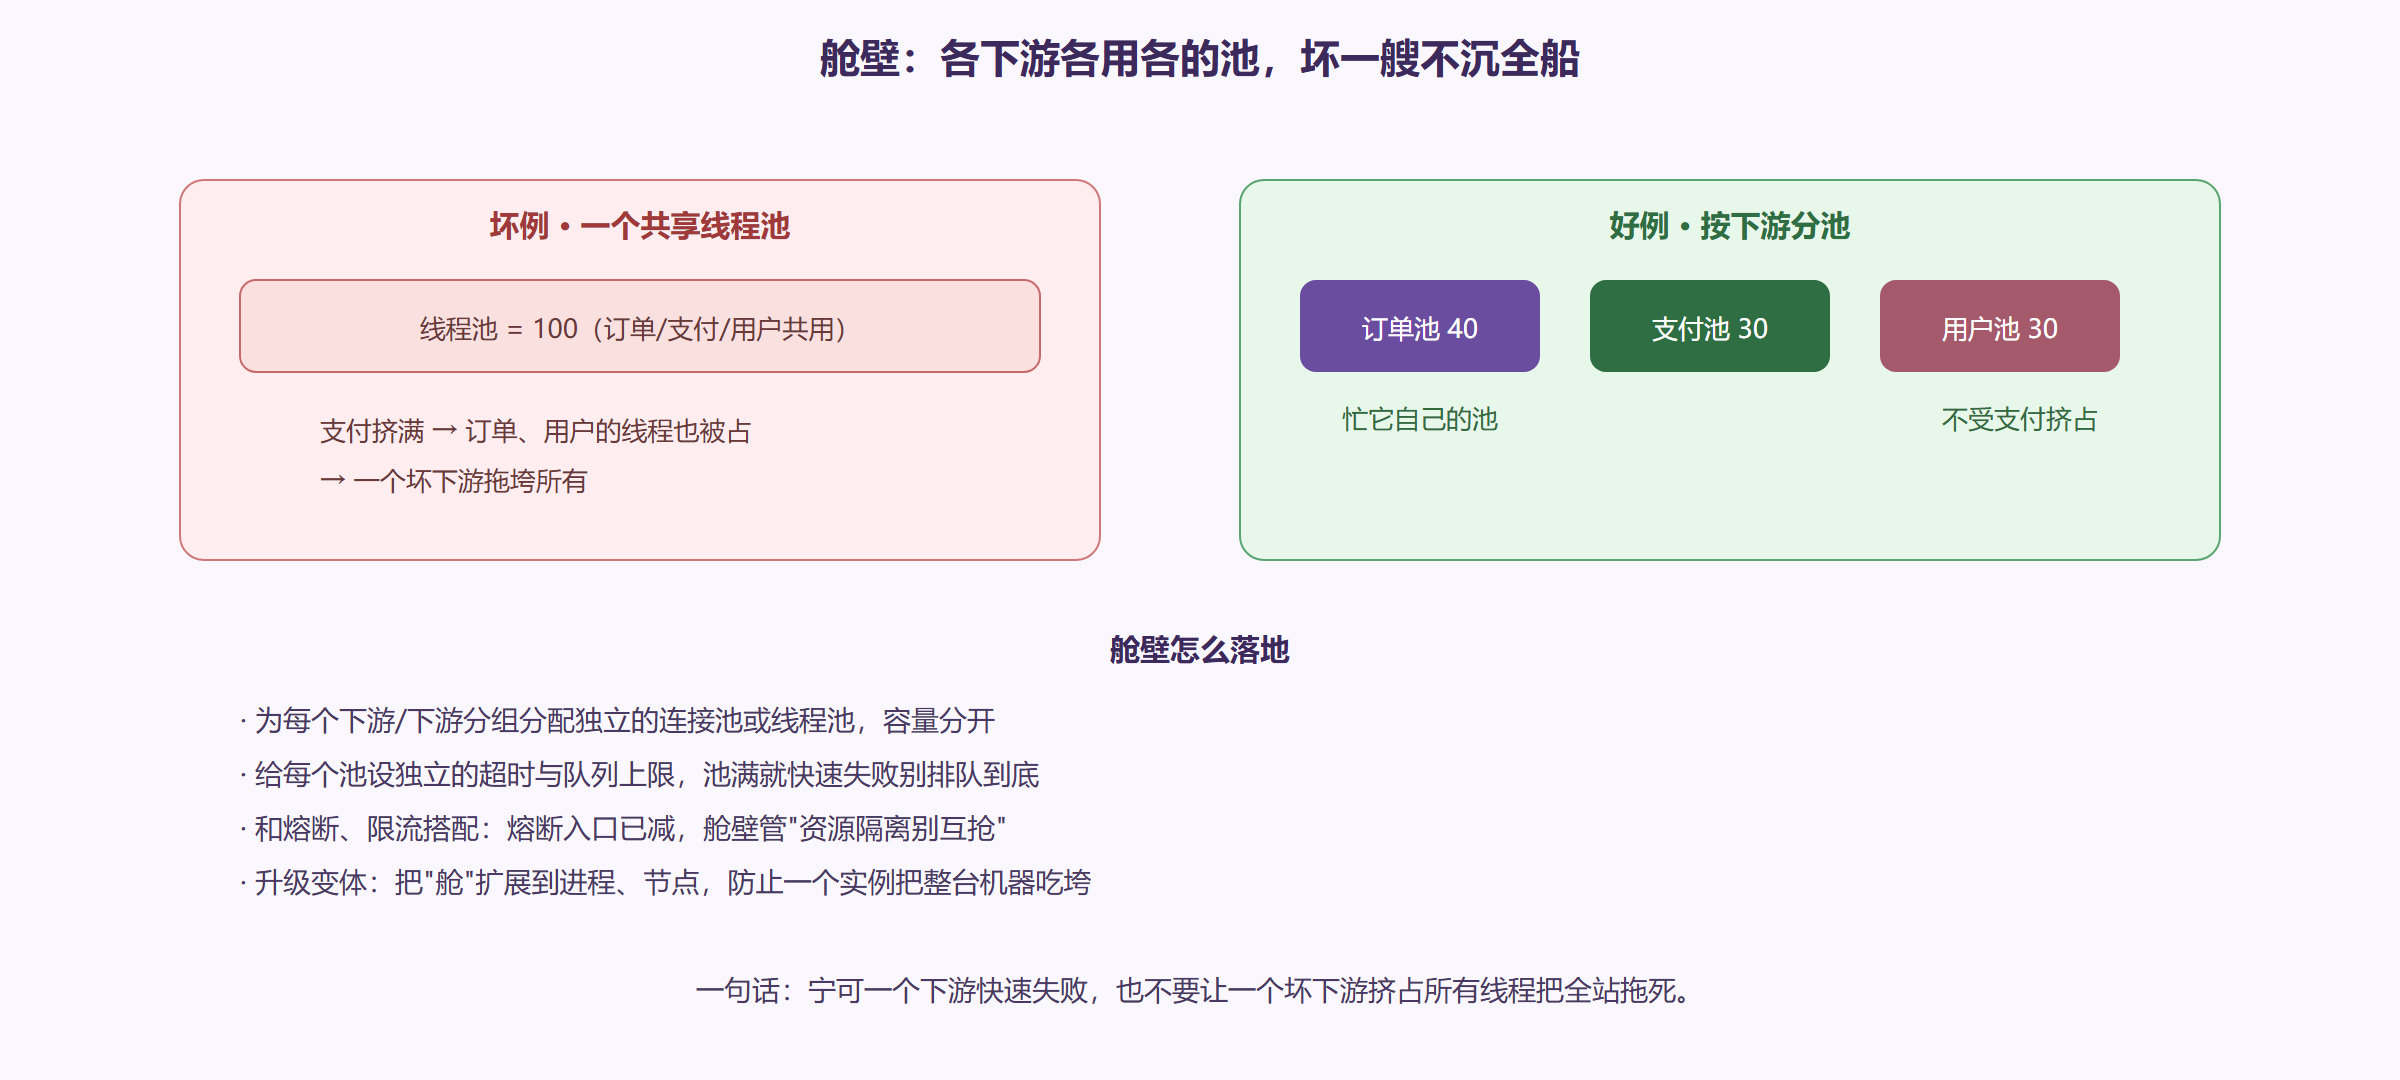
空舱壁落地的关键在于"池满就快速失败",而不是"池满就排队到天荒地老"——后者等于把挤占换了个地方继续发生。多数弹性框架都会给"信号量/线程隔离 + 队列上限 + 超时"这组合,把舱壁和熔断叠加,收效最好。
陷阱:只装重试不装退避和次数
"我给它写了重试",这句话本身不意味着安全。没退避、没次数上限、没幂等的重试,是一个随时能引爆的风暴源。装重试时务必三件齐备(退避、限次、幂等),否则不如不装——一个"会失控的重试"比"不重试"危险得多。
给重试装上"预算与并发帽",别让它自己变成最大流量来源
很多人以为装好退避、幂等就万事大吉,其实还差两道更细的保险。第一道是给重试设并发帽:全局同时发起的重试到一个上限就停,防止"赔了本又想翻本"从而叠加成第二波洪峰。第二道是给重试设总次数与总时间预算:不是无限"我以为还会号",而是定死"最多重试 3 次、最多拖 8 秒",超过就报错交给上游/人工。这两顶"帽子"的价值在于——重试本应只是"偶发抖动时的贴身护卫",戴了帽它才是保镖,不戴帽它反而成了把事故放大的"加害者"。
什么时候该用"超时"而不是"重试"
顺着重试再说一个常被搞反的方向:有些"失败",第一反应不该是重试,而是"设置合理超时"。 重试解决的是"这次运气不好,再试一次可能成";超时解决的是"我等不了那么久,到点就翻篇"。如果一个动作天然耗时可能很长(比如一个大数据量的导出任务),你给它设的就不该是"失败了就多试几次",而应该是"限个超时 + 异步/队列去跑"。反过来,如果全靠超时兜底而从不重试,那些"偶发闪断"又白白浪费。所以要分清:慢的操作靠超时与异步,闪的故障靠重试与退避——两者搭配,而不是把"重试"当成对所有失败都能撒的一把万能药。
舱壁落地:先把"必死"的调用隔离,再谈"快变量"
舱壁真正该优先隔离的,不是"可能会变慢"的服务,而是**"几乎必死或长期卡死的第三方/遗留调用"**。因为这种调用最擅长把连接池占住不还——它们不报错,只是不回,把整个线程池活活拖死。所以若你们有"某个旧系统调用经常掉了不回"的痛点,这就是舱壁最先救命的落点:单独给它一个带队列上限、带超时的隔离池,让它自己耗死在池里,别把主工作线程带走。这个"先救必死的,再善待可能慢的"的取舍,能让时间与人力花在刀刃上。
一块"重试+舱壁"该配在一起的现场
这两个机制最常见"只装一个"的小遗憾,其实它们该是一对搭档。试想下单场景:支付偶发闪断,重试把它救回来;但如果你同时用舱壁给支付单独划了一个有上限的池,那重试的并发就会被限制在池的容量内——舱壁防的是重试自己引发的风暴,两者叠加才最稳。
落地顺序也有讲究:先把"超时 + 舱壁"的基础打好(给每个下游独立资源池、设显式超时),再在"能确认失败是暂态的"前提下加带退避和幂等的重试。先有边界,再有自救——顺序反了,重试就会在缺乏约束时点火烧山。这一小节的收束是:容错不是"多装几个名牌",而是一套"超时/熔断/限流/舱壁/重试"各司其职、互相兜底的组织,缺了哪块,另一个都可能变成帮凶。
本节要点
- 重试只兜"偶发且可恢复"的失败,根本原因驱动的失败别重试
- 重试必须有退避 + 次数上限 + 幂等三件套,否则容易放大风暴
- 舱壁=按下游分独立资源池,池满快速失败
- 舱壁与熔断、限流叠加:熔断拦"坏了",限流挡"超载",舱壁管"隔离"
- 宁可一个下游快速失败,也别让它挤占资源拖垮全站