8.3 技术栈选型与云原生:出院装备与反模式
8.3 技术栈选型与云原生:出院装备与反模式
摘要:全册收尾,把前面的判断汇总成一套"出院装备":怎么给服务挑技术栈、云原生与 Serverless 什么时候该上、以及一堆高频反模式你怎么一眼认出绕开。这不是一份清单式答案,而是一套"面对新场景还会用"的判断框架。
前面每一章都在讲"怎么拆、怎么建、怎么养"。这一节把视野拉远,回答一个"出院之后一直会追问"的大问题:面对一个新的服务、一个新的业务,我手里的技术池应该怎么用,才不重蹈覆辙?
技术栈选型:不是选最新的,是选团队扛得动的
技术选型被拍脑袋的比例高得惊人——"听说这框架火,用!"。这里给一套不拍脑袋的办法,分三层判断:
- 团队有没有:这门技术团队是否有人熟、能不能招到人、出了坑能不能救。这是第一优先,没人能维护的技术等于给自己埋雷。
- 场景是否匹配:这门技术是不是解决当前这个服务真正的难点(并发、吞吐、一致性、生态)。拿一个冷启动都要几十秒的框架去扛"要低延迟"的服务,就是场景错配。
- 有没有长期背书:是否足够活跃、生态够不够、有没有被大厂验证。夕阳技术可能能跑,但你会被卡在人才和生态两头。
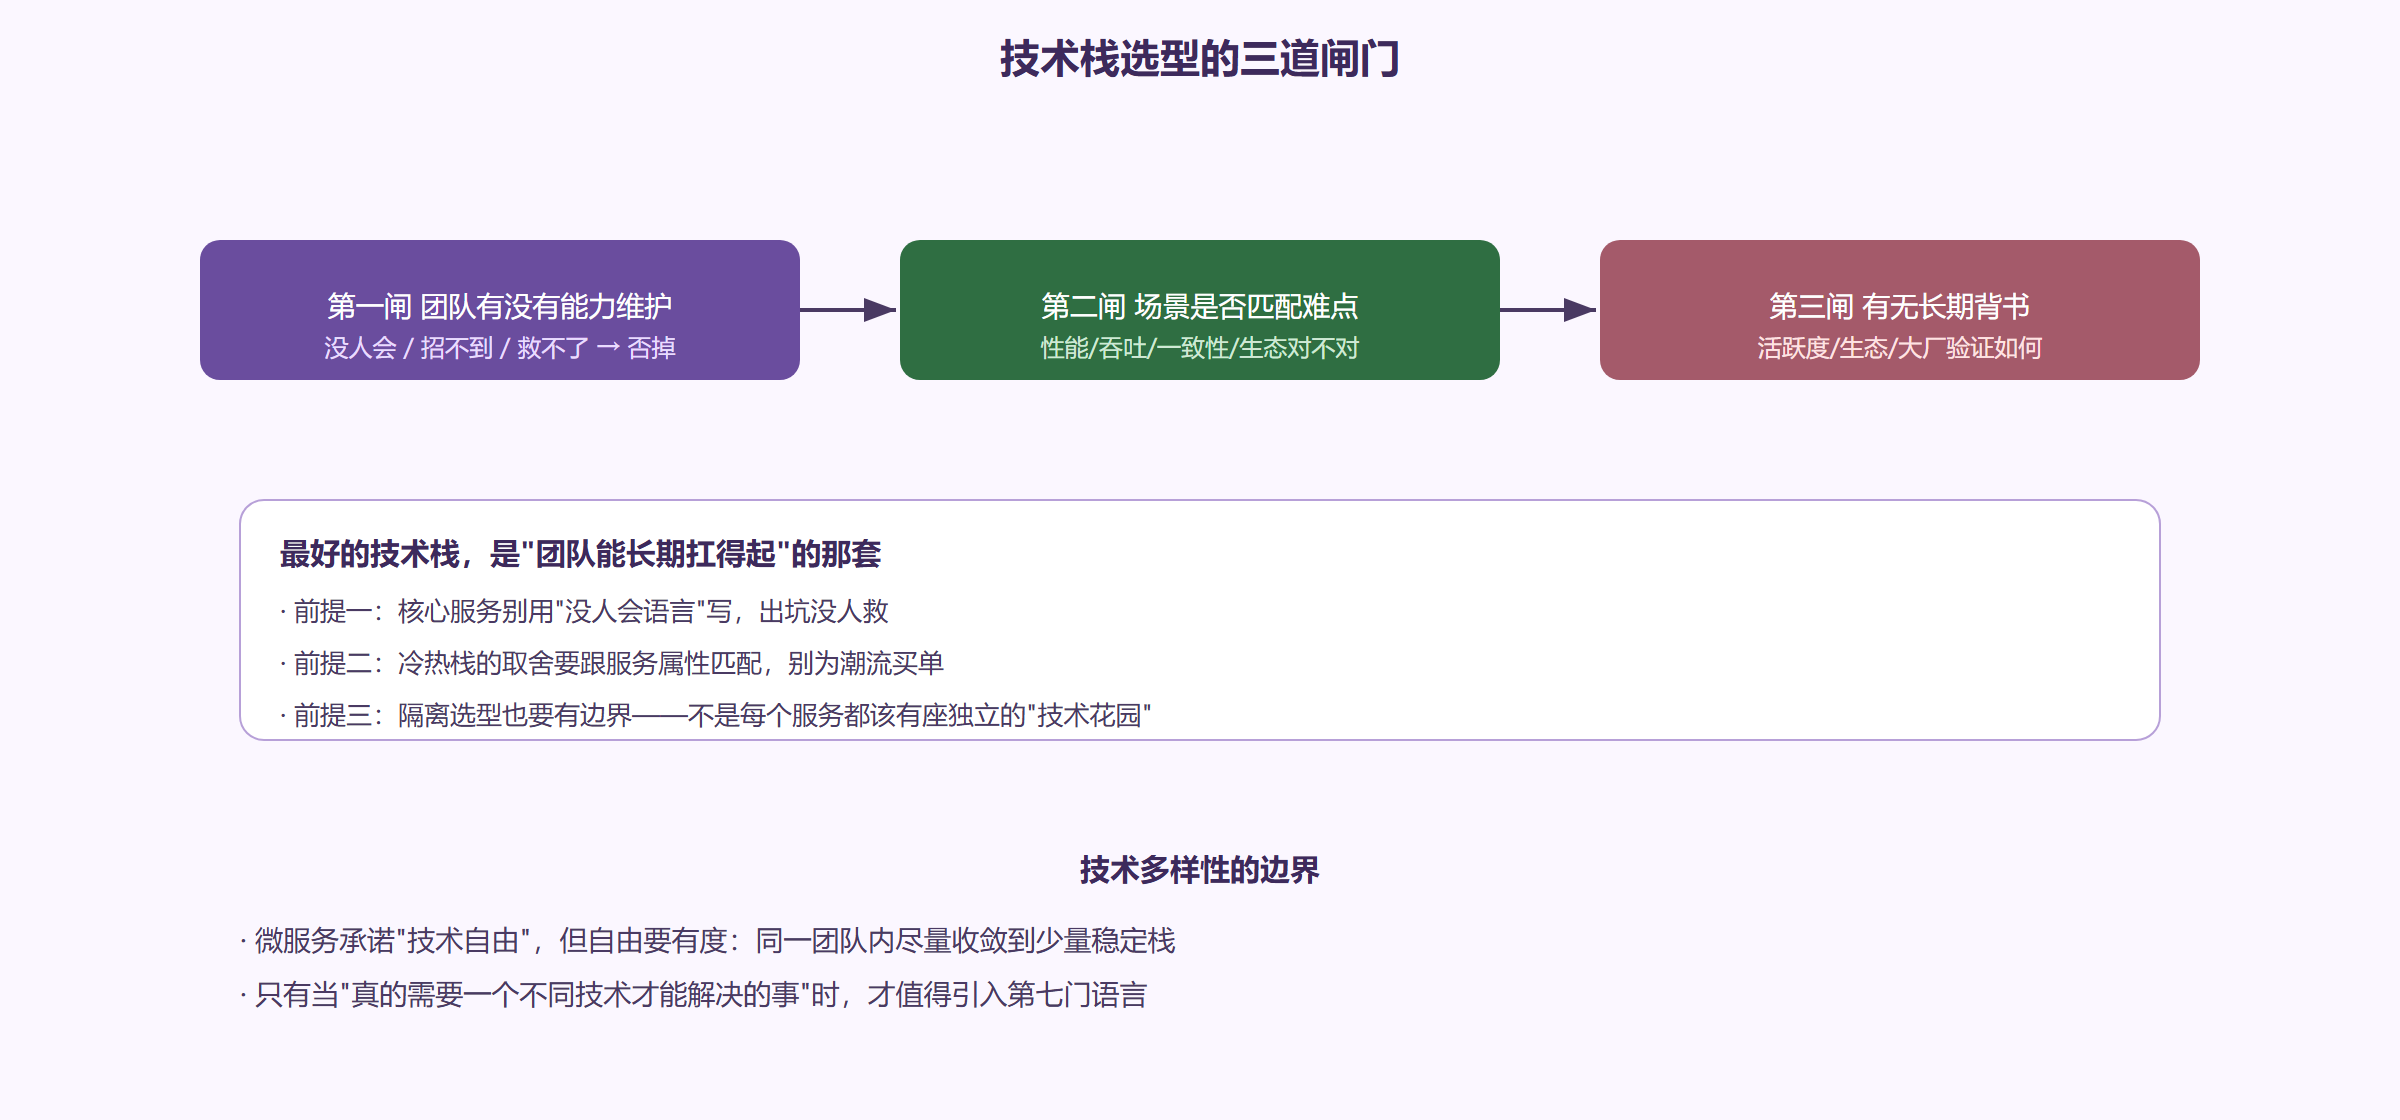
微服务确实该"技术自由",但自由的正确用法是有边界的收敛:同一个团队、同一个域内尽量用一致的少数技术栈,只在"某个服务真的需要不同技术才能更好"时才引入新成员。否则四面八方开花,最后是运维、招聘、人才三头受气。
云原生与 Serverless:更高阶的"手术刀",但不是每台手术都用
把话说到底:容器与编排(第 5 章)+ 服务网格 + 平台工程,合起来叫云原生,它把"我怎么养服务"进一步平台化、声明化,让开发者更专注业务。Serverless 是更高阶的一条路——连"服务器/实例"这个心智都省了,函数按事件触发、按调用计费,冷启动换免运维。
它俩该什么时候上?判断只有一条:你的团队是否已承担得起那份抽象的成本。
| 形态 | 心智负担 | 适合 | 代价 |
|---|---|---|---|
| 单体优先 | 最低 | 中小系统、起步 | 老了要拆 |
| 容器+编排 | 中 | 多数微服务团队 | 平台门槛高 |
| Serverless | 低(免运维) | 事件触发、峰值无规律、函数化 | 冷启动/厂商绑定/调试难 |
务实建议:Serverless 挑"真正事件化、峰值无规律、无状态"的环节用(比如回调处理、图片转码、消息消费),核心强一致业务还是放有状态的普通服务上让团队掌控。别为了"最潮"把核心链路整个丢进无服务器,冷启动和绑定风险会反过来咬你。
一眼认出高频反模式
收尾时给你一张"反模式识别卡",这些形态一出现就该警惕:
- 分布式的巨型单体:叫微服务,实则服务间大量调用、共享数据、互相约等于一个大后端。
- 切得太碎的迷你服务:每个服务就几行,全是网络开销、没有边界收益。
- 共享库/共享表复辟:所有服务都在写同一张库,等于把耦合从代码搬到了数据层。
- 门卫式网关:网关里塞满业务逻辑,成了一个谁都动不了的"神话级单体"。
- 没有可观测性的发布:改完上线没有指标可看,全靠烧纸——回归到蒙眼开车。
认出反模式不是为了批评,是为了在它刚露头时就动手——哪怕只是给团队写一句"这里不对劲,下次改进提案"。反模式之所以反复出现,正因为修它需要纪律。
收尾的一句话
技术栈、云原生、反模式,讲到底都指向同一个判断:技术是手段,健康是可运维、敢演进、能长期活下去。当你面对下一个场景、下一个服务时,把全册这套"术前评估—画刀线—接通—供血—移植—抗排异—无菌—治理"的框架随身带上,你会越来越稳,也越来越少需要"拆了重来"。
一张"出院装备"检查表:把整册收尾成能复查的动作
收留这册时,与其记"微服务是什么"的知识点,不如把它收成一张动手就能对一遍的检查表。试着抄下来,遇到新系统或做定期体检时逐项过:
- 术前:有没有给这台系统做过"要不要拆、拆谁能降成本"的诊断,还是又凭感觉就动刀?
- 刀线:服务边界是否画在业务语义上,而不是技术分层上;每个服务是不是清楚"它管什么"?
- 通信:该同步的有没有超时与延迟预算,该异步的是不是真的不急着要结果?
- 数据:每份数据有没有唯一写主;跨服务的账,是不是用最终一致 + 对账在兜?
- 部署:发布是不是靠 CI/CD 自动走、能灰度能回滚;上线后有没有指标/日志/追踪可看?
- 韧性:熔断/限流/舱壁是不是按"入口、下游、资源"各自放对了位置,而不是装了没用?
- 安全:认证是否统一收口、服务间是否互认身份、权限是否最小化?
- 治理:接口有无兼容纪律、依赖有无升级节奏、架构有没有护栏再动刀?
一格一格打勾下来,你就能在"还在健康"和"开始烂"之间找到提前介入的那个点。这套检查表比任何一句"微服务该这样"的结论都更能体面地拦住退化——它把你前面读的所有章节,压缩成每天能用一次的冷静动作。
一个绕不过的现实成本:技术栈的"切换税"
选型时刻的直觉常常是"新比旧好、早换早省",但它漏算了一项几乎必被低估的成本——切换税。它由三块组成:团队里每个人重学这套栈的学习成本;老栈里正在跑、已经跑顺的代码与工具链的搬迁代价;以及最隐蔽的,老栈在线上被踩过的坑、沉淀下来的运维知识,换栈后这些经验全部清零。所以技术选型不该只在"新栈多强"上打转,还该盯着"从当前栈迁走的代价有多大"。务实的一条判断是:当你在两个栈之间犹豫时,如果新的是"好一点"、老的是"稳一点",多数时候留在原点是对的;只有当新栈能带来老栈给不了的量级级改善——比如并发吞吐翻数量级、能接住一个当前完全没法做的场景——才值得按下那个"搬"的开关。选型是概率题,而切换税往往把"新"的这一票,拉低得比你直觉预估的更狠。
本节要点
- 技术选型三闸门:团队扛不扛得住、场景对不对、有没有长期背书
- 技术自由要有边界的收敛,核心服务别用没人会的栈
- 云原生/Serverless 是更高阶的工具,按"代价是否可控"决定上不上
- 一眼认出分布式巨型单体、迷你服务、共享库复辟、门卫网关等反模式
- 反模式靠纪律在刚露头时修,别等它长成绕不开的大山