7.3 端到端与混沌工程:术前全演练
7.3 端到端与混沌工程:术前全演练
摘要:该有的单元、契约测试都装了,可"系统整体在流量和故障下到底行不行"只有真本事才能答。端到端测试验证"好日子"里的全链路正确,混沌工程则主动把故障注进去,验证"坏日子"里系统真能自愈。本文讲两者的定位、怎么做,以及它们怎么互补成一道完整防线。
上一节的测试金字塔解决了"正常功能对不对",这一节回答两种更硬的问法:一遍全流程走下来对不对(端到端),以及真出事了我能不能活下来(混沌工程)。前者测"祝它顺利能走通",后者测"祝它出事不怕"。
端到端测试:少而慢,但必须要有
端到端测试(E2E)模拟真实用户动作,从客户端一路打到后端各个服务再回来,验证一条完整业务链路在真实环境里对不对。它回答那个金字塔顶层的问题:全链路合在一起是对的吗?
它慢、贵、脆,所以铁律是:只覆盖最关键、最能代表用户价值的流程(下单、支付、登录这类),数量控制在能在一两小时内跑完的规模;能靠下层测试覆盖的,就别塞进 E2E。端到端是"最后一道确认",不是"日常护身符"。
混沌工程:不只是"捶系统",是验证自愈能力
比"能跑通"更狠的一问是"敢不敢出事"。混沌工程的做法就是在受控的前提下主动向系统注入故障(把支付服务搞慢、杀掉一个实例、让网络抖动几秒),然后看它到底能不能自愈、能不能保住核心业务。它验证的不是代码函数对不对,而是整台机器的"韧性"是否长得和你想象的一样。
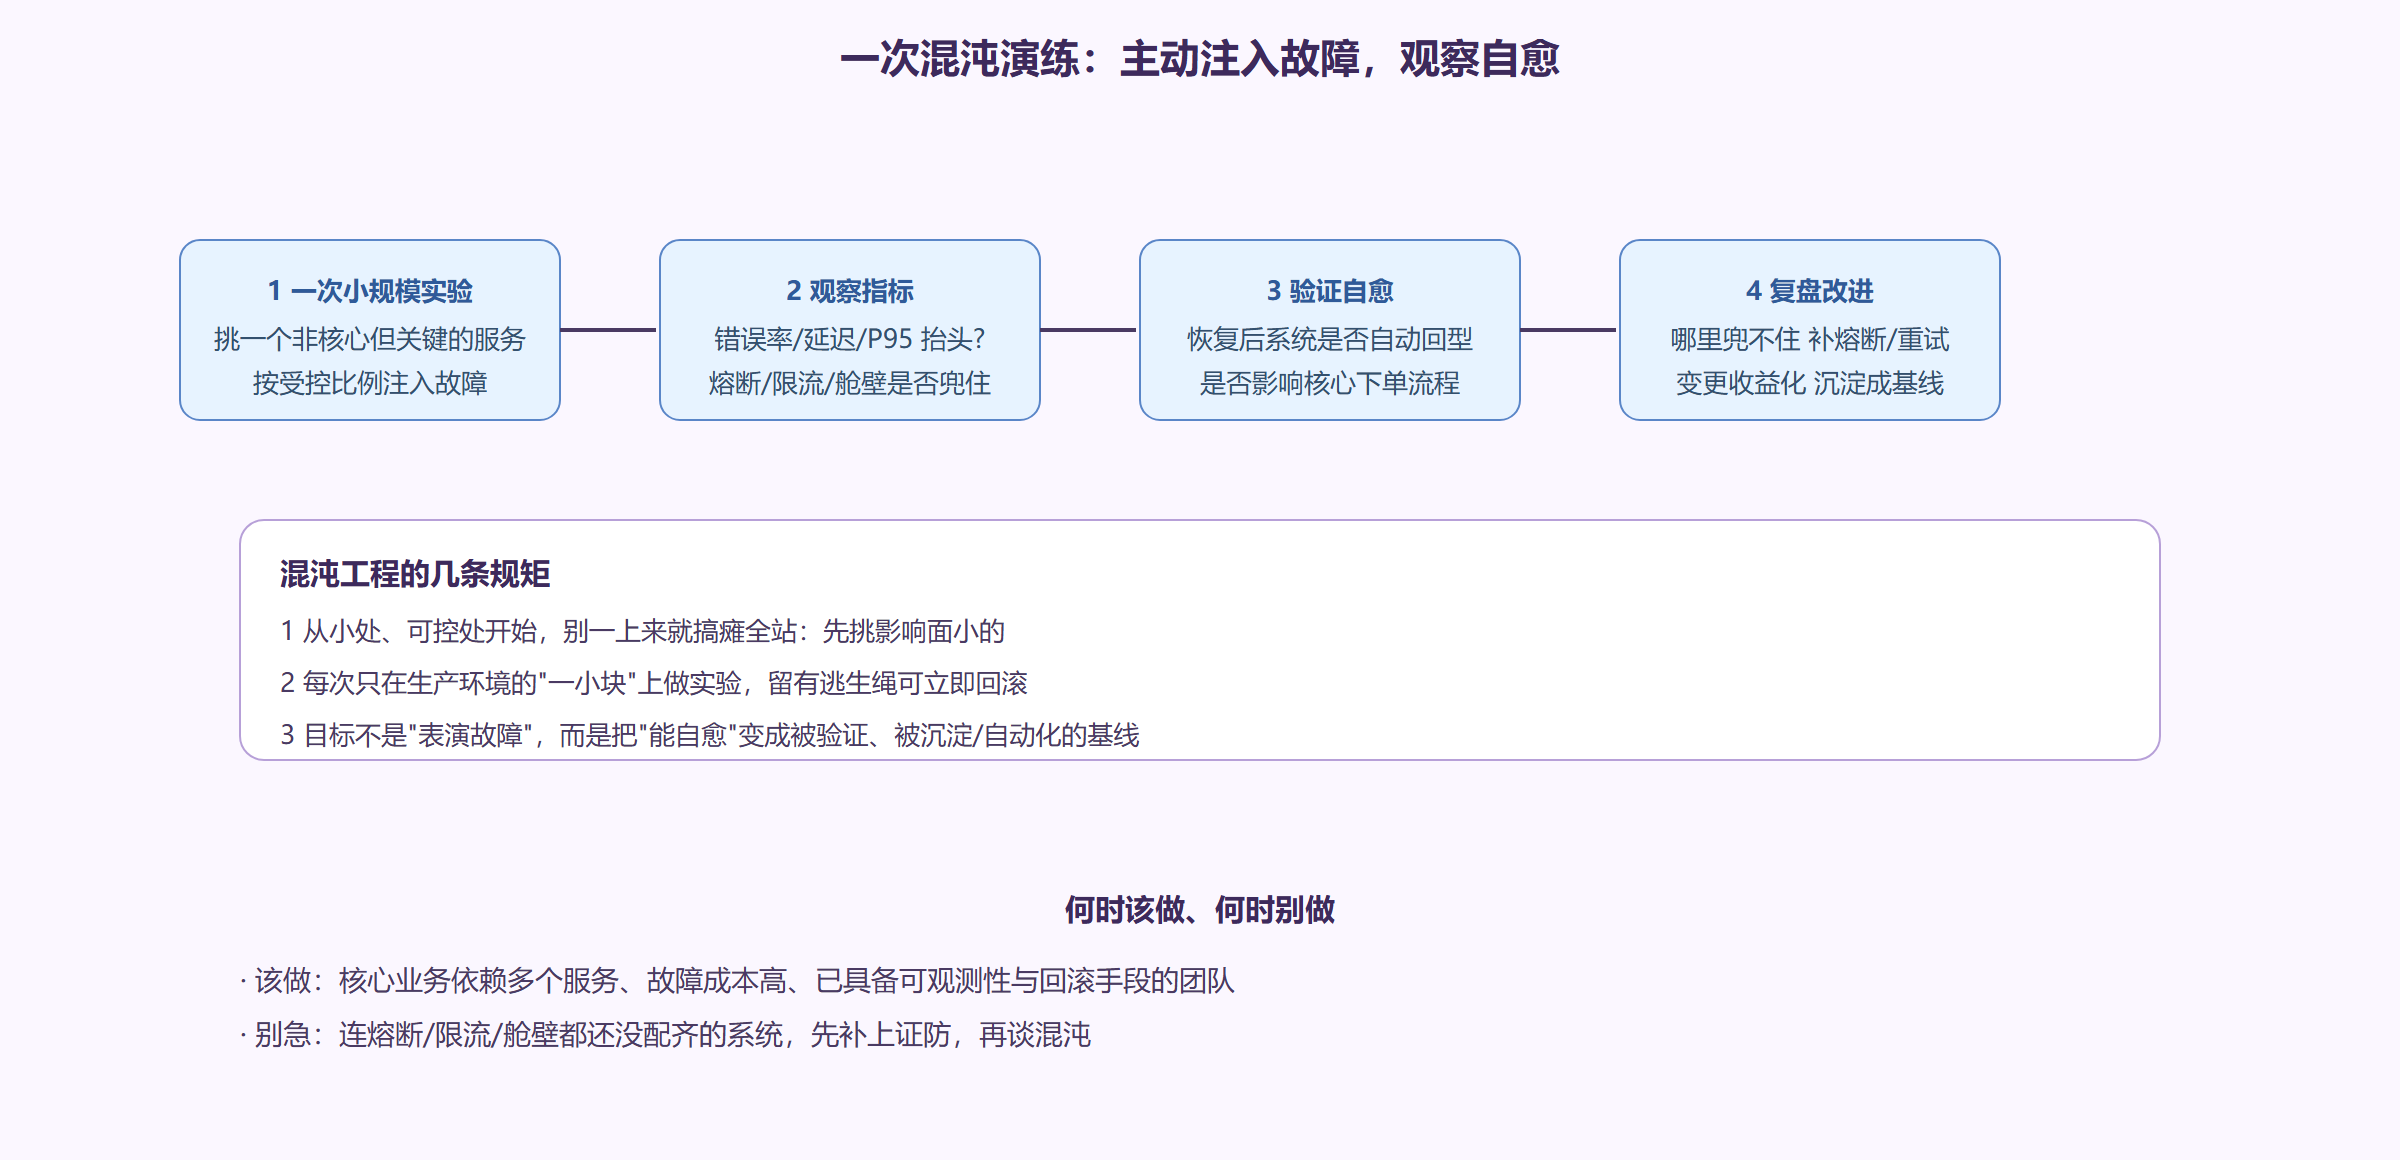
混沌工程不是"给系统没事找事",它背后是清醒的工程态度:故障必然发生,我要在我掌控它的时候先演练,而不是等它在最不该来的时候偷袭我。它像术前全演练——所有手术器械、应急通道、备份方案先走一遍,真刀真枪才心里有底。
两条防线怎么配合
把本节的两件事和上一节放一起看,它们正好互补:
- 测试(单元/集成/契约/端到端):验证"系统该做对的,都做对了"——正常路径的正确性。
- 混沌(注入故障):验证"系统出事时,该扛住的扛住了"——异常路径的韧性。
对普通团队而言,混沌工程的落地顺序是:先把端到端和契约这类"正确性门禁"装好,把熔断限流舱壁这些"韧性机制"配齐,再考虑用混沌去验证它们是不是真的有效。反过来,一个连自愈机制都没有的系统就上混沌,等于"打开炸弹保险给它剪一根线"——先有基础,再谈演练。网上一句话很有代表性:"你以为你的系统很健壮,直到你主动捅它一下。" 混沌工程,就是那"主动捅一下"。
陷阱:把混沌当成"测试有没有 bug"
混沌工程不该被拿来当功能测试用——它验证的永远是"韧性与自愈",而不负责"函数对不对"。跑混沌之前,先问"这个故障注入后我到底要观察什么、验证什么"。没有明确假设、只图"看它崩不崩"的混沌,是一种浪费,甚至会误伤线上。
混沌工程落地四步:从"小扰动"到"敢真捅"
混沌不是"一把抓起来乱捶",而是有纪律的四步:
- 小范围注入:先在测试/灰度环境、对一小撮请求或一个实例做扰动(把某服务延迟抬到 2 秒、随机杀一个 Pod),把"爆炸半径"一开始就框住,别一上来拿生产开刀。
- 观察指标:注入后盯关键指标是否有静——错误率要不要抬头、延迟有没有失控、熔断/限流有没有如约触发。
- 验证恢复:判断系统是被"韧性机制"接住了(如熔断打开、流量转向余下实例、副本自动补满),而不是靠运气躲过。
- 复盘沉淀:把"这次的故障有没有扛住、扛住靠的哪条机制"写进台账,变成下一个要补练的能力点。
这四步的价值是让"注入故障"从一个惊悚动作,变成一种可重复、可预期、能沉淀的日常演练。真正的成熟团队不是"没事捅一刀看热闹",而是"每次捅都有明确的假设、都留下验证结论",让韧性像肌肉一样被练出来。
一个实用提醒:混沌只对"有对手"的环境有意义
在没有任何复杂度的地方做混沌,只会得到"确认,确实没出事"这种安慰剂。只有当系统里真存在"需要担心的地方"——跨服务依赖、第三方调用、异步链路、异地多活——混沌才值得上。判断标准很简单:如果你们的系统小到不需要韧性机制,那也不需要混沌;需要混沌,恰恰说明你们已经复杂到值得用这套方法去守护。把混沌当成"复杂度到了一定规模后的体检",而不是"每个系统的标配切片",才不会被它吓到,也不至于滥用。
一个组织提醒:混沌工程要"专人负责 + 有节奏"
混沌工程最容易死掉的姿势不是"不敢做",而是"做了一两次,然后没人管、不了了之"。它天然是"短期看不到回报、长期才有价值"的事,所以没有组织支撑几乎必然被搁置。想让它在系统里长期活下来,至少给两件事打底:一是有明确的负责人/专项小组,他负责编排故障实验、维护实验台账、跟进每个"没扛住的故障"的修复;二是有固定的节奏,比如每月一次小范围演练、每季度一次完整的生产故障演练,让"验证韧性"成为一个持续的呼吸,而不是一次性的活动。
把混沌做进节奏,它的回报才兑现得了:每季度一次的演练结束后,你的团队会带着"这次谁扛住了、下次该补哪里"的明确结论回到工作中,韧性就这样被一格格顶上去。孤立的表演式混沌只能给截图用,成体系的混沌要把"注入—观察—验证—复盘—改进"闭环固定成常态,这正是"术前全演练"一词真正的份量。
本节要点
- 端到端测试验证"真实全链路对不对",慢而贵,只覆盖关键流程
- 混沌工程主动注入故障,验证"出事时能不能自愈"
- 混沌四步:小范围注入→观察指标→验证恢复→复盘沉淀
- 先配齐韧性机制再谈混沌,别把混沌当功能测试
- 测试管正确性,混沌管韧性,两者互补成完整防线