3.1 NLP 基础概念与文本表示
3.1 NLP 基础概念与文本表示
本节摘要:NLP 的第一道坎是把文本变成数字。本节从分词和文本预处理出发,讲文本表示的三代演进:One-Hot 和词袋(稀疏无语义)、Word2Vec/GloVe(稠密静态词向量)、上下文嵌入(BERT 动态词向量)。重点拆解 Word2Vec 的 CBOW 与 Skip-gram、负采样技术,让你理解"为什么 king - man + woman ≈ queen"这个神奇现象背后的数学。理解了词向量,你就理解了为什么 NLP 能被神经网络处理。
学习目标
阅读完本节,你应当能够:
- 说清中文分词和英文分词的差异,以及 BPE 子词分词为什么成为主流
- 对比 One-Hot、词袋、TF-IDF 的优缺点,指出它们的致命缺陷
- 讲清 Word2Vec 的 CBOW 和 Skip-gram 原理,以及负采样为何加速训练
- 解释为什么 Word2Vec 学到的向量能做语义类比(king - man + woman ≈ queen)
- 说清 GloVe 基于共现矩阵的思路,以及它和 Word2Vec 的区别
- 解释静态词向量(Word2Vec)和上下文词向量(BERT)的本质差异
- 设计一个文本分类任务的表示方案,说清选词向量还是上下文嵌入
让计算机读懂文字的第一步
计算机只懂数字,而语言是符号。这道鸿沟是 NLP 的根本难题——你怎么把"苹果"这两个字变成神经网络能处理的向量?
最早的尝试是 One-Hot:给每个词分配一个唯一的二进制向量,只有对应位置是 1,其它都是 0。这个方案直观但有两个致命缺陷。第一,维度灾难:词表有 10 万词,每个词就是 10 万维向量,极度稀疏浪费空间。第二,语义丢失:One-Hot 编码下,"苹果"和"橘子"的距离等于"苹果"和"汽车"的距离,模型完全看不到词与词的语义关系。
词袋模型和 TF-IDF 稍有改进——它们统计词频,但仍然把每个词当独立符号,没有语义。真正的突破是 Word2Vec(2013 年):它把每个词映射成一个几百维的稠密向量,而且这些向量在空间里捕获了语义关系——相似的词向量靠近,词向量之间的方向编码了语义关系。这件事的颠覆性在于:语言第一次变成了可计算的连续空间,所有深度学习技巧都能用上了。
所以本节的组织逻辑是:先讲文本预处理(分词、清洗),让你看到原始文本怎么变成词序列;再讲三代表示方法的演进,重点拆解 Word2Vec 的原理——它为什么能学到语义、负采样为什么必要、CBOW 和 Skip-gram 怎么选。
二、核心原理
2.1 文本预处理与分词
文本进入模型前要经过预处理。英文分词相对简单(按空格和标点切),中文需要专门分词工具(jieba、HanLP)。
子词分词(BPE、WordPiece)是大模型时代的主流。它介于"按词"和"按字符"之间:高频词保持完整,低频词拆成子词片段(如 "unfriendly" → "un" + "friendly")。好处是:解决未登录词问题(OOV)、共享子词的语义、词表大小可控。BERT 用 WordPiece,GPT 系列用 BPE。
| 分词方法 | 粒度 | 优点 | 缺点 |
|---|---|---|---|
| 按词 | 词级 | 语义完整 | 未登录词问题 |
| 按字符 | 字符级 | 无未登录词 | 序列太长,语义弱 |
| 子词(BPE) | 子词 | 平衡,无未登录词 | 实现稍复杂 |
2.2 第一代:One-Hot 与词袋
One-Hot 是最朴素的方案,前面已说其缺陷。
词袋模型(BoW) 把文档表示成词频向量,忽略词序。缺点是"我打你"和"你打我"的词袋表示完全一样,语义截然相反。
TF-IDF 在词袋基础上加权:词频(TF)高的词重要,但在所有文档都出现的词(IDF 低)不重要。它让"的、是"这类停用词权重降低,让有区分度的词权重升高。但 TF-IDF 仍然是符号化的,没有语义。
2.3 第二代:Word2Vec 与静态词向量
Word2Vec 的核心思想来自分布式假设:上下文相似的词,语义相似。它通过让模型预测上下文来学习词向量。
CBOW(连续词袋):用上下文词预测中心词。输入是上下文窗口里所有词的向量平均,输出是中心词。
Skip-gram(跳字模型):用中心词预测上下文词。输入是中心词向量,输出是窗口里的每个上下文词。
| 维度 | CBOW | Skip-gram |
|---|---|---|
| 预测方向 | 上下文 → 中心 | 中心 → 上下文 |
| 训练速度 | 快(一次预测) | 慢(多次预测) |
| 对低频词效果 | 较差 | 好 |
| 适用 | 大数据集 | 小数据集、关注低频词 |
负采样 是 Word2Vec 训练加速的关键技术。原始 Softmax 要对整个词表做归一化,词表大时极慢。负采样的思路是:把"预测中心词"转化为一个二分类问题——正样本是真实上下文,负样本是从词表随机采几个词。这样计算量从词表大小 O(V) 降到负样本数 O(k)(通常 k=5)。
为什么 Word2Vec 能学到语义类比? 因为训练时相似的词有相似的上下文,所以它们被推到向量空间相近的位置。更神奇的是,词向量之间的方向编码了语义关系:\vec{king} - \vec{man} + \vec{woman} \approx \vec{queen}。这是因为"国王-男人"和"女王-女人"这两对词的差异(性别维度)在向量空间里指向相似的方向。这种线性结构让词向量可以做语义推理。
# 词向量语义运算的简化演示 def analogy(model, word_a, word_b, word_c): # a - b + c = ? 如 king - man + woman = queen vec = model[word_a] - model[word_b] + model[word_c] # 找最相似的词 return model.similar_by_vector(vec, topn=1) # analogy("国王", "男人", "女人") -> "女王"
2.4 GloVe:基于共现矩阵的替代方案
GloVe(Global Vectors) 用不同思路学词向量:它统计整个语料里词对的共现频率,然后让词向量的点积等于共现频率的对数。Word2Vec 是"局部上下文预测",GloVe 是"全局共现统计"。两者效果相近,GloVe 训练更稳定(不依赖随机窗口采样)。
2.5 第三代:上下文嵌入
Word2Vec 和 GloVe 的共同缺陷是静态——同一个词在不同语境下向量完全一样。但语言里一词多义很常见:"苹果"在"我吃苹果"和"苹果发布新手机"里语义完全不同。
ELMo 是早期尝试,用双向 LSTM 生成上下文相关的词向量。
BERT 把这件事做到了极致:每个词的向量是整个句子经过 Transformer 编码后的输出,自然带上了上下文信息。同一个"苹果"在不同句子里向量不同。
| 表示方法 | 类型 | 上下文感知 | 计算成本 |
|---|---|---|---|
| One-Hot/词袋 | 静态 | 否 | 低 |
| TF-IDF | 静态 | 否 | 低 |
| Word2Vec/GloVe | 静态 | 否 | 中(训练),低(推理) |
| ELMo | 动态 | 是 | 高 |
| BERT 嵌入 | 动态 | 是 | 高 |
三、工程实践要点
3.1 词向量 vs 上下文嵌入的选型
def select_representation(task, data_size, compute_budget): if data_size < 1000 or compute_budget == "low": return "Word2Vec 或 TF-IDF + 简单分类器" elif task in ["ner", "relation_extraction"]: return "BERT 嵌入 + CRF 或线性层" elif task == "text_classification" and data_size > 10000: return "BERT 微调" return "TF-IDF + SVM 作为 baseline"
💡 关键直觉:不是所有任务都需要 BERT。情感分析这种简单任务,TF-IDF + 逻辑回归可能就有 90% 准确率,上 BERT 只多一两个点但训练和推理成本翻几倍。工程选型要看投入产出比。
3.2 词向量的下游使用方式
拿到预训练词向量后,有三种用法:
| 用法 | 是否微调 | 适用 |
|---|---|---|
| 静态特征 | 否(冻结) | 数据极少,怕破坏 |
| 微调 | 是 | 数据中等,任务特定 |
| 从头训 | 不用预训练 | 数据极多,领域特殊 |
3.3 处理未登录词
Word2Vec 时代未登录词(OOV)是大问题,常见对策:
- 用字符级向量组合(char-CNN、char-RNN)
- 用子词信息(FastText 把词拆成 n-gram)
- 直接给 OOV 分配随机向量
- 用上下文嵌入(BERT 子词分词天然解决)
⚠️ 常见坑:Word2Vec 微调时要小心"灾难性遗忘"——在自己的小数据上微调预训练向量,可能把在大语料学到的通用语义破坏掉。对策是用很小的学习率,或只微调部分维度。
3.4 中文 NLP 的特殊处理
中文 NLP 比英文多几个坑:
- 分词歧义("结婚的和尚未结婚的"切分不同)
- 实体识别依赖分词质量
- 繁简转换、全半角统一
- 标点符号规范(中文标点 vs 英文标点)
工程上建议:直接用字级别表示(不做分词),配合 BERT/RoBERTa-Chinese,避免分词错误传播。
本节要点回顾
- 子词分词(BPE/WordPiece)是大模型主流,解决未登录词问题,BERT 用 WordPiece、GPT 用 BPE。
- One-Hot 和词袋的致命缺陷是无语义,TF-IDF 加权仍符号化。
- Word2Vec 基于分布式假设:CBOW 上下文预测中心、Skip-gram 中心预测上下文,负采样把 Softmax 转二分类加速。
- 词向量能做语义类比因为相似词上下文相似,词间方向编码语义关系(king-man+woman≈queen)。
- GloVe 基于全局共现统计,效果与 Word2Vec 相近但更稳定。
- 静态词向量(Word2Vec)vs 动态(BERT):前者一词一向量、后者上下文相关解决多义词。
- 选型看投入产出比,简单任务 TF-IDF+SVM 够用,复杂语义任务才需要 BERT。
下一节进入序列模型,看 RNN/LSTM 如何处理变长序列,Transformer 如何用注意力并行化,以及它们如何驱动文本分类、NER、翻译等核心任务。
四、文本表示方法的分层图谱
把 NLP 的文本表示方法放到一张分层图里,面试时无论被问到哪一层,都能立刻定位它在整个体系里的位置,以及它上一层、下一层分别是什么。这种"结构化应答"比零散背诵高效得多。
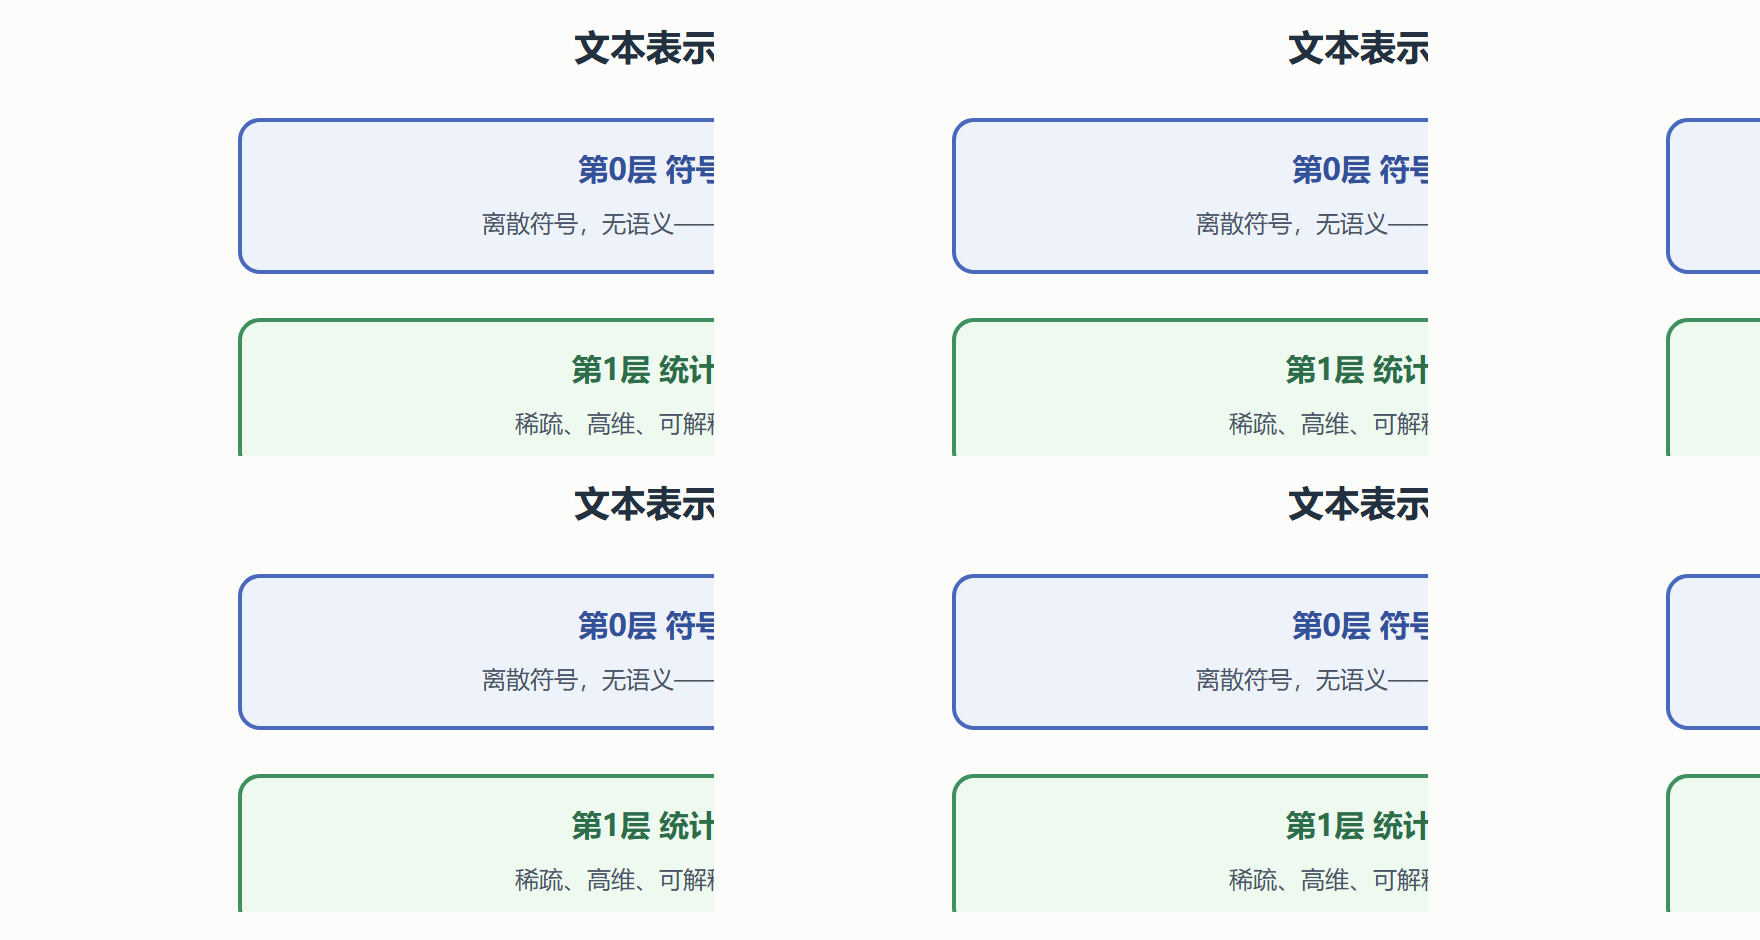
顺着这张图补几个跨层的高频追问。问"Word2Vec 为什么能学到语义",答"分布式假设:上下文相似的词语义相似,skip-gram 用中心词预测上下文,等价于对共现统计做隐式矩阵分解"。问"静态词向量的局限怎么补",除了"上下文表示",还有一个工程向答案:FastText 用子词 n-gram 缓解未登录词问题,对形态丰富的语言和拼写错误鲁棒。问"TF-IDF 现在还有用吗",有——它是零成本基线,也是面试官检验你"是否盲目追新"的试纸:新方法要在基线之上证明增量,而不是替代常识。
准备建议:每层挑一个代表方法,把它的"动机—机制—失效场景"写成三句话卡片。四层十六句话,就能覆盖文本表示这一考点的绝大多数追问。
五、分词与中文处理的特有难题
英文有天然空格,中文的分词是绕不开的前置工序,也是中文 NLP 面试的保留曲目。核心矛盾是歧义切分:"结婚的和尚未结婚的"可以切成"结婚/的/和/尚未/结婚/的",也可以被错误地切成"和尚/未结婚"。主流方案三代:基于词典的最大匹配(快但无法处理未登录词和歧义)、统计模型(隐马尔可夫加维特比、条件随机场,把分词建模为字符级序列标注)、以及现代做法——直接用基于字符的预训练模型或让大模型按需切分,BERT 类模型在中文里通常按字输入,把分词的负担转移到模型的字符表示能力上。
这里有个值得展开的判断:分词曾被视为中文 NLP 的地基,现在它在很多管线里的地位在下降。原因不是问题解决了,而是字符级的上下文表示足够强,词边界的信息模型自己学得更好。但分词没有死:搜索领域的倒排索引仍然依赖高质量分词(索引词的质量直接决定召回),法律医疗等领域术语的词典维护也是现实工程。面试时被问"中文分词现状",能同时讲清"字符模型崛起"和"工程场景里词典法依然稳固"两面,是高级感的来源。
问:jieba 分词的原理是什么,为什么它还能打?
jieba 的主体是前缀词典加动态规划找最大概率路径(基于语料统计的词频),未登录词用隐马尔可夫模型按字标注识别。它能打的原因是工程折中做得好:纯 Python 无重依赖、词典可插拔、速度对大多数场景够用。追问常在"加载自定义词典后概率怎么融合"——答词频以自定义词典优先、路径概率按新词表重算。
六、从词到文档:表示的组装
词级表示最终要组装成文档级表示才能服务分类、检索、聚类。三代组装方式:词袋平均(TF-IDF 加权平均词向量,简单基线)、池化(深度模型对词向量序列做最大池化或平均,早期句向量的主流)、编码器池化(对 BERT 输出做平均池化或取 CLS 位,取 CLS 在微调后有效、无微调时平均池化更稳,这是实践中的高频细节)。最新趋势是句向量专用模型(对比学习训练,相似度直接用余弦),它解决了 BERT 原生向量相似度与语义相似度不对齐的问题。组装层看似薄,却是从模型到业务的关键胶水,面试里"CLS 还是平均池化"这个问题区分的是有没有真跑过。
至此,文本表示从符号到语义的四层已经走完。下一节把镜头转向模型,看这些表示如何被经典和现代的 NLP 模型消费掉。